IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
099| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:passAstra裁决:accept_kimi(revise)
Kanji (Morphogram) and Kana (Phonogram) Problem in Japanese Alexia and Agraphia
Sakurai · Frontiers of Neurology and Neuroscience · 2019 · Zotero itemID=1036
这是收录于 Karger《A History of Neuropsychology》卷中的一章,作者樱井靖久是日本神经心理学的资深临床研究者。文章系统梳理了"汉字—假名问题"(kanji-kana problem)一个多世纪的病历史:日语同时使用语素文字(morphogram)的汉字与音位文字(phonogram)的假名,脑损伤患者可以在两套文字上表现出选择性读写障碍,这种分离自 1893 年首个病例起就是日本失语学的中心议题。本文的价值在于把病灶—症状分析与功能成像的证据整合成一套解剖上细分、且有明确病灶定位的读写障碍分类表,并给出作者自己修正后的读与写双通路假说。
研究背景
日语的书写系统由两套符号并行构成。汉字借形于中国文字,有音读(来自汉语发音,表达语音值)与训读(日式读法,与意义绑定)之分,单个汉字本身就是一个带固有意义的词,二字汉字词远多于三字以上者。假名是日语的表音文字,相当于罗马字母,由 46 个辅元组合一致的字符构成,又分平假名(草书体,用于语法词素)与片假名(方块体,主要用于外来词)——两者音值相同、形态上 10/46 相似,可视为同一字母系统的两种写法(allograph,同形异体)。正是这种独特结构,使日本患者的失读/失写表现出汉字与假名之间的选择性分离:有人读写汉字更差,有人读写假名更差。"汉字—假名问题"由此成为天然的文字加工病灶实验场——它向西方认知心理学反复提出的问题是:形与音在阅读系统中是否走不同的路、是否有不同的大脑基质。
历史部分交代了争议的起点。1893 年 Watanabe 报告一名进行性延髓麻痹伴肌肉萎缩的患者,能写一些汉字词却写不出其假名转写,表现为假名音位错写(phonemic paragraphia)——以现代眼光看这是一例额颞叶痴呆合并运动神经元病型患者,而假名音位错写后来被确认为额叶纯粹失写的特征。Miura(1901)在 Broca 失语患者中看到假名读写更差,主张假名只是语音符号、汉字兼有形与义;Asayama(1914)以德文报告选择性假名失读与失写,第一次把这个分离介绍到世界;Imura(1943)描述的 Gogi(词义)失语——相当于西方的语义性痴呆——则展现相反的分离:汉字读写选择性受损而假名保留。Paradis 等(1985)复习 1901–1983 年的 69 例日本失读与失写,其中 20 例能读汉字不能读假名、16 例能读假名不能读汉字,"两套文字是否有不同神经基质"由此成为悬而未决的问题。战后的缺口在于:CT 与 MRI 普及后的病灶—症状研究虽然累积(如 Sasanuma 对 378 例康复中心患者的 17 项读写测验系列研究:Broca、Wernicke、传导性失语以假名损伤为主,混合型经皮层失语以汉字损伤为主),但 Sugishita 等(1992)用 46 个单字的汉字/假名阅读测验检验 50 例患者,批评既往报告数据不可靠——多数患者两套文字的阅读均非选择性受损。反驳其结论的关键思路是:必须把每种失读更进一步细分为汉字损伤组与假名损伤组,再谈解剖定位。
研究思路
章节的组织本身就体现了作者的论证策略:以分离现象为线索,沿"临床病历 → 病灶定位 → 模型修正 → 功能成像佐证"的顺序逐步收窄。先展示两套文字的结构差异如何天然产生类别可分的读写缺损(读:假名近似字母、汉字近似真词;写:假名是辅元音序列、汉字富于笔画正字法特征),再逐个报告关键病例的病灶部位,把 Yamadori 的角回型失读加失写(假名读难)与 Iwata 的后下颞皮层型失读加失写(汉字读写难)这对镜像病例并置,从而导出读写的双通路假说;最后用正电子发射断层扫描(PET)与功能性磁共振成像(fMRI)在健康人身上验证通路中每个节点的双重分离——同一解剖区在损伤后与激活时的行为效应互为印证。写作(失写)一侧的模型由作者自己的分组病例提出,给它分配与阅读侧对称的两条通路。全文由此把一个世纪以来"哪个脑区让汉字垮掉、哪个让假名垮掉"的散乱病例,整理成一张带解剖坐标与分离方向的分类表(表 2)。
方法
作为历史性综述章节,本文没有新的实验数据,其"方法"是病灶—症状映射(lesion-to-symptom analysis)与功能成像证据的系统综合。所依据的核心临床材料包括:Sasanuma 的 378 例测验系列与 46 单字读写测验(Sugishita 组 50 例)、Yamadori 角回动脉区域损害病例、Iwata 的后下颞皮层(posterior inferior temporal cortex, PITC;Brodmann 区 37)失读加失写病例、Soma 等 3 例由 PITC 病灶转化为汉字纯粹失写的追踪、将方法段的“Sakurai 等的 6 例假名纯粹失写(含 2 例先前报告者)”替换为“Sakurai 等的 6 例假名纯粹失读(含 2 例先前报告者)”。与后中颞回汉字纯粹失写病例、胼胝体压部切断与压部后部病灶患者的左/右视野阅读测试等。病灶定位以 CT/MRI 为主并与 PET、fMRI 激活区比对;PET 系列按阅读汉字词、假名词、假名非词分组做 ROI 分析,后改用统计参数映射(SPM)。分析要点是把病灶重叠区与健康人激活区(如内隐读假名词时的激活)交叉对照来确定"责任病灶"(responsible lesion),并区分相邻但功能不同的皮层部位(如中枕回与角回、海马旁回与梭状回中部)。
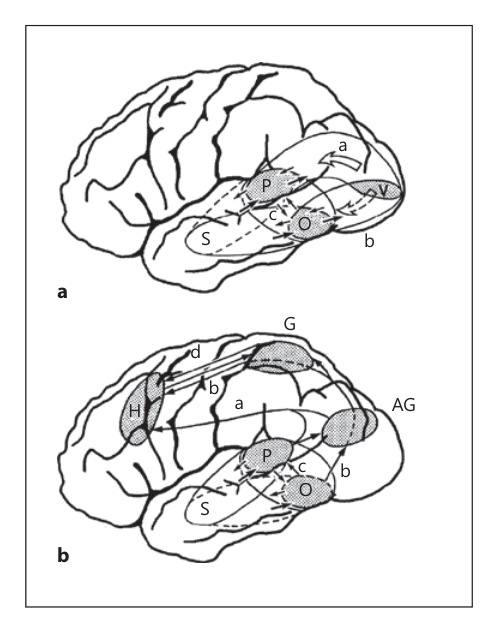
方法层面需要交代两组模型概念。阅读的加权双通路假说(图2a)认为:腹侧止于正字法词典(orthographic lexicon,即视觉词形区 VWFA,位于中梭状回/后下颞回,BA 37)支持整词的整体视觉识别;背侧经外侧枕回—缘上沟深部颞顶区(BA 40/22)至 Wernicke 区支持逐字符序列识别与音位转写;假名非词需要两条通路,真词阅读随熟悉程度偏向腹侧("加权"之意);汉字只走正字法通路,假名两条路皆可。写的双通路假说(图2b)认为:语音通路经弓状束把音系序列送往额叶手运动区,正字法通路从后下颞皮层向上经角回下方与顶上小叶抵达手运动区并分出字素区(graphemic area,储存视动与序列运动印迹);语音通路中断导致音位错写(假名词更受累),正字法通路中断导致字形回忆受损(汉字更受累)。
主要结果
- 第一个真正把汉字读写从假名读写分离出来的解剖定位,来自 Iwata 的镜像病例(图1):Yamadori(1975)的角回区病灶患者读假名词困难、读汉字词轻松;Iwata(1984、1986)报告的患者则恰好相反,不能读写汉字而假名读写保留——这是首例后下颞皮层(PITC,BA 37)病灶所致的汉字失读加失写。据此 Iwata 提出日语读写的双通路假说:从视觉皮层到 Wernicke 区有经角回的背侧路与经 PITC 的腹侧路,背侧主司假名阅读的语音加工,腹侧为汉字阅读的语义加工所必需;此后模型将角回替换为外侧枕回。
- 阅读的功能成像证据支持"加权双通路"(图2a,PET 系列):汉字词特异性激活中梭状回/后下颞回(BA 37),假名词特异性激活后梭状回/中与下枕回(BA 18/19);假名非词比假名词激活更广的双侧枕叶与枕颞皮层;假名词与非词共同激活中枕回及外侧裂深部颞顶区(BA 40/22);从假名词中减去汉字词呈现中枕回激活,反向相减则无激活。汉字词激活的 PITC 即所谓视觉词形区(visual word form area, VWFA);该区在汉字书写与回忆时与顶内沟、后中下额回共同激活,而假名字符书写时并不激活(fMRI)。
- 读写障碍可按解剖部位细分为类型,且分离方向互不重叠(表2)。纯粹失写:后中颞回病灶(BA 21/37)引起汉字纯粹失写、即字形回忆受损,对应西方的词汇性失写(lexical agraphia),其病灶位于 VWFA 上后方、比汉字失读加失写的病灶更靠背侧且更靠外侧;额叶纯粹失写(后中下额回,近 Exner 区)表现为假名音位错写为多,也有汉字失写;角回(BA 39)、顶上小叶/顶内沟(BA 7)病灶汉字失写更重,缘上回(BA 40)病灶假名失写更重。
- 纯粹失读分 letters 型与 words 型。假名纯粹失读(Sakurai 等 6 例)的标志是假名单字与非词阅读受损而假名真词相对保留,共同病灶在后梭状回/下枕回(BA 19),位于 VWFA 之后、即正字法或语音通路的更早阶段——由于假名相当于罗马字母,可更一般地称为"字母纯粹失读";汉字(词)纯粹失读则以汉字阅读明显受损、假名阅读相对保留为特征,病灶在左中梭状回、PITC/VWFA 内侧,来自视觉皮层到 VWFA 的信息无法进入或被断开——因汉字兼有音与义,可更一般地称为"词纯粹失读"。作者同时承认:汉字为主的纯粹失读虽有过报告,确定责任病灶的研究仍很少,需要进一步证据。
- 角回失读加失写的失读成分其实归因于中枕回;字形选择障碍(同形异体失写)以平假名/片假名混写的形式出现;失用性失写在日本患者中出现笔画顺序紊乱,且比欧洲病例更突出(汉字笔画序列更复杂)。右半球作用方面:压部切断患者短时程呈现时左视野的字(汉字与假名)都不能读、右视野皆可读,否定了"汉字归右半球、假名归左半球"的旧说;但压部切断者恢复的是汉字阅读而假名不能,压部后部病灶者左视野假名读写受损而汉字相对保留——提示右半球 BA 37 与 19 储存部分正字法信息、可代偿左半球功能障碍。
图注解读
图 1 · Iwata 的读写双通路假说
原文图注:Fig. 1. Iwata's dual-route hypothesis of reading and writing (reproduced with permission from Iwata [13]). A, Wernicke's area; AG, angular gyrus; S, somatosensory area; T, posterior inferior temporal area; V, visual area.
图上标出五个解剖点:视觉区 V、Wernicke 区 A、角回 AG、躯体感觉区 S 与后下颞区 T,文字(字素)信息从 V 出发分成两条路径投向语言区:经 AG 的背侧路与经 T(PITC)的腹侧路。读这张图要抓住它最初想解释的两个镜像病例——角回受损者假名读难、后下颞受损者汉字读写难——将“于是背侧路对应急于假名的语音加工、腹侧路对应急于汉字的语义加工”替换为“于是背侧路对应假名的语音加工、腹侧路对应汉字的语义加工”。。这是全文历史叙述的枢纽:后续所有作者(包括 Sakurai 本人的加权版本,图2)都是在给这张图改标号、加权重。它支撑主要结果 1 与结果 2 的病灶—激活对应。
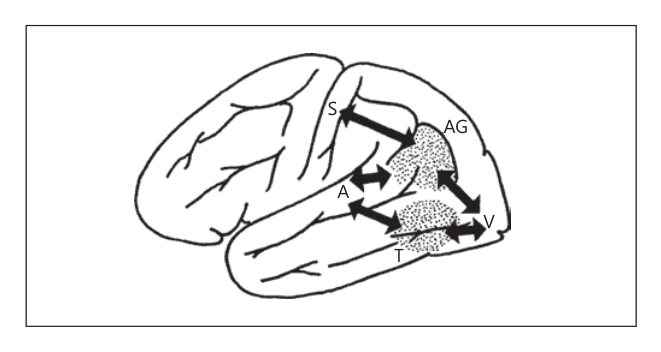
图 2 · 加权阅读双通路(a)与书写双通路(b)
原文图注:Fig. 2. Weighted dual-route hypothesis for reading (a) and dual-route hypothesis for writing (b; Reproduced with permission from Sakurai [37]). a The phonological (dorsal) route (a) proceeds from the primary visual cortex (V) to the posterior superior temporal gyrus (P; Wernicke's area) via the lateral occipital gyri (middle and inferior occipital gyri) and deep perisylvian temporoparietal cortex. This route is used for the sequential visual recognition of character sequences. The phonological lexical information (P) is stored around the end of this route. The orthographic (ventral) route (b) proceeds from the primary visual cortex (V) to the inferior temporal gyrus via the fusiform gyrus. This route is used for the holistic visual recognition of words, and plays a dominant role in reading. The orthographic lexical in- formation (O) is stored around the end of this route. a, dorsal (phonological) route; b, ventral (orthographic) route; c, interaction between P and O; O, orthographic lexicon (visual word form area); P, phonological lexicon; S, semantic storage; V, visual cortex. b The phonological route (a) proceeds from the primary auditory cortex (Heschl's gyri) and the posterior superior temporal gyrus (P; Wernicke's area) to the angular (AG) and supramarginal gyri and joins the arcuate fasciculus to travel to the frontal motor and premotor hand area (H). This route is used for the transmission of phonological information via the arcuate fasciculus or phoneme-to-grapheme conversion at the angular/lateral occipital gyri. The orthographic route (b) goes from the posterior inferior temporal cortex and proceeds upward under the angular gyrus and superior parietal lobule to travel to the frontal motor and premotor hand area (H). The orthographic route is divided into direct and indirect pathways in the parietal lobe. The direct pathway conveys holistic visual information on words and letters to the frontal motor and premotor hand area (H), whereas the indirect pathway enters the graphemic area (G) where visuokinesthetic and sequential motor engrams for words and letters are stored, and goes further to the hand area. a, phonological route; b, orthographic route; c, interaction between P and O; d, interaction between G and H; AG, angular/lateral occipital gyri; G, graphemic area; H, hand area; O, orthographic lexicon; P, phonological lexicon; S, semantic storage.
a 幅是阅读模型:路 a(背侧语音路)从 V 经外侧枕回与外侧裂深部颞顶皮质到 P(Wernicke 区),负责逐字符的序列识别;路 b(腹侧正字法路)从 V 经梭状回到下颞回,负责整词的整体识别、在真词阅读中占主导;O(正字法词典,即 VWFA)与 P(语音词典)在末端,c 表示两者的交互。b 幅是书写模型:语音路 a 从 Heschl 回与 P 经 AG/缘上回并入弓状束抵达额叶手运动区 H;正字法路 b 从后下颞皮层向上经角回下方与顶上小叶到 H,并在顶叶分成直接路与间接路(后者经字素区 G、视动序列印迹再出手)。读图时注意两幅的分工对接了主要结果 2 与 3:阅读中"汉字只走红(腹侧正字法)路、假名两条路都走",书写中"语音路断→假名错写、正字法路断→汉字回忆受损"。图注本身即是对两个模型的完整描述,值得逐条对着表 2 的解剖条目核对。
讨论
作者的讨论以"分类即诊断"的方式展开。他强调汉字—假名分离不是全或无的现象,而是随病灶亚位置系统性变化的:同为 BA 37 范围附近的损伤,发生在(中)梭状回的 VWFA 本体引起汉字失读加失写并常伴命名障碍(作者更早的病例研究显示命名障碍的严重程度与汉字阅读平行),发生在其背上方的外侧后中颞回则造成不伴失读的汉字纯粹失写——"病灶几乎相同、症状不同取决于精细定位"是全章反复出现的方法论结论,也是对只用群体统计的阅读脑研究的一个提醒。模型层面,作者承认自己的加权双通路假说是对 Iwata 模型的修正与推广:把组织原则从"日语特有"改成适用于一般语言的形—音权衡,正字法词典(VWFA)对应西方的 irregular/regular 词分离。与既往文献的对话很清晰:Sugishita 等(1992)"汉字与假名阅读普遍非选择性受损"的批评被细分策略化解;西方 2004 年后才报告的 irregular 词失读加失写伴命名障碍(Rapcsak 与 Beeson),在日语研究里早有约二十年的临床经验与之呼应。局限方面,作者对汉字为主纯粹失读的病灶定位明确表示证据不足;右半球在汉字识别中的代偿作用仍属提示性推断;此外,本章为历史卷内综述,未给出新的神经影像数据,PET 结果也部分依赖组间减法设计这种今天看来相对粗糙的手段。文中亦未详述各类型在损害量级上的定量差异。
一句话总结
以我的理解,这章的核心命题是:日语把"形与音的分离"天然内置在文字系统里,于是它成了检验阅读双通路假说的最好语言标本——汉字本质上近似"有意义的词",假名近似"字母串",两者的失读/失写在解剖上竟然各自沿着腹侧正字法流与顶端序列流分层分布。对做视觉词汇加工的读者,最有实用价值的是那张分类表:它是把临床上纷杂的失读失写世界观收敛到几个可验证的病灶坐标上的一次尝试。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A] - Fig2: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 补充要点: Yamadori 本人后来复习更多角回型失读加失写病例后明确表示:数据仍不足以断定角回型失读加失写中假名阅读特异性受损——这一作者对镜像病例解读的自我保留意见在解读中被略去,而它恰是全文'病灶需进一步细分'方法论立场的重要伏笔。
- 补充要点: Kawamura(1990)的三组对照比较(顶叶纯粹失写 6 例、角回失读加失写 2 例、PITC 失读加失写 4 例)是连接个案与分类表的关键中间证据(发现顶叶纯粹失写选择性损伤汉字书写、角回型以假名失读+汉字失写为特征),解读未提及。
- 补充要点: 表 1(英文词类与日语假名/汉字词类的对应关系:规则非词↔假名非词、不规则词↔例外读音汉字词)是理解作者把'汉字≈真词/不规则词、假名≈字母串'映射到西方阅读理论的关键桥梁,解读仅在行文中隐含,未点明其对应结构。