IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
344| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:passAstra裁决:accept_kimi(revise)
Predictor Construction Can Reverse Multimodal Neural Contrasts
Nadolskis · arXiv 预印本(q-bio.NC,期刊字段未注明) · 2026 · Zotero itemID=22476
这篇文章做了一件方法学上相当"拆台"的事:在用嵌套编码模型(encoding model)比较问"视觉特征在语言特征之外还多解释了多少"时,仅仅改变条件化语言预测器的构建方式,就能让这个多模态对比整个变号。作者用 Natural Scenes Dataset 的 fMRI 数据、DINOv2 视觉特征和 MPNet 语言嵌入证明:一条短 caption 对一条长 narrative 的对比偏向 narrative(+0.012/+0.015),而字数近似匹配后反转为偏向 caption(−0.031/−0.023),且这一位移横跨两名单被试的所有测量 ROI。它值得每个用"预测增益差"做表征推断的人精读,因为它把"预测器怎么造"从预处理细节提升为实验设计变量。
研究背景
基础模型(foundation model, FM)嵌入正日益被当作解读神经活动的特征空间:视觉模型的特征通过 model-to-brain 基准和编码分析与脑响应对比,语言模型特征则被用来预测乃至解码皮层活动。一个常见策略是嵌套对比——在已经包含特征空间 B 的编码模型上再加入特征空间 A,把预测精度的增益解读为"A 在 B 之外携带的信息"。这类推理被用来给脑基础模型打分,也被用来主张语言衍生特征在高阶视觉皮层解释了视觉特征之外的方差,是当前"大脑与语言模型对齐"叙事的重要支柱。
但这种解读有一个前提没被认真对待:被归到 A 名下的残差,不仅取决于 A 表征了什么,也取决于条件化预测器 B 本身把同样的响应解释到了什么程度。两个候选预测器完全可能在输入长度、词汇构成、标注者数量、冗余度、嵌入构建方式等与"表征区分"无关的性质上分出高下。探针(probe)文献里早有控制任务与针对性扰动来处理这类混淆,model-to-brain 研究也用定向扰动揭示哪些刺激性质真正支撑对应关系;但作者指出,这类控制很少被施加到多模态神经对比自身的解读上——这正是本文要补的缺口。
研究思路
设计逻辑非常克制:固定图像、fMRI 响应和视觉预测器,只改变语言预测器,观察"视觉的额外预测贡献"(additional predictive contribution of vision)如何随之变化。语言材料是同一批 NSD 图像的两种文本描述——MS COCO caption(平均 10.4 词,每图约 5 条独立撰写)与 Localized Narratives 叙述(平均 41.3 词,单标注者口语转录),二者天然带着约四倍的长度差。作者据此安排了三步递进:先呈现原始(未匹配长度)的 caption–narrative 对比;再用四条拼接 caption(41.7 词)对 narrative(41.3 词)做近似字数匹配,并把 narrative 截断到各图 caption 的长度(保留开头词的 Narrative-first 与保留中段连续片段的 Narrative-span)做逐图像匹配;最后把每个对比按恒等式分解为"联合预测变化"与"语言单项预测变化"两部分,并辅以内容词打乱(scramble)控制检验对比是否依赖图像特异的词汇内容。这条证据链回答的问题只有一个:嵌套对比的符号到底稳不稳。
方法
将方法开头改为:“数据来自 Natural Scenes Dataset(NSD)的两名深度采样人类被试(subj01/subj02),各观看 9,000 张独有图像及 1,000 张共享图像,每张重复呈现 3 次;本文未说明具体行为任务要求。”随后保留原有 fMRI 数据处理与 ROI 描述。,各观看 9,000 张独有图像加 1,000 张共享图像、每张 3 次;使用 1.8 mm 单试次 GLMdenoise beta 并跨重复取平均。ROI 包括 Places(OPA+PPA+RSC)、Faces(OFA+FFA-1/2)、Bodies(EBA+FBA-1/2)、单独分析的 EBA(它是 Bodies 的子集,约占其体素的 80%,不做独立两两比较),以及 V1 和 V4;每个 ROI 只保留噪声校正信噪比 ncsnr ≥ 0.2 的体素(对应噪声天花板约 0.33),同一对比中的所有模型使用同一组体素,并在 0.3/0.4 阈值下验证了稳定性。
模型与指标方面:视觉特征取 DINOv2 ViT-B/14 的第 2/6/11 层,分别配 V1、V4 与类别选择性 ROI;语言特征取 MPNet 第 2/6/12 层,按编码器深度配对且事先固定、不按预测表现挑选;所有特征空间经稀疏随机投影统一到 256 维,避免"特征更多者占优"。对每个语言预测器 L 拟合带状岭回归(banded ridge regression,视觉带与语言带各有正则惩罚,逐体素五折嵌套交叉验证选惩罚),预测精度 r 为折外预测与重复平均响应的 Pearson 相关,除以该体素噪声天花板后在 ROI 内平均。核心量是 ΔV(L) = r(V+L) − r(L);两个语言预测器 A、B 的对比为 ΔV(LA) − ΔV(LB) = [r(V+LA) − r(V+LB)] − [r(LA) − r(LB)],即联合项减语言单项项。不确定性用对 10,000 张评估图像的配对 bootstrap(1,000 次重抽样,同一索引施加到对比中所有模型,模型不重拟合)给出 95% 百分位区间;因只有两名被试,只报告被试内效应、不做总体推断。
主要结果
-
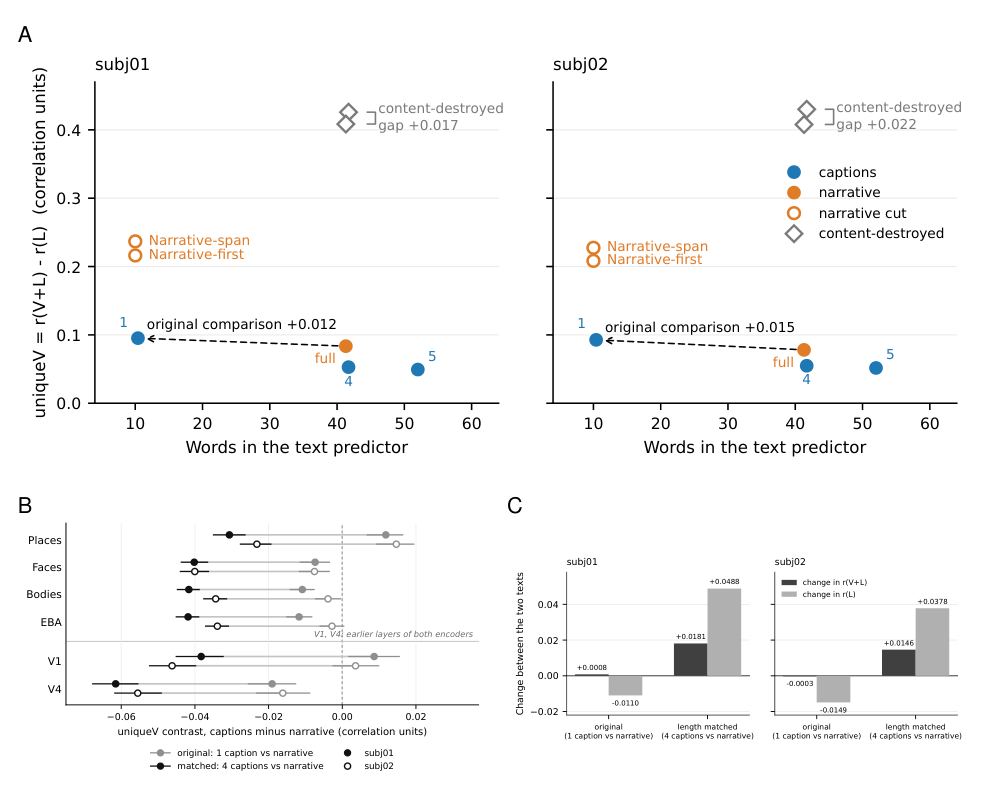
原始对比偏向 narrative,但混着约四倍的长度差。 Places 中 1 条 caption 对 narrative 的 ΔV 对比为 +0.0118 [+0.0066, +0.0166](subj01)与 +0.0147 [+0.0092, +0.0196](subj02),意即长文本给视觉留下的"额外贡献"更少;两个预测器家族的 ΔV(L) 都随文本词数单调下降(图1A)。
-
字数匹配后符号反转。 四条拼接 caption(41.7 词)对 narrative(41.3 词)的对比变为 −0.0307 [−0.0351, −0.0262] 与 −0.0232 [−0.0278, −0.0192];把 narrative 截到 caption 长度同样反转:对 Narrative-first 为 −0.121/−0.116,对 Narrative-span 为 −0.141/−0.135(subj01/subj02)。而两种截断彼此还相差 0.020/0.019——字数完全固定时,嵌入文本的哪一段也能改变 ΔV(图1A)。
-
同向位移横跨所有 ROI。 长度匹配使六个 ROI 的对比一律向 caption 方向移动 −0.030 至 −0.050,所有 bootstrap 区间排除零;匹配后每个对比都为负。符号反转只发生在原先偏向 narrative 的地方(两名被试的 Places 和 subj01 的 V1),但位移本身跨 ROI 一致;类别选择性 ROI 中匹配后 Places 最不负,其与 Faces、Bodies 的两两差异排除零(图1B)。
-
对比主要由语言单项预测驱动。 分解显示,Places 原始对比的联合项仅 +0.0008/−0.0003,语言单项项为 −0.0110/−0.0149;匹配后语言单项项 +0.0488/+0.0378 仍大于联合项 +0.0181/+0.0146。在所有 ROI、被试与比较中语言单项项的量级都更大:匹配条件下在类别选择性皮层大 2.2–3.1 倍,在 V1/V4 大 14–24 倍(图1C;附录表 A4)。
-
去掉图像特异内容词后对比仍部分存活。 将相关操作描述替换为:“用 spaCy 对名词、专有名词、动词、形容词和数词等内容词进行替换,优先匹配细粒度词性;无可用替代词时依次退回粗粒度词性和完整内容词词表。替换词按同一数据集中的词频抽样,抽样独立于图像,并排除该图像原描述中出现的内容词;系动词 be 的形式保留。”,Faces/Bodies/EBA 的匹配对比仍为负(−0.062/−0.052、−0.081/−0.038、−0.084/−0.045),说明这类效应可以在去除原始图像特异词汇内容后存活;但 Places 打乱后反号(+0.017/+0.022)。由于打乱保留了决定词数量等描述层面性质(仅决定词数量一项在 Places 即达 r(L)=0.14/0.16),存活的对比不能唯一归因于被移除的词汇语义内容。
附录还进一步约束了长度效应:同一 narrative 的随机 10/20/41 词子样本使 ΔV 单调下降(subj01:0.248→0.145→0.093,全 narrative 为 0.084);把 8 个独立的 10 词随机视图做嵌入平均,恢复了单视图与全 narrative 之间差距的 78.0%/76.2%,尽管没有任何一次编码器前向传播看到超过 10 个词。在该句后补充:“但 narrative 内词数与词汇多样性指标 type-token ratio 共线,二者同时进入回归后,标准化词数系数变为零或略正,因而无法分离词数与词汇多样性的作用。该关系也依赖语料:单条 caption 长度未呈现预测关系,四条 caption 条件在类别选择性 ROI 中反而呈轻微正相关(+0.03 至 +0.05),而 V1/V4 的方向仍与 narrative 一致。因此,这些结果不能解释为词数本身的普遍因果效应。”
图注解读
图 1 · 预测器构建方式如何翻转多模态对比
原文图注:Figure 1A shows that ∆V (L) decreased with text length for both predictor families. When four concatenated captions (41.7 words) were matched to a narrative (41.3 words), the contrast reversed to −0.0307 [−0.0351, −0.0262] and −0.0232 [−0.0278, −0.0192]. Truncating narratives to caption length gave the same result: one caption versus Narrative-first yielded −0.121/−0.116, and versus Narrative-span −0.141/−0.135, for subj01/subj02. The two narrative truncations themselves differed by 0.020/0.019, showing that predictor construction matters even at fixed word count.
整张图分三块。A 面板以 Places 为例:横轴是文本预测器的词数(约 10–60 词),纵轴是 uniqueV = r(V+L) − r(L)(相关单位,量程约 0–0.4);橙色点族是 caption 家族(1、4、5 条拼接),随词数增加整体下行,narrative 位于约 41 词处;虚线箭头标出原始 1-caption 对比(+0.012/+0.015);开放的橙色点 Narrative-first/Narrative-span 是截到 caption 长度的两种 narrative;灰色菱形是"内容破坏"(content-destroyed)控制条件,图上标注其 gap 约为 +0.017/+0.022。B 面板把六个 ROI(Places、Faces、Bodies、EBA、V1、V4)在两被试上的原始(1 caption 对 narrative)与长度匹配(4 captions 对 narrative)对比并排画出,横轴为 uniqueV 对比(captions 减 narrative);匹配前只有 Places(两被试)和 subj01 的 V1 为正,匹配后实心/空心标记(分别代表 subj01/subj02)全部落在零以下,误差棒为 95% bootstrap 区间,图中并注明 V1/V4 使用两个编码器的较浅层、不与类别选择性 ROI 定量比较。C 面板把 Places 对比分解为联合预测变化 r(V+L) 与语言单项变化 r(L) 两组条形:两个比较中语言单项条的绝对值都更大(匹配后 +0.0488/+0.0378 对 +0.0181/+0.0146)。这张图同时支撑上文结果 1–4:反转存在、位移跨 ROI 一致,且主要由条件化语言预测器自身驱动。
讨论
作者的解释相当克制。原始比较把描述类型与约四倍的长度差混在了一起,匹配字数后符号反转,说明原效应经不起这个最基础的控制;但他们并不把反转解读为长度的纯因果效应——四条拼接 caption 同时改变了标注者数量、冗余度和词汇多样性。真正的普遍论点来自 narrative 截断实验:即便在同一语料内、逐图像字数匹配,选择嵌入文本的哪一部分也会改变 ΔV。因此"预测器构建是实验设计的一部分,而不是一个中性的预处理选择"。机制层面,随机子样本与多视图池化实验与"估计方差降低、内容覆盖扩大,或两者兼有"的图景兼容,但分析无法把二者分开;嵌入范数与序列位置的替代解释则被排除。打乱实验的读法也被谨慎处理:它保留了若干本身就有预测力的描述层面性质,同时又大幅拉低语言模型精度(如 Places 中 narrative 的 r(L) 从 0.557/0.588 跌到 0.213/0.240),所以作者只把它当作可辨识性控制,而非"形式对内容"的可分离估计。局限方面,结论限于两名深度采样 NSD 被试与 DINOv2–MPNet 这一特定特征空间组合,匹配条件与 narrative 在标注者数量等属性上仍不同,实验并未 isolate 出反转的单一原因;作者也强调这些结果并不意味着语言衍生特征不能捕捉有意义的神经表征。文章对话的对象很明确:主张高阶视觉皮层与大语言模型对齐的一系列工作(如 Doerig 等 2025、Wang 等 2023)、model-to-brain 比较与扰动检验的传统(Conwell 等)、以及探针控制任务与 multiverse 分析的方法论文献(Hewitt & Liang;Steegen 等)。落点的实践建议很具体:嵌套对比不应只凭差值本身解读——明显的混淆维度应尽量匹配,应检查分解后的成分项,并应在替代预测器构建或定向扰动下复检结果。
一句话总结
这篇 preprint 用一个近乎极致的控制设计证明了一件让人后背发凉的事:你用来宣称"视觉皮层在语言之外还表征了什么"的嵌套对比,其符号可以被条件化预测器的拼接方式整个翻转,而且将“翻转的主要来源根本不在联合模型里,而在语言单项预测里”替换为“对比的翻转主要由语言单项预测差异驱动,但长度匹配后联合视觉—语言模型也存在较小的非零变化”。以我的理解,它的价值不在于推翻某一篇具体论文,而在于把"预测器怎么造"确立为必须报告的实验设计变量——以后读到任何嵌套增益比较,第一反应应当是去查条件化预测器的长度、来源与构成,以及分解后的语言单项项。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: 翻转的主要来源根本不在联合模型里 -> 评注:
- 审校纠偏: 近乎极致的控制设计证明 -> 评注:
- 补充要点: : (第 15 页)
- 补充要点: : (第 12 页)
- 补充要点: : (第 15 页)
- 补充要点: : (第 18 页)