IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
305| 原始基线:V0_ZCODE_BASELINE| 语义审核:needs_revision| 图表审核:minor_issue
Comparison of Object Recognition Behavior in Human and Monkey
Rajalingham · Journal of Neuroscience · 2015 · Zotero itemID=2599
猕猴被广泛用作人类视觉加工的动物模型,但"恒河猴的不变物体识别行为到底和人类有多像"此前从未被系统定量检验过。这篇论文让两只猕猴和大规模网络人类被试做完全相同的 276 个二选一物体识别任务,发现猴子不仅平均成绩与人类相当,连"把什么物体错认成什么物体"的混淆模式也和人类高度相关、在统计上无法与个别人类被试区分开;而改为“低层模型与人类模式的一致性明显较低,并在三个个体比较组中的两个组被统计排除”。。据作者所知,这是首次对人与猕猴高级视觉行为的系统比较,也是"猴腹侧流可作为人类模型"这一领域默认假设最早的定量背书之一。
研究背景
不变物体识别(invariant object recognition)——在观察角度、位置、尺度、背景高度变化的情况下快速可靠地辨认物体——是人类视觉的核心能力,也是计算上的难题。猕猴作为旧世界灵长类,约 2500 万年前与人类分化,其视觉皮层与人之间存在很强的解剖和功能对应(Tootell et al., 2003; Orban et al., 2004),因此长期被默认为人类高级视觉的良好模型。但这个默认假设有个尴尬的空白:以往研究只证明过猴子"能学会"做各种物体形状任务,这既可能是与人类共享的知觉能力,也可能只是猕猴强大学习能力的表现;至于两者在"哪些物体对、哪些物体容易错"这一行为模式层面是否一致,没有任何人系统比较过。低级视觉行为(如对比敏感度、颜色阈值、朝向辨别)上人与猴的定量相似早有报道,所以问题的关键恰恰集中在高级行为上。
与此同时,出现了两个使这个问题变得紧迫的背景。一是啮齿类模型兴起,有工作显示大鼠也具备定性的不变形状辨别能力(Zoccolan et al., 2009),这让"到底该用哪个动物模型外推到人"成为方法论问题;二是深度卷积神经网络开始能复制灵长类核心物体识别的成绩(Cadieu et al., 2014; Yamins et al., 2014),为行为模式提供了可检验的表征层对照。作者的思路顺势而成:要论证猕猴是合格模型,光看平均正确率不够,必须让猴子、人类和机器在完全相同的大量任务上比"错误长什么样"。
研究思路
整篇文章的设计围绕一个核心威胁展开:行为差异可能只是"图像记忆匹配"而非真正的物体识别。为了堵住这个口子,作者用 3D 模型渲染生成几千张自然感合成图像——每个物体的观察参数(2D 位置、三轴 3D 旋转、观察距离)随机采样,前景再贴到随机的室内外自然图像背景上——使任何识别系统都必须直面"不变性问题"本身。任务采用"核心物体识别"的操作定义:单次注视、图像呈现仅 100 ms、位于注视中心附近,不给反馈,从而排除特征注意策略和反复审视的可能。比较逻辑分三层:第一层比较成绩水平(学习速度、对新图像的首次泛化);第二层把 276 个二选一任务的 d′(无偏敏感度)排成"行为成绩模式",用去噪秩相关(consistency)量化猴、人、机器三者模式的相关;第三层用人类被试个体差异做参照系——如果猴与人类总体的不完美相关只是"两个个体的正常涨落",那么猴应该落在人类个体分布之内、统计上无法与人区分,而低层视觉模型应该被这个分布剔除。最后用像素和 V1+ 模型作阴性对照、HMAX 与深度 CNN 作计算模型对照,把"共享表征"这一结论钉得比单纯行为描述更实。
方法
动物为两只成年雄性恒河猴(M 约 6 kg,Z 约 12 kg)。刺激来自 24 个基本水平(basic-level,Rosch et al., 1976 定义)物体(从 64 个可靠命名的物体集中随机抽成 3 组、每组 8 个,抽样偏向人类混淆模式丰富的组):每个物体渲染 2400 张测试图像(每物体 100 张,1024×1024 灰度、方形光圈)和 4800 张训练图像(每物体 200 张),训练/测试集的图像空间采样密度经像素距离分析验证接近"理想泛化"条件。行为范式为二选一匹配:猴 M 在头部固定、眼动仪(Eyelink II)监控下注视 200 ms 触发中央 6°×6° 测试图(100 ms),随后在 ±6° 偏心处出现两张标准视角选项图,用注视选择图 700 ms 报告;猴 Z 不做手术、头部自由,用触屏触摸报告。人类数据全部来自 Amazon Mechanical Turk:605 人合计 69,000 次试验(每任务约 250 次)汇成"人类池",另招募 33 人作为个体样本(每组 8 物体 16/16/12 人,人均约 3003 次试验,以拆半信度显著大于 0.5 为纳入标准),改为“人类与猴子完成相同的276个物体对识别任务,但报告方式、注视控制和反馈条件不同”。、276 个任务逐试次随机穿插,约 1% 疑似乱猜的被试被剔除。分析上用信号检测论的 d′ 作为无偏成绩(限幅 [0,5]),276 维 d′ 向量即为"行为成绩模式";信度用拆半相关的 Spearman–Brown 校正估计;两个模式之间的一致性(consistency)用去噪秩相关计算;机器模型(像素、V1+、HMAX、CNN2013)在同一批图像上提取特征、用最大相关分类器经两折交叉验证 50 次置换给出各自的 276 维模式。
主要结果
- 猴子几天学会一个新物体,之后与人持平且不再随经验变化。每组 8 个新物体直接上全变化图像,约 1000–2000 次图像呈现(约 10–15 个行为场次)即达高成绩;而 15 名有足够纵向数据的人类个体一开始就是高成绩,且成绩不随无监督曝光次数变化,说明人类对这些物体早已"训练有素"(图 2A–C)。
- 猴子不是在背图像。全部 276 个任务训练达标后换用保留测试图像,两只猴首次见新图的正确率分别为 88%(M)和 85%(Z);首次成绩与该图到最近训练图的像素距离无显著相关(M:r=0.036,p=0.07;Z:r=0.010,p=0.63),训练/测试两套图像集的混淆模式一致性高达 0.9566/0.9489,后续重复曝光也不再提升成绩(图 2D)。两猴共采集 106,844 次试验,人类池 69,000 次。
- 混淆模式高度共享。276 维成绩模式矩阵上人猴定性相似,如(骆驼,狗)和(坦克,卡车)都是两物种的易混对(图 3A);以人类池为金标准,去噪一致性为:合并猴 0.78±0.007(单猴 M 0.80±0.009、Z 0.66±0.005),远高于像素 0.37±0.003 和 V1+ 0.52±0.004;CNN2013 达 0.86±0.006,高于腹侧流(ventral stream)替代模型 HMAX 的 0.55±0.004(图 3B、C)。
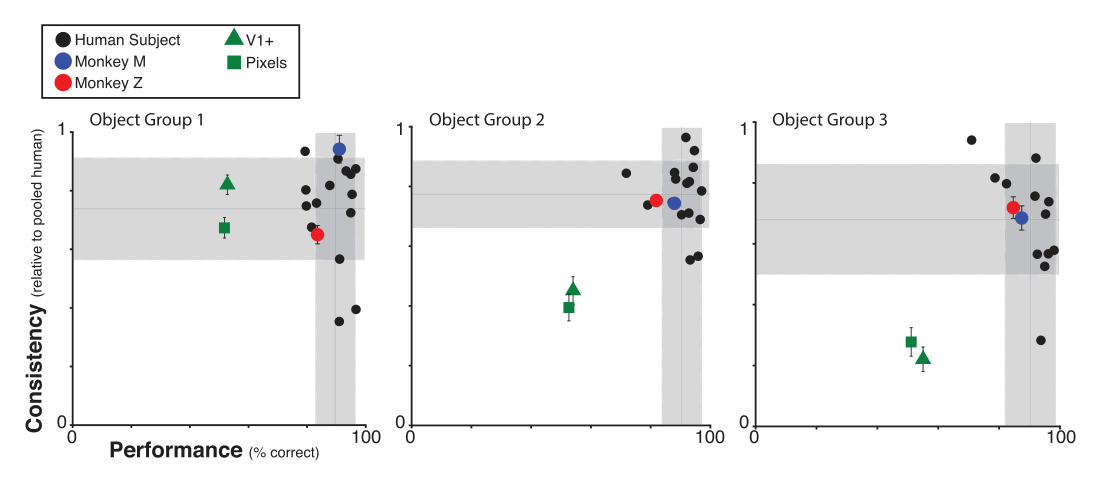
- 猴落在人类个体分布之内,低层模型落在分布之外。人类被试之间存在显著的个体差异(个体与人类池的平均一致性仅 0.74/0.77/0.68,三组两两个体间中位数 0.76),以个体分布为参照,两只猴与人类个体统计上无法区分(M:p=0.4/0.21/0.22;Z:p=0.16/0.22/0.27,Fisher 精确检验),而像素和 V1+ 在三组中的两组被剔除(V1+:p=0.30/0.03/0.03;像素:p=0.17/0.02/0.03);CNN2013 三组都无法剔除,HMAX 被剔除一组(图 4)。即使把两猴合并与"两名人类合并"的抽样分布比,合并猴也无法被拒绝(图 3C 虚线阈值)。
- 偏置不可比,d′ 才是可靠的行为指纹。用反应偏置指标 c 分析发现其跨被试一致性(个体对中位数 0.40)远低于 d′(0.76),即"倾向选哪个选项"的偏置远不如混淆结构稳定,故不是比较物种的可靠行为指纹。
图注解读
图 1 · 刺激图像与猴行为范式
原文图注:Figure 1. A, Two example images for each of the 24 basic-level objects, sampled from the test set (each row corresponds to a group of 8 objects). To enforce true object recognition behavior (rather than image matching) and tackle the invariance problem, we generated thousands of naturalistic images, each with one foreground object, by rendering a 3D model of each object with randomly chosen viewing parameters (2D position, 3D rotation, and viewing distance) and placing that foreground object view onto a randomly chosen, natural image background. B, Behavioral paradigm (for monkey M). Each trial was initiated when the monkey held gaze fixation on a central fixation point for 200 ms, after which a square test image (spanning 6° of visual angle) appeared at the center of gaze for 100 ms…
A 部分按三组、每组 8 个物体列出测试集示例,读者能直观看到同一物体在不同姿态、位置、背景下的变化幅度,理解为什么要强调"识别物体而非匹配图像";B 部分以猴 M 为例画出试次时间线(注视 200 ms → 测试图 100 ms → 左右两张标准视角选项图,注视选定图 700 ms 报告),并注明猴 Z 用触屏完成相同任务、答对给果汁、答错罚 1.5–2.5 s 停顿。这张图是理解后面所有行为数据的前提。
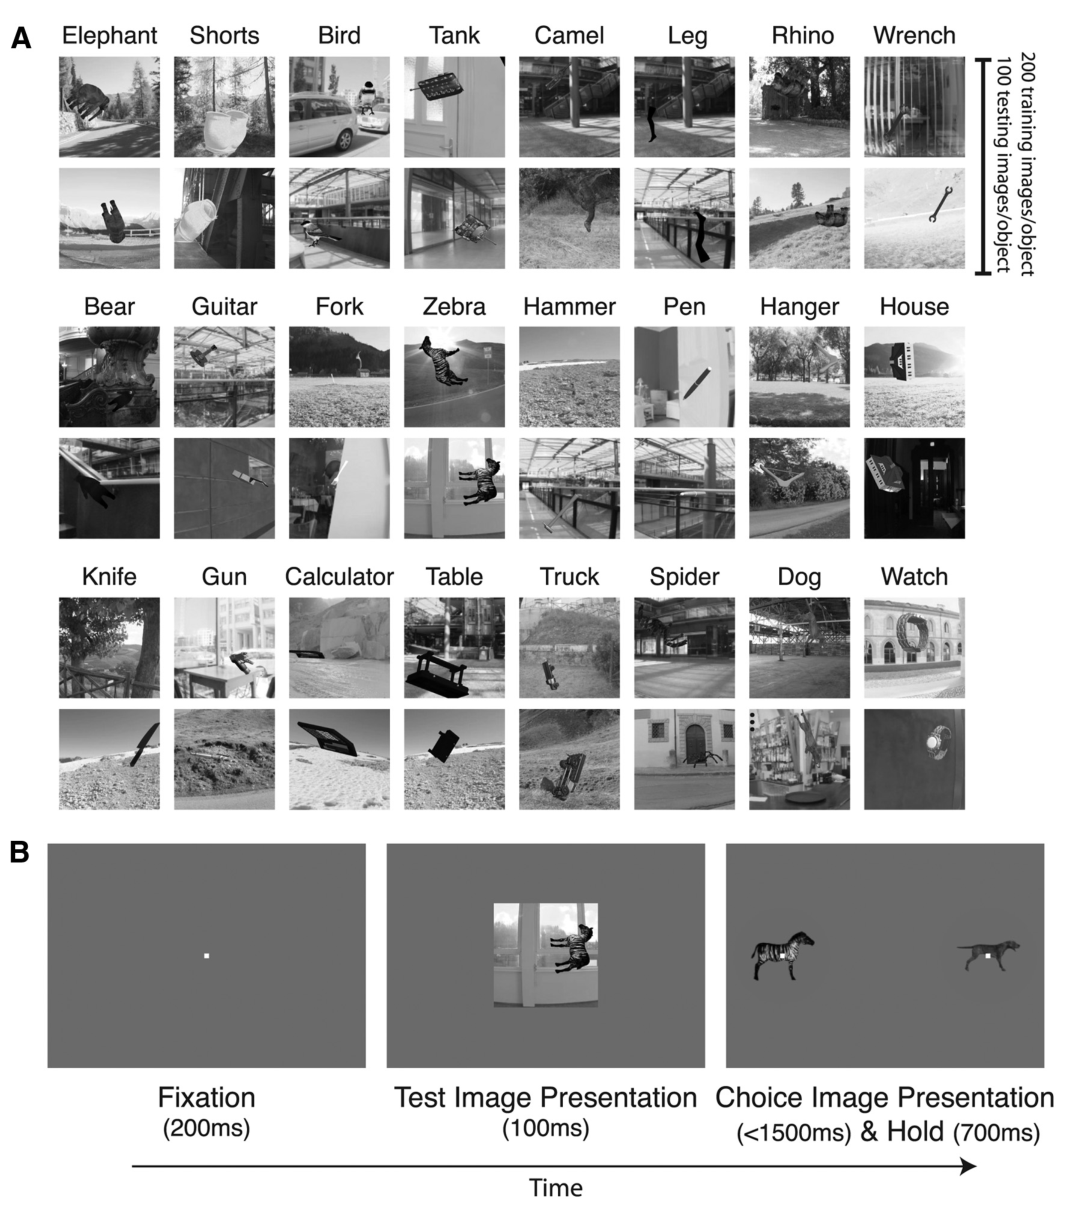
图 2 · 新物体学习速度与对新图像的泛化
原文图注:Figure 2. A, B, Learning of novel objects. For each monkey, performance relative to the human pool, quantified as a Turing ratio d′/d′ human pool (one-versus-all d′), for each of these 16 objects (colored dots) and the mean over objects (black line) are shown. For these 16 objects, animals were exposed to full-variation images in groups of eight objects and reached high performance in 1000–2000 image presentations per object. C, Performance relative to the human pool, quantified as a Turing ratio, of two monkeys and 15 unique individual humans subjects with sufficient longitudinal data on the same tasks (mean ± SE over subjects)…
A、B 面板分别追踪两只猴接触 16 个新物体时的相对成绩(以人类池的 d′ 归一),彩色点为单个物体、黑线为均值,曲线快速爬升到 1 附近说明每物体约 1000–2000 次呈现即可学成;C 把两只猴和 15 名人类个体制在同一坐标里,人类起点即高、随曝光无变化,猴达标后(Test 标记)也与人类持平;D 上图检验泛化是否依赖与训练图的相似度(首次成绩对像素距离回归,斜率不显著),下图用"理想泛化"替代集证明训练集并未把图像空间采得太密。这张图支撑结果 1 和 2,是排除"猴子只是过拟合/背图像"的关键。
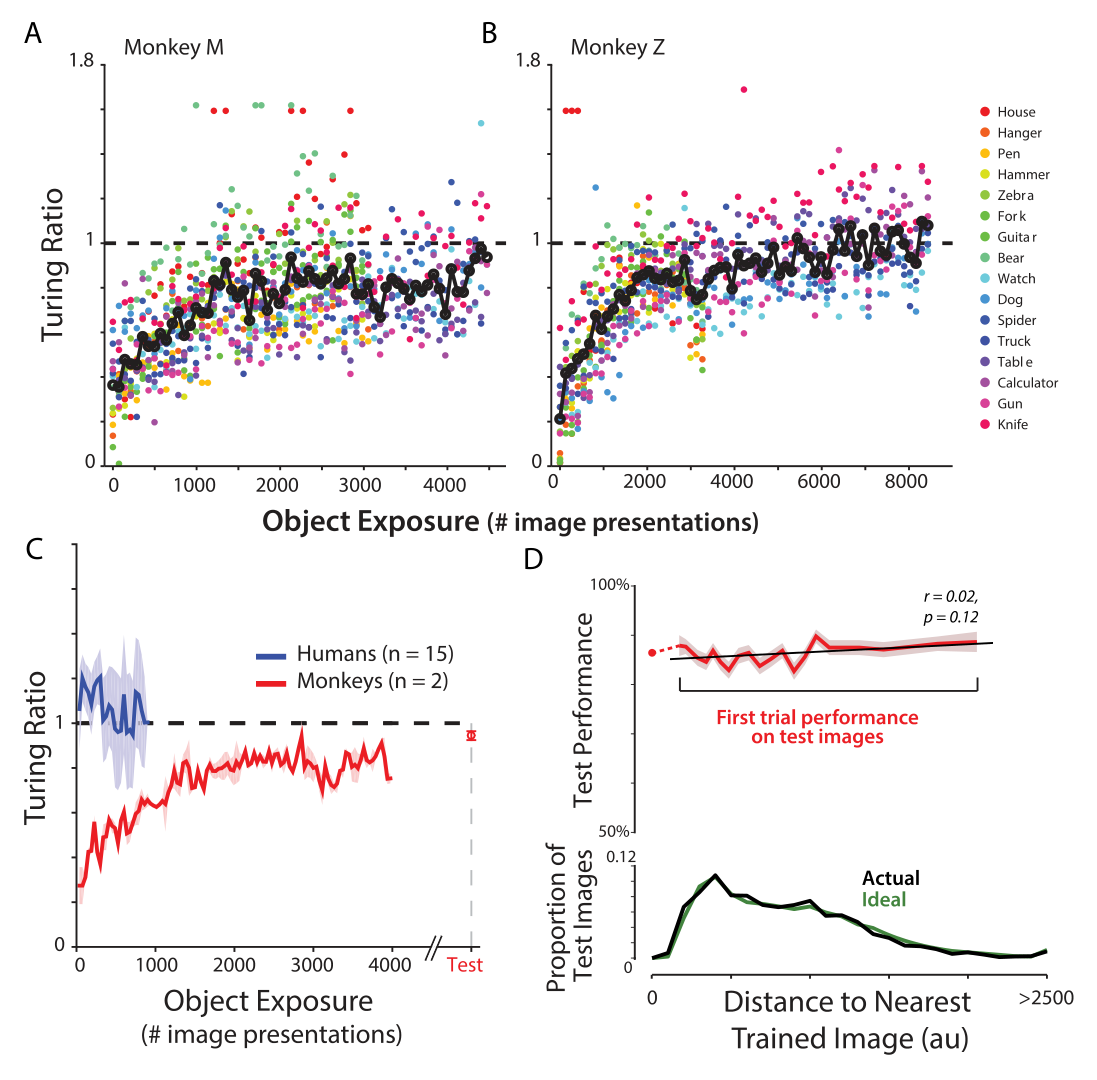
图 3 · 276 个任务的混淆模式及其跨物种一致性
原文图注:Figure 3. A, Pattern of behavioral performances for the pooled human and pooled monkey. Each 24×24 matrix summarizes confusions of all two-way tasks: the color of bin (i, j) indicates the unbiased performance (d′) of the binary recognition task with objects i and j. Objects have been reordered based on a hierarchical clustering of human confusion patterns to highlight structure in the matrix. We observe qualitative similarities in the confusion patterns. For example, (camel, dog) and (tank, truck) are two often confused object pairs in both monkeys and humans…
这是全文主图。A 把人类池和猴池的 276 维 d′ 模式各画成一张 24×24 对称矩阵(按人类混淆的层次聚类重排物体),肉眼可见两图的深浅纹理对应;(camel, dog)、(tank, truck) 这类易混对在两物种同样成立;B 以散点把合并猴、像素模型对人类池的 276 个 d′ 逐一比较——猴的点沿对角线紧密排布,像素则明显偏离;C 给出量化的一致性柱状对比(合并猴 0.78、单猴 0.80/0.66、像素 0.37、V1+ 0.52、CNN2013 0.86、HMAX 0.55),虚线为人类个体对之间的一致性置信阈值;D 比较两只猴彼此的模式。它支撑结果 3、4 的核心结论。
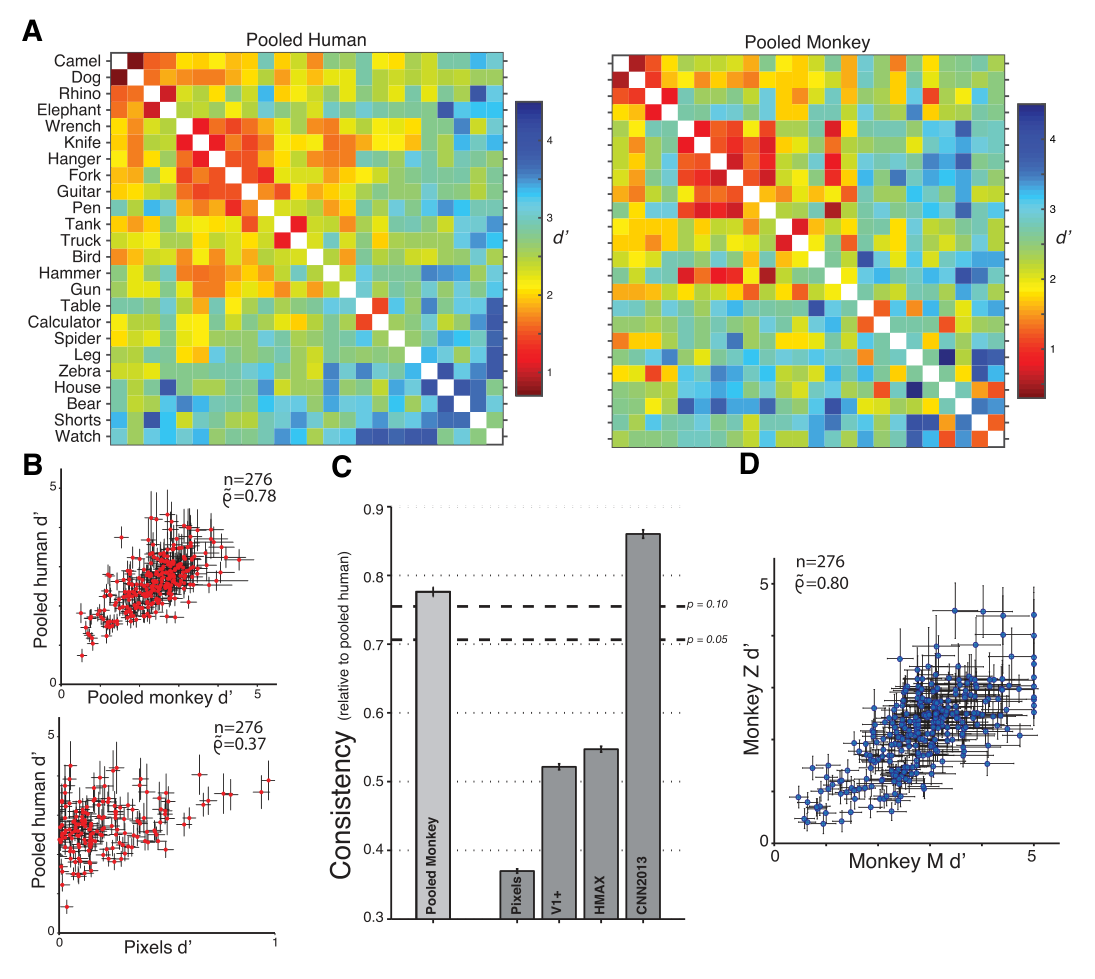
图 4 · 以人类个体差异为参照检验猴与机器
原文图注:Figure 4. Accounting for intersubject variability. For each of three groups of eight objects, the absolute performance and consistency of individual human subjects, individual monkeys, and machine features are shown. Error bars for consistency relative to pooled human (mean ± SD) are shown for individual monkeys and machine features for each group (error bars for monkeys are not visible in object group 2 because of small variability). The shaded gray areas indicate the distribution of performance/consistency over individual human subjects (mean ± SD)…
这张图回答一个关键质疑:"猴与人类池一致性不到 1,是不是物种差异?"作者把每只猴、每个机器模型的绝对成绩和对人类池的一致性,放到人类个体成绩/一致性的灰色分布带里看:两只猴都落在带内(p=0.16–0.4),像素和 V1+ 则在两组物体上掉出分布(p=0.02–0.03),CNN2013 三组都在带内、HMAX 掉出一组。读者需注意这只有 3×28=84 个任务、占图 3 全集的 30%,但正是"个体差异参照系"让"猴≈个别人"从定性说法变成统计检验。它支撑结果 4。
讨论
作者的解读分三步走。第一,行为层面的结论是"稳态相似":猴子学会任务后,成绩与混淆模式都与人类定量可比,且额外经验对两物种的稳态行为都没有可观影响——但这并不意味着两物种学习新物体的速度相同。第二,他们把这种行为相似与比较影像学的证据接上:腹侧视觉流在猴与人之间近乎完整保守(Mantini et al., 2012),IT 末端的物体类别表征在两物种间匹配(Kriegeskorte et al., 2008),于是提出人猴可能共享一套直接支撑基本水平物体知觉的神经"形状"表征。第三,CNN2013 能预测两物种共同的行为模式而 HMAX 和低层模型不能,提示当前高性能深度卷积网络可能恰好捕捉到了这套共享表征。局限方面作者说得很直白:猴只有 2 只,无法证明人猴绝对无差异,只能说现有检验有足够统计力剔除像素和 V1+ 这类模型、却剔除不掉猴;猴 Z 成绩较低(83.4% 对 M 的 89.2%)且模式信度较低(p<0.001),可能与其不受控的注视有关,两猴间的差异无法区分是真实个体差异还是效应器(眼动 vs 触摸)不同;另外每类别只有单一 3D 模型实例,结论只覆盖"3D 物体的视觉相似性判断",不能外推到跨实例的语义类别或从属水平辨别(如面孔倒置效应这类可能的物种差异,文中明确表示未检验)。
一句话总结
这篇文章的聪明之处在于把"像不像"从平均正确率搬到了错误的几何结构上——两物种不仅对错程度相当,连"怎么错"都像同一个系统犯的错,这比任何成绩数字都更有说服力。按我的理解,它是那批 DiCarlo 实验室工作的行为基石:先确立猴与人在行为上不可区分,后面的神经记录和模型比较才有资格直接平移到人类。读的时候记住它的边界:任务是二选一、单实例、基本水平,猴只有两只——"统计上不可区分"永远是"至今未被区分",而不是"被证明相同"。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A, B] - Fig2: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig3: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig4: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '研究思路', 'current_text': '把‘共享表征’这一结论钉得比单纯行为描述更实', 'problem': '行为相关和计算模型拟合不能确认共享神经表征,更不能确定其脑区或因果作用。', 'recommended_fix': '改为“为共享表征假说提供了间接、相关性的行为证据”。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '图注解读—图2', 'current_text': '用‘理想泛化’替代集证明训练集并未把图像空间采得太密', 'problem': '该分析仅在降低分辨率、去除背景后的像素欧氏距离和六种单参数保留条件下表明采样密度接近替代条件,不能“证明”训练空间普遍稀疏。', 'recommended_fix': '将“证明”改为“提示”,并注明结论依赖所用像素距离和替代集定义。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '一句话总结', 'current_text': '先确立猴与人在行为上不可区分,后面的神经记录和模型比较才有资格直接平移到人类', 'problem': '研究只是在两只猴、单实例基本水平物体和有限个体比较任务中未拒绝人猴差异;这不等同于确立普遍行为等价,也不足以授权神经结果“直接平移”到人类。', 'recommended_fix': '改为“为在该受限行为域内使用猕猴研究人类视觉提供支持,但跨物种神经外推仍需独立验证”。'} -> 评注:
- 审校纠偏: {'classification': 'INTERPRETATION', 'md_section': '讨论', 'current_text': 'CNN2013 能预测两物种共同的行为模式……提示当前高性能深度卷积网络可能恰好捕捉到了这套共享表征', 'problem': '这是与数据相容的模型解释,不是被实验唯一支持的机制结论;CNN2013主要以人类池为金标准进行一致性评估。', 'recommended_fix': '保留“可能”措辞,并明确其他具有相似输出结构的表征也可能产生同样的行为相关。'} -> 评注:
- 补充要点: : (第 5 页)
- 补充要点: : (第 4 页)
- 补充要点: : (第 2 页)
- 补充要点: : (第 8 页)
- 补充要点: : (第 8 页)