IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
298| 原始基线:V0_ZCODE_BASELINE| 语义审核:needs_revision| 图表审核:pass
Neural Mechanisms Underlying Visual Object Recognition
Afraz · Cold Spring Harbor Symposia on Quantitative Biology · 2014 · Zotero itemID=2578
这篇会议综述来自 DiCarlo 实验室,提出并把"腹侧视觉流"研究拆成两个可以分别证伪的数量化模型:编码模型(encoding,视网膜像素 → 神经群体活动模式)与解码模型(decoding,神经群体活动 → 行为选择)。文章报告了截至 2014 年的两条主线进展——基于 IT(inferior temporal cortex,下颞叶皮层)群体活动的简单线性解码足以预测人类在 64 个识别任务上的全部成绩模式,以及用光遗传学与药理学直接压制 IT 亚区可以因果性地验证这一解码模型——同时在编码一端展示了性能优化的层级卷积神经网络(HCNN)预测 V4/IT 神经反应的能力。值得精读之处在于它示范了"生成模型 + 因果扰动 + 行为闭环"这一整套研究范式。
研究背景
核心问题在于像素层面信息与行为需求之间的错位:视网膜呈给视皮层的是每个像素的亮度,而行为上需要的判断(比如把朋友的鼻子认出来)被视角、位置、尺度、背景等低级变化严重淹没。已知这条"解缠"(untangling)变换由腹侧视觉流承担——V1、V2、V4 一直到 IT:V1 神经元类似 Gabor 滤波器、对平移旋转几乎没有容忍度,V4 有中等程度的对变换的容忍度,而 IT 群体活动模式可以直接支持跨复杂图像变换的物体分类(可被线性读出)。所以-field 内的一个长期工作范式是:假设识别行为直接由 IT 神经反应驱动,用简单解码算法从 IT 读出。
但缺口同样清楚。一方面,以往"IT 编码类别"的证据是定性的,没有给出一个能预测"任何识别任务上行为难度全貌"的紧凑连接模型(linking model);作者特别强调,只有把任务做到人会产生错误、且错误模式跨被试高度一致的程度,相关证据才有鉴别力——白鸽对黑熊那种靠颜色就能解决的"识别"根本触及不了不变性问题。另一方面,相关再强也不能证明因果:一个对性别判别有 90% 判别准确率的 IT 神经元,未必真的参与性别判别行为。而截至写作时,IT 神经反应与物体识别之间只有两项因果研究(Afraz et al. 2006 的微刺激、Verhoef et al. 2012 的三维结构分类),远谈不上全面。
研究思路
作者的总体逻辑分两步走,顺序暗含讲究:先做解码("神经群体活动 → 行为"),因为只有先把这一环节精确刻画出来,才知道应该优先为哪群 IT 神经元、哪些属性去建编码模型。解码端再分两阶段:先用强相关的方法确立一个"工作解码模型"——用几十种候选"神经码"(neural codes)逐个对比人类全部 64 个识别任务的行为成绩模式,看哪种码能预测全部任务的难度格局;再用因果的方法检验——通过光遗传学与药理学直接压制 IT 亚区活动,看行为损失是否落在这个工作模型的预测上。编码端则把问题交给层级卷积神经网络(hierarchical convolutional neural network, HCNN):以"完成识别任务的表现"为优化目标,筛选出性能好的网络,再检验其内部各层对 V4、IT 神经反应的预测力。
这套设计的妙处在于三重约束互锁:心理物理任务必须难到产生错误(否则无法比对失败模式);神经记录用猕猴被动注视同一套图像(把"人类主动做任务"与"猕猴被动看图"之间的差异交给一个假设——学习新任务发生在下游脑区,只是修改它们对腹侧流输入的突触权重,因此被动响应已含行为所需全部信息);因果实验只选一个具体任务(高难度的面孔性别判别)验证可行性。
方法
涉及三组数据。(1) 人类心理物理:用真实世界物体的 3D 模型(面部、汽车等,每类多个范例)经光线追迹渲染、贴在无相关背景上生成测试图像,测人类在一个八类基本水平分类任务(面孔、汽车、飞机、动物、桌子、椅子、船、水果)与两个下位八选项识别(汽车型号 Beetle/BMW z3/Ford 等;面孔 face1/face2 等)上的成绩,共 24 个标签 × 6 档身份保持的视角变化 = 384 个任务的 d′ 热图(图 2B)。(2) 猕猴电生理:两只猕猴在被动注视范式下观看同一套图像,大样本采集 V4 与 IT 的多单元/单点反应(IT 共 168 个位点用于编码分析)。(3) 因果实验:猕猴学会注视报告的性别判别任务后,分别用 200 ms 窗口的光遗传抑制和 muscimol 微量注射压制 IT 各小亚区(约 1 mm 直径)的活动,同时以被动注视下记录的多单元活动训练线性分类器,得到每个亚区的"局部线性分类"成绩作为该区的性别信息可分性。
解码分析中,作者把"神经码"操作化为 IT 平均放电率的不同组合方式(图 2 展示了 14 种候选码),对每种码计算它能预测的行为 d′(neural-predicted d′),与全部 64 个测试的人类心理物理 d′ 模式对齐比对;只有码本身、而非任何其他层面的模拟反应,若能覆盖全部任务的难度格局才算"充分"(图 2C 打星号者)。编码分析则以上一刺激后 70–170 ms 的平均放电率为"反应",在保留出测试集的系统上计算解释方差百分比(neural predictivity)。统计上,因果部分用重复测量 ANOVA 检验同侧/对侧视场与抑制方式的交互,相关部分报告相关系数与线性回归外推。
主要结果
- 解码模型:线性读出 IT 足以解释人类行为。在 14 种候选码中,只有基于 IT 群体平均放电率的简单学习型线性求和通过了"预测全部 64 个测试难度模式"的高门槛(图 2C 打星号的码);所有 V4 神经码、全部 V1 样模型的模拟码都失败。这把"IT 伺候行为"从一个定性联想升级为一个可证伪的全局预测,并直接排除了"行为难度由 V4 编码决定"等备择假说。
- 因果验证一:压制面孔选择亚区损害性别判别,且只在对侧视野。光遗传失活神经 d′ > 1(面孔 vs 其他物体)的 IT 亚区使对侧视野呈现面孔的性别判别成绩小幅而显著下降(中位数 1.8%,均值 2.02%,t(16)=5.99,P < 0.0001);muscimol 失活同类亚区造成 5.5% 的下降,同样仅限对侧,同侧视野成绩不变(交互检验 F(4,20)=7.5,P < 0.001)。非面孔选择亚区失活无此效应。
- 因果验证二:各亚区的行为重要性可由其局部线性可分性预测。把每个约 1 mm 亚区的"局部线性分类"成绩(被动注视记录训练的线性分类器对性别分类的水平)与该区光遗传失活的行为影响对齐,二者高度相关(P = 0.01;相关系数在 PDF 文本层因乱码应约为 0.6),线性回归外推表明失活可分性最高的亚区最多造成约 2.5% 的行为下降(图 3)。作者据此论证:IT 表征已相当接近驱动行为的读出机制,对上游区域(V1、甚至 V4)应不会出现这种对应。
- 编码模型:任务性能优化"捎带"出神经预测力。在评估数千个 HCNN 架构的高通量计算实验中,三种参数筛选规则(随机、性能优化、IT 预测力优化)下架构的任务性能都与 IT 神经预测力显著正相关(图 4A),且仅凭性能优化(完全不使用神经数据)选出的最好模型就能预测 IT 数据,表现与直接针对 IT 优化的模型一样好(图 4C)。
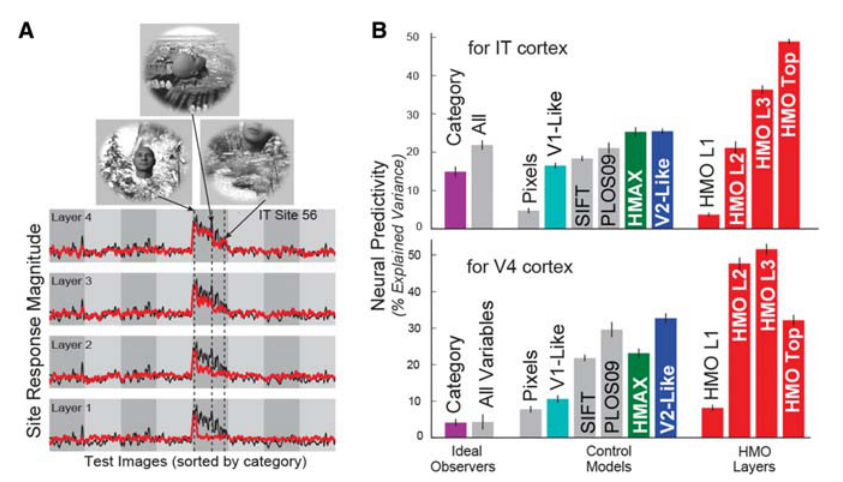
- HMO 模型的层级对位。表现最好的四层 HCNN(Hierarchical Modular Optimization 流程选出,1250 个顶层输出,称 HMO 模型)在含大量图像变化的任务上达到接近人类与 IT 群体的成绩,而 SIFT、V1 样 Gabor 模型、V2 样 Gabor 组合模型、HMAX 等对照在高变化条件下全部大幅落后(图 4B)。其顶层预测可解释 IT 单点反应方差的 48.5±1.3%(168 位点的中位数,图 5B),较此前最好模型有近一倍的提升,也显著高于拥有完美类别标签的理想观察者模型——说明 IT 神经元不是简单"分类器";中间层预测 V4 反应更佳(解释方差 51.7±2.3%,优于其顶/底层,图 5),为"V4 对应层级模型的中间层"提供了定量支持。
图注解读
图 1 · 把问题拆成编码与解码两环
原文图注:Figure 1. Encoding and decoding processes. We divide our efforts to understand visual information processing in the ventral stream into two goals. Goal one, called "encoding," is to model the transformation of the signal from a pixel-based representation in the retina to a high-level neural population representation that can support the demands of behavior in the face of low-level image variations (pose, location, etc.). Goal two, named "decoding," is to model the mechanisms that transform the population state of the neurons at the top of the ventral cortical stream into behavioral decisions.
这张开篇示意图把整篇文章的路线图画了出来:左端是视网膜像素表征,右端是行为报告,中间被切成两个可分别建模、证伪的目标——"图像 → 神经群体状态"(encoding)与"神经群体状态 → 行为"(decoding)。后文所有实验(64 项心理物理测试、被动注视电生理、光遗传/药理失活、HCNN 建模)都挂在这个二分框架的某个环节上。它本身没有数据,但提供了理解图 2–5 的坐标:图 2、图 3 属于解码,图 4、图 5 属于编码。
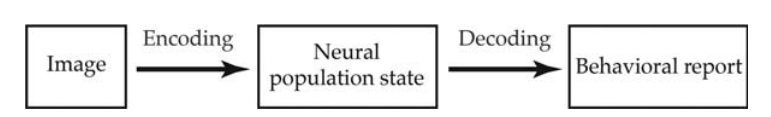
图 2 · 单一群体码解释全部人类识别行为
原文图注:Figure 2. A unified neuronal population code can explain human object recognition behavior. (A) We started with 3D models of real world objects (e.g., faces, cars) with multiple exemplars for each category. Given parameters (size, position, pose), we used ray tracing to render the object and place it on an uncorrelated background producing a test image. (B) We measured human performance for one eight-way basic-level object categorization (face, cars, planes, animals, tables, chairs, boats, fruits), and two subordinate eight-way identifications (cars: Beetle, BMW z3, Ford, etc.; faces: face1, face2, face3, etc.) and determined d0s for 384 tasks (24 labels × 6 levels of identity-preserving view variation). Heat map shows range of performance (high d0 = red). (C) We find that a single linking hypothesis (aka "unified code" or "decoding model") is sufficient to explain human core object recognition behavior, as showed by its statistically perfect consistency with the pattern of human performance. Only codes marked with asterisks are sufficient.
读法上是三段流水线:A 面板讲刺激如何造出来(3D 模型 + 光线追迹渲染 + 无相关背景);B 面板的热图把 384 个任务(24 标签 × 6 档变化的 d′)的红蓝分布铺开——有的任务很轻松、有的逼近机会水平,且难度模式跨被试高度一致;C 面板是判决图,列出各候选神经码的行为预测与实测人类成绩的一致性,只有打星号的码(IT 平均放电率的线性学习求和)达到"统计上完美一致"。这张图支撑主要结果第 1 条,也是全文"解码"主张的核心证据。
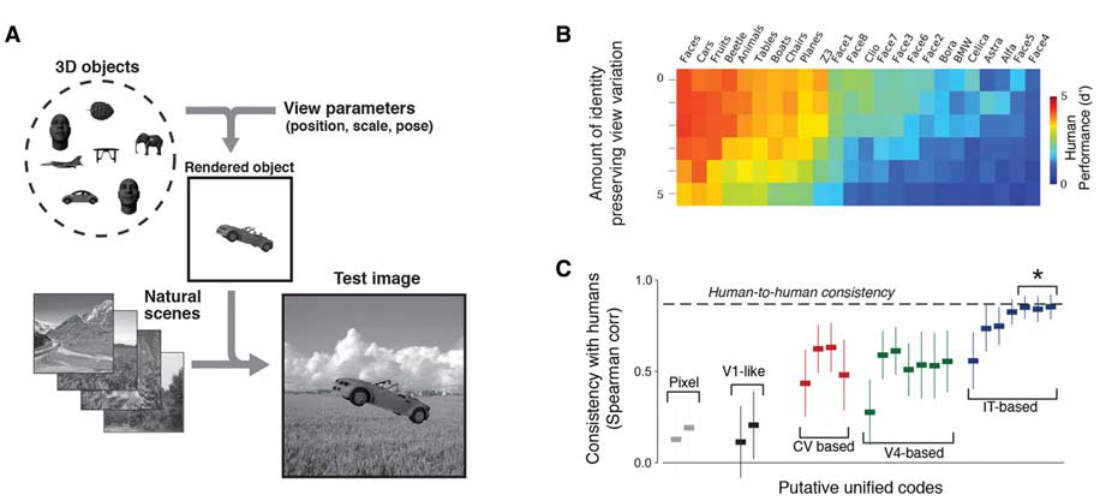
图 3 · 局部线性可分性预测失活的行为代价
原文图注:Figure 3. The effect of inactivation of different IT subregions on a gender discrimination task. Behavioral effect of optogenetic inactivation, averaged for small IT cortical subregions. The abscissa shows gender classification performance of a linear classifier trained and tested by multiunit recording data collected during the animals' passive fixation from each of the various subregions (≈1 mm) sampled from IT cortex. The ordinate shows the average impact of optogenetic inactivation of those same IT subregions on the animals' active behavior (gender discrimination task). (Adapted from Afraz et al. 2015.)
横轴是"被动多单元记录训出的线性分类器在性别分类上的成绩"(即该 1 mm 亚区对性别信息的可分性),纵轴是"同一亚区被光遗传失活后主动行为的平均降幅"。每个点对应一个 IT 小亚区,整体呈正相关:可分性越高,失活造成的行为损失越大;回归外推给出最高可分性亚区约 2.5% 的最大行为影响。这张图是主要结果第 3 条的直接证据,把"IT 表征离读出机制很近"从推理变成了由失活实验支持的因果陈述。
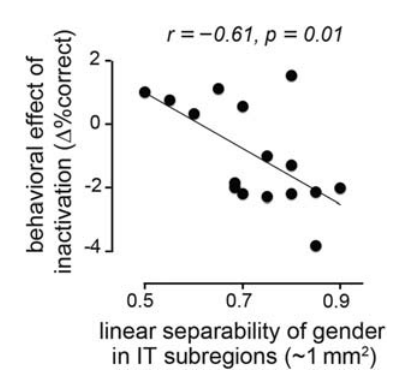
图 4 · 性能优化自动带来神经预测力
原文图注:Figure 4. Behavioral optimization yields neurally predictive models. (A) Object categorization performance versus IT neural explained variance percentage ("IT Predictivity") for hierarchical convolutional neural network (CNN) models in three independent high-throughput computational experiments (each point is a distinct neural network architecture). The x-axis shows performance (balanced accuracy, chance is 0.5) of the model output features on a high-variation categorization task; the y-axis shows the median single site IT explained variance percentage (n = 168 sites) of that model (i.e., the percentage of explainable response variance where response is defined as the mean IT firing rate 70–170 msec after image onset) computed on held-out test images. Each dot corresponds to a distinct model selected from a large family of convolutional neural network architectures (see text). Models were selected by random draws from parameter space (green dots), object categorization performance-optimization (blue dots), or explicit IT predictivity-optimization (red dots). (B) A high-performing neural network was identified that matches human performance on a range of recognition tasks, the hierarchical modular optimization (HMO) model. Object categorization performance results on the test images for eight-way object categorization at three increasing levels of object view variation (y-axis units are eight-way categorization percent correct; chance is 12.5%). IT (green bars) and V4 (hatched green bars) neural responses, and computational models (gray and red bars) were collected on the same image set and used to train support vector machine (SVM) linear classifiers from which population performance accuracy was evaluated. Human subject responses on the same tasks were collected via psychophysics experiments (black bars). (C) The object categorization performance versus IT neural predictivity correlation extends across a variety of models showing a wide range of performance levels.
A 面板散点图的横轴是模型在高变化分类任务上的 balanced accuracy(机会 0.5),纵轴是中位 IT 单点解释方差百分比(168 个位点,保留集上计算);绿/蓝/红点分别代表随机、性能优化、IT 预测力优化三种筛选,三种条件下性能与预测力都显著相关。B 面板换一个轴:同一批测试图像上,八分类正确率随物体视角变化递增的三档变化水平依次排列,HMO 模型(红柱)与人类(黑柱)和 IT 群体(绿柱)几乎重合,而 V4(斜纹绿柱)与其他对照模型(灰柱)明显落败。C 面板证明该相关不限于本次筛出的模型族,可推广到已发表模型。此图支撑主要结果第 4、5 条。
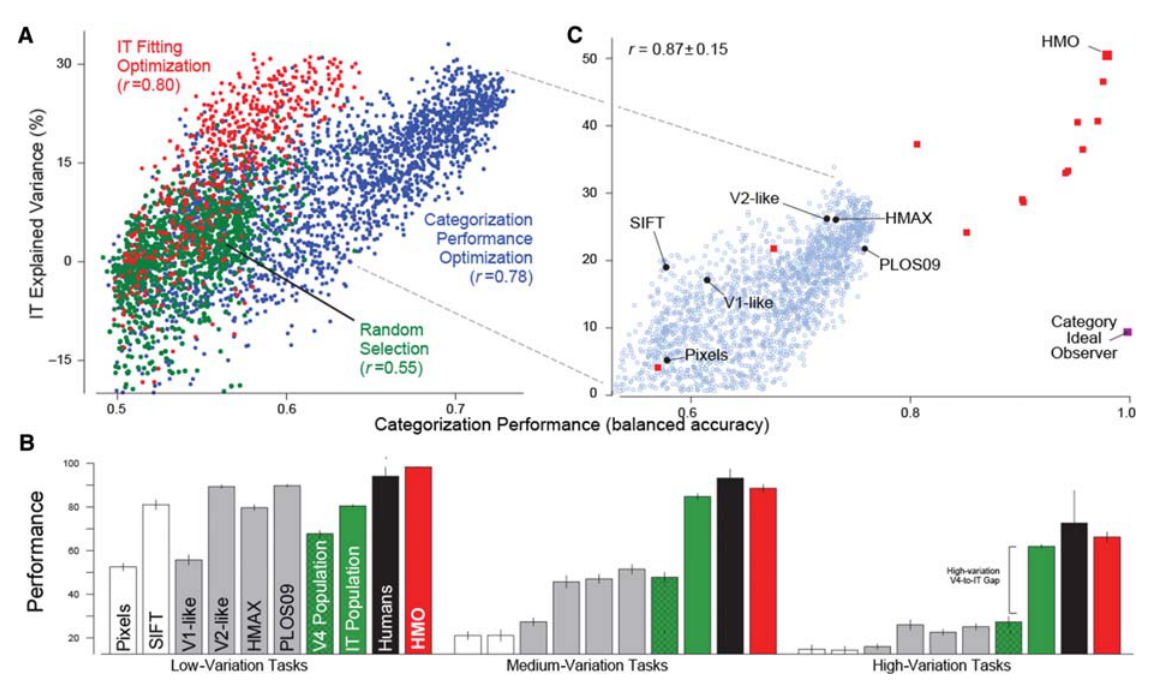
图 5 · 层级对位:顶层对 IT、中层对 V4
原文图注:Figure 5. Per-layer. (A) Actual neural response (black trace) versus model predictions (colored trace) for a face-selective IT neural site. The x-axis in each plot shows 1600 test images sorted first by category identity and then by variation amount, with more drastic image transformations toward the right within each category block. The y-axis represents the prediction/response magnitude of the neural site for each test image (those not used to fit the model). The four rows show neural predictions using the visual feature set (i.e., units sampled) from each of the four layers of the HMO model. (B) Comparison of IT and V4 neural explained variance percentage for various models. Bar height shows median explained variance, taken over all predicted IT units. (Modified from Yamins et al. 2014.)
A 面板逐层检验:对一个面孔选择性的 IT 位点,横轴是 1600 张测试图像(先按类别、再按变化幅度排序,类别块内越靠右变化越剧烈),四行分别是用 HMO 四层中各层的单元去预测该位点的反应,黑线是真实反应、彩线是预测。读图要点是预测随层数加深而逐层变好、且在第 4 层(顶层)能够跟上"类别块内随变化加剧仍维持的响应模式",呈现类别选择性与对变换容忍度逐层涌现。B 面板比较各模型对 IT 与 V4 反应的中位解释方差:顶层对 IT 最高(48.5±1.3%),中间层对 V4 更合适(51.7±2.3%),理想观察者语义模型对 V4 几乎不解释方差。这张图支撑主要结果第 5 条。
讨论
作者把两端模型拼成一个端到端的工作图景:编码端是一个前馈、高度复杂的多级非线性网络,它把隐含在输入中的信息(比如"不管在视野哪里、以何种姿态出现,这都是一辆车")显式化,使其对下游读出来说唾手可得;解码端正是那种下游读出机制的一个候选——把 IT 群体状态线性投影到行为选择。两者合起来给出核心物体识别的一个可量化机制模型。模型 largely 前馈的性质也带来一个重要推论:核心物体识别(单个中央物体的快速分类)主要靠腹视层级的单向级联支持,编码过程可能是持续自动运行、独立于行为状态的。作者对局限相当坦率:两个模型都只解释了相当一部分而非全部方差;相关与扰动研究都只覆盖任务的一个子集,不能排除某些图像或任务上模型失效;皮层异质性的起源(面孔神经元为何聚成多个互连斑块)与每区多层结构的功能意义未获解释;中间区域(V2、V4)调谐函数的定性刻画仍缺;最大空白是反馈回路在涉及记忆、学习、自上而下推理与长时程感觉运动整合的复杂视觉行为中的作用——作者认为出路在于"定量模型与大规模神经/行为数据采集之间的紧闭环"。与文献的对话上,文章站在 Hubel & Wiesel 简单/复杂细胞到 Serre 等前馈模型这条理论谱系上,直接对照 HMAX、SIFT、理想观察者模型等竞争者,并引用 Hung et al.(2005)证明 IT 群体可线性读出物体身份的经典结果作为解码端的先例。
一句话总结
我的阅读感受是:这篇文章的方法论示范意义超过了它的任何单个结论——"先找能 CTL 全部行为错误模式的读出模型,再用技术把_feedback 无关的皮层直接按下去看行为掉多少",把皮层神经科学与深度学习系在一起又严格保住因果性,是后来"编码—解码—扰动"范式的清晰样本。文中数字也值得记两个:IT 顶层模型解释约一半可解释方差(48.5%)却已是此前最好模型的双倍,而把一块皮层整个压掉 200 ms 只掉约 2% 的行为成绩——识别能力的冗余之大,与"线性读出就够"的幅度之大,同样出乎直觉,这两点是我基于本文数据的个人印象。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[A] - Fig5: 提取质量
good,对齐度full,识别面板[A, B]
关键事实与局限性声明
- 审校纠偏: {'issue_id': 'OVERCLAIM_001', 'severity': 'major', 'claim_classification': 'OVERCLAIM', 'md_section': '一句话定位;研究思路', 'current_text': '用光遗传学与药理学直接压制IT亚区可以因果性地验证这一解码模型', 'problem': '失活实验因果性地证明了IT活动参与至少一种面孔性别判别行为,并以“第一近似”把局部线性可分性连接到行为效应;它没有完整验证适用于全部识别任务的线性解码模型。', 'recommended_fix': '改为:失活实验建立了IT活动对面孔性别判别的因果作用,并为线性解码模型在这一任务中的局部预测提供了初步支持。'} -> 评注:
- 审校纠偏: {'issue_id': 'OVERCLAIM_002', 'severity': 'moderate', 'claim_classification': 'OVERCLAIM', 'md_section': '主要结果', 'current_text': '并直接排除了“行为难度由V4编码决定”等备择假说', 'problem': '数据只否定了研究中测试的V4候选神经码,不能排除所有可能的V4编码、非线性读出或涉及其他区域的机制。', 'recommended_fix': '改为:所有受检V4候选码均未达到解释人类行为难度模式的标准,因此不支持这些具体V4读出方案。'} -> 评注:
- 审校纠偏: {'issue_id': 'OVERCLAIM_003', 'severity': 'moderate', 'claim_classification': 'OVERCLAIM', 'md_section': '图注解读—图3', 'current_text': '把“IT表征离读出机制很近”从推理变成了由失活实验支持的因果陈述', 'problem': '失活对行为的影响是因果证据,但“IT表征接近线性读出机制”仍是根据跨亚区相关关系作出的解释,未被直接证明。', 'recommended_fix': '将两层结论分开:失活证明这些IT亚区对该行为具有因果贡献;局部可分性与失活效应的相关则与IT接近下游读出的解释一致。'} -> 评注:
- 审校纠偏: {'issue_id': 'OVERCLAIM_004', 'severity': 'minor', 'claim_classification': 'OVERCLAIM', 'md_section': '主要结果', 'current_text': '对上游区域(V1、甚至V4)应不会出现这种对应', 'problem': '作者的原文表述是预测这种相关在V1或V4中会“低得多”,并非断言完全不会出现。', 'recommended_fix': '改为:作者预测该相关在V1或V4等较低层级区域中会显著更弱,但本文没有直接检验这一预测。'} -> 评注:
- 补充要点: 局部线性分类指标基于每个约1 mm IT亚区内中位数约9个记录位点;这是解释图3预测精度和空间采样限制的重要信息。
- 补充要点: 应明确指出本综述没有报告人类心理物理被试数,也没有在正文中给出V4记录位点总数,不能据此补写样本量。
- 补充要点: 因果实验明确使用2只训练猕猴;V0方法部分没有为该实验单独报告这一数量,也不应默认它们与被动观看记录中的2只猕猴是同一批动物。
- 补充要点: 图3的跨亚区相关分析对应光遗传失活效应;muscimol结果支持面孔选择性IT亚区的因果作用,但没有被用于图3所示的局部线性可分性相关分析。