IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
281| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:passAstra裁决:compromise_revision(revise)
Deep neural networks rival the representation of primate IT cortex for core visual object recognition
Cadieu · PLoS Computational Biology · 2014 · Zotero itemID=2420
这篇文章做的事情很克制但分量极重:在恒河猴看 1960 张合成图像做七类物体识别的同时记录 V4 与 IT 皮层(inferior temporal cortex,IT)的群体活动,再用一套校正了采样量与噪声的"核分析"(kernel analysis)方法,把最新卷积深度神经网络(deep neural networks, DNNs)的表征性能与 IT 神经表征放到同一把尺子上。结论是 Zeiler & Fergus 2013 的 DNN 在解码性能上已经追平 IT 多单元表征,而 V1/V2 式模型与 HMAX 仍然远远落后。它是"深度网络能否作为灵长类腹侧流模型的争论"里第一份在性能、相似性与编码预测三个口径下同时成立的比较,今天读仍然能看到计算神经科学与深度学习合流的起点。
研究背景
灵长类能在单次注视(约 200–250 ms 一次眼跳)内对物体做出快速、准确的类别判断——作者将其操作化定义为"核心视觉物体识别"(core visual object recognition):在 100 ms 的简短呈现下,无视点移动、无上下文依赖地判断物体类别,即便物体实例、位置、尺度、姿态与背景同时变化。已知 IT 皮层是这个能力的神经载体:它把视网膜上纠缠的非线性识别问题转化为一个"类内聚拢、类间分离"的表征,以致线性分类器就能读出类别。与此同时,机器学习领域以 ImageNet竞赛为跑道涌现出一批深层卷积网络(Krizhevsky 2012、Zeiler & Fergus 2013 等),其架构可追溯到 Hubel–Wiesel 的简单/复杂细胞层级与 Fukushima 的新认知机,但层数更多(7–9 层 vs 旧模型 3–4 层)且在数百万标注图像上做监督训练。
问题是:这些 DNN 的"表征性能"究竟追没追平 IT?此前的比较存在四个系统性缺陷:既没有校正实验噪声、记录位点数与训练样本量的限制,也没有处理"分类器复杂度与决策边界精度"的混淆;只考察了与任务无关的表征相似性而未测绝对性能;图像集太小(以往仅 150–96 张),变化范围不足以把模型彼此区分开。缺一个统一、公平的度量,是本文要填的洞。
研究思路
作者的逻辑分三步。第一步,构造一个"足够难"的任务:图像由 POV-Ray 用 3D 模型合成,7 个类别 × 每类 7 个实例 × 每实例 40 张独创背景的图像,变化参数覆盖两个八度的尺度、全画幅平移与全球面姿态,共 1960 张;前面工作已证明这种高变化 regime 下 V1/V2 式模型几乎归零,从而保证测量有区分力。第二步,为了让"模型 vs 大脑"的对比公平,对模型做两件事:把模型特征下采样到与神经记录相同的位点数(多单元 80、单单元 40),并按从神经数据估计的速率依赖加性噪声模型给模型表征加上与之匹配的噪声——因为模型无噪声而神经记录有噪声,不加校正就是自欺。第三步,不只比较单一指标,而是三管齐下:核分析刻画的解码性能(任务导向)、对 IT 多单元反应的编码模型预测(encoding model)、以及物体级表征相似性分析(representational similarity analysis, RSA),三者互补——解码性能高不等于能解释 IT 的全部可解释方差。
方法
神经数据来自两只成年雄性恒河猴被动注视任务,每猴三个慢性植入的微电极阵列(BlackRock),两猴合计 IT 168 个多单元位点、V4 128 个。图像呈现在 LCD 屏中央、直径 8°、100 ms,后接 100 ms 灰屏,眼动超过 ±2° 的试次剔除,每只动物每张图累积 47 次重复。神经表征的构造:对每个位点计数刺激起始后 70–170 ms 的尖峰,减去灰屏背景放电,按整块图像响应的标准差归一化,再对重复取平均,得到"位点 × 图像"矩阵。单单元由多单元数据经亲和传播聚类分选而出(IT 160 个、V4 95 个、各 6 次重复),再按在另一独立 280 图像集上的跨试次一致性(信噪比)挑出最高的 40 个用于分析。
模型表征共 6 个:V1-like(Gabor 小波集合,86400 维)、V2-like(Gabor 输出的非线性组合,24316 维)、HMAX(稀疏局部特征,4096 维、两层)、HMO(Yamins 等 2014 的层级模块化优化网络,1250 维、四层)、Krizhevsky 等 2012 的 SuperVision(倒数第二层 4096 维特征)与 Zeiler & Fergus 2013(倒数第二层 4096 维特征在 10 个裁剪上平均;文中层数计数有一处作 8 层、一处作 7 层)。核分析用高斯核岭回归:复杂度定义为正则参数的倒数 1/λ(在 10^-4 到 10^3 间取 56 个对数间隔值),精度定义为 1 减归一化留一泛化误差(0 为随机水平、1 为完美);核宽 σ 在每档 λ 下于中位距离的 0.1–10 倍范围内优化;图像集随机重抽 10 次以估计波动。噪声匹配按"方差与均值线性相关"的泊松式噪声模型,从经验数据拟合参数(多单元 a=0.14、b=0.92;单单元 a=0.76、b=0.71),加到缩放后的模型表征上,重复 10 次。补充验证表明该噪声模型比经验噪声更保守,即对模型的惩罚偏严。另以线性 SVM(80%/20% 交叉验证,重复 10 次,随机水平约 14.3%)复验,并用 ridge 回归编码模型预测 IT 各位点反应(以 Spearman–Brown 校正的 split-half 一致性定义"可解释方差",汇报其中位数)。
主要结果
- 任务确实难,且新 DNN 显著优于旧模型:在核分析的精度—复杂度曲线上,V1-like 与 V2-like 在全部复杂度区间几乎贴着 0,HMAX 只略好一点;三个 DNN 大幅领先,排序为 Zeiler & Fergus 2013 > Krizhevsky 2012 > HMO(图 2)。
- 校正采样与噪声后,DNN 追平 IT(多单元口径):各表征统一到 80 个样本、加匹配噪声后,IT 多单元样本的精度很高,只有 Zeiler & Fergus 2013 能与之匹配;三个 DNN 都显著高于 V4 神经样本;不给校正时模型最高精度超过 0.5,校正后不超过 0.35,可见校正的威力(图 3A、图 4A,样本数在 10–160 间改变时关系稳健)。
- 单单元口径下 DNN 有余:40 个样本与特征的比较中,IT 单单元表征好于 HMO、略逊于 Krizhevsky 2012,而被 Zeiler & Fergus 2013 超过;将主要结果3中关于单单元的前两句合并为:在样本数与噪声匹配、均使用40个单元或特征时,IT 单单元表征优于 HMO,略逊于 Krizhevsky 2012,并被 Zeiler & Fergus 2013 超过(图3B)。改变采样数后,以核分析曲线下面积衡量,Krizhevsky 在较少位点/特征时与 IT 相当,在较多位点/特征时略超 IT;Zeiler & Fergus 则在所测采样数范围内均超过 IT(图4B)。。线性 SVM 复验给出同样的格局:IT 多单元样本的高泛化精度(随机水平约 14.3%)只有 Zeiler & Fergus 2013 能匹配(图 5)。
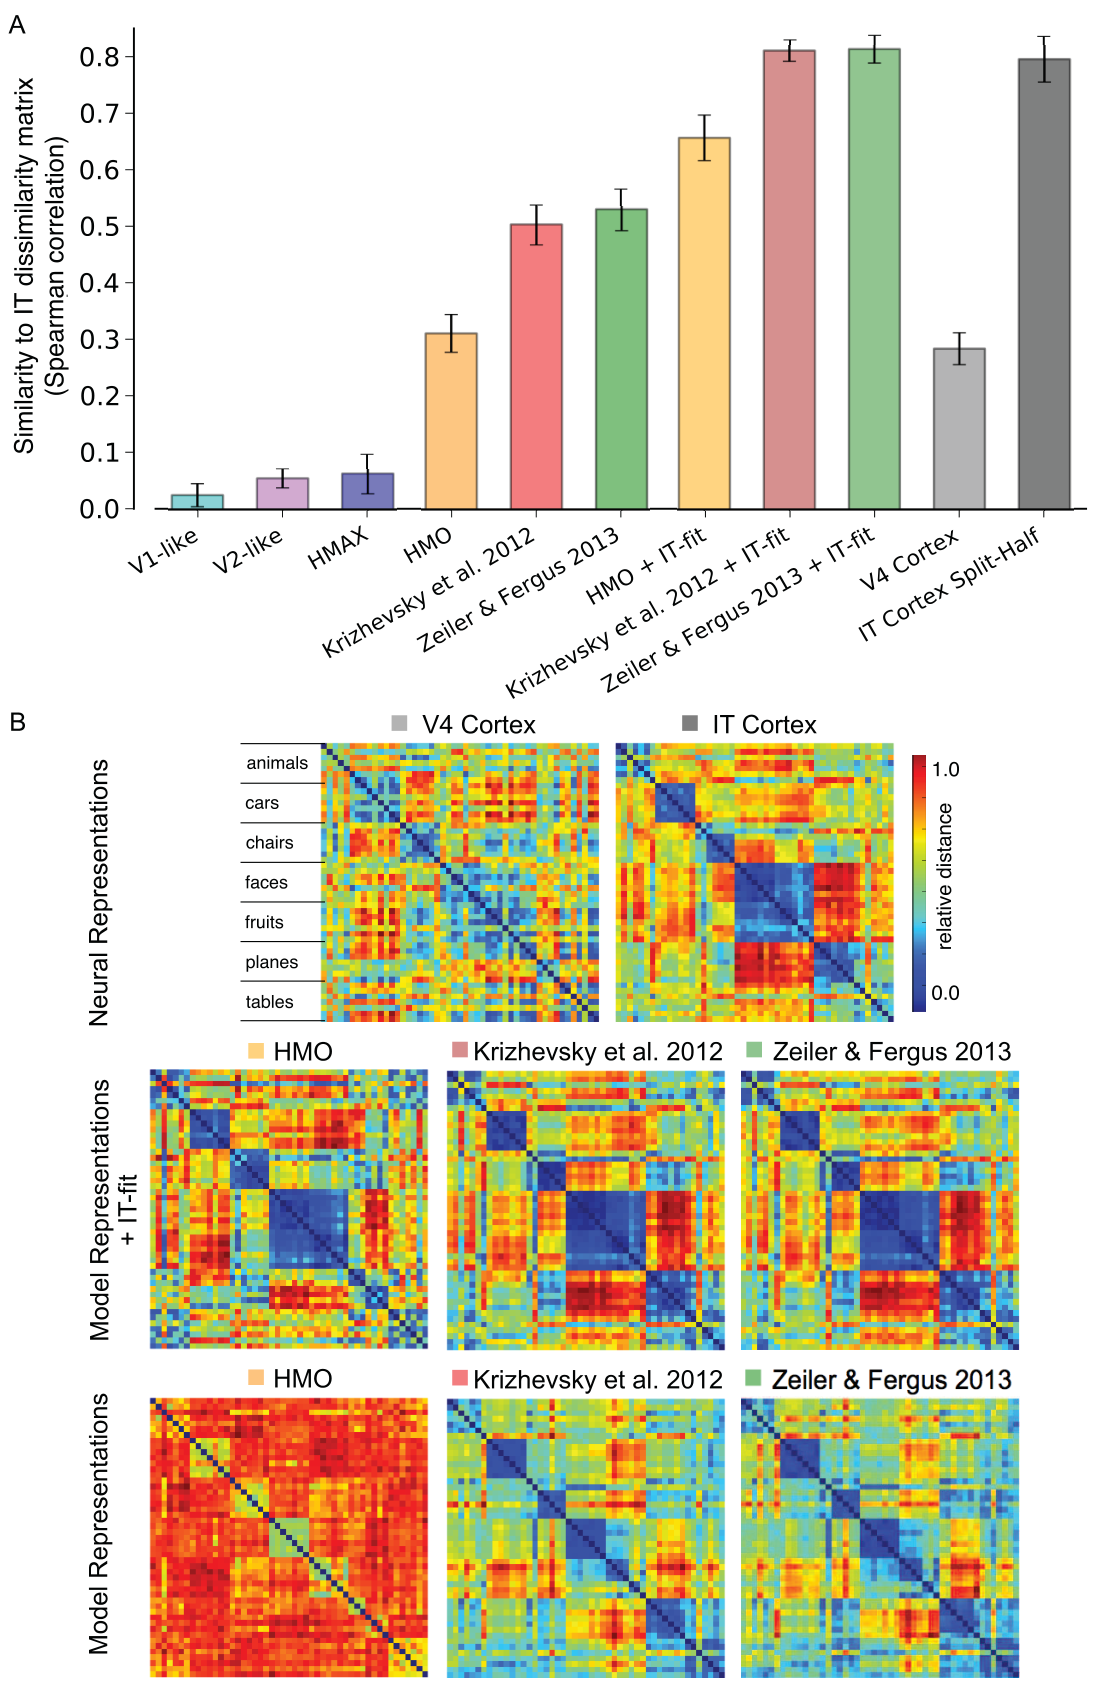
- 但编码与相似性口径下仍有差距:用模型特征做岭回归预测 IT 多单元反应,HMO、Krizhevsky、Zeiler & Fergus 的中位可解释方差与用 V4 预测 IT 的水平相当,却没有任何模型能涵盖 IT 的全部可解释方差(Zeiler & Fergus 漏掉的超过 40%);预测能力与 V4 相关较弱(r=0.48),而 DNN 彼此之间高度相关(Krizhevsky–Z&F r=0.96),提示 V4 与 DNN 各自解释了 IT 方差的不同来源(图 6)。物体级 RDM(49×49)的 Spearman 相关显示 V1/V2-like 与 HMAX 同 IT 高度不相似,HMO 与 V4 相当,Krizhevsky 与 Z&F 介于 V4 和 IT split-half 噪声限之间;只有在把特征线性映射到 IT 反应(+IT-fit)之后,两个 ImageNet DNN 才落入 split-half 噪声限内(图 7)。
- 有趣的副产品:行为上人类 100 ms 的准确率已达 2000 ms 的 92%;总体性能上人类(85% 平均准确率)仍高于当时 DNN(77%),且个体差异大;"信封估算"表明模型处理时间已可与灵长类反应时间竞争,但能耗高出 2–3 个数量级。
图注解读
图 1 · 任务图像示例
原文图注:Fig. 1. Example images used to measure object category recognition performance. Two of the 1960 tested images are shown from the categories Cars, Fruits, and Animals (we also tested the categories Planes, Chairs, Tables, and Faces). Variability within each category consisted of changes to object exemplar (e.g. 7 different types of Animals), geometric transformations due to position, scale, and rotation/pose, and changes to background (each background image is unique). doi:10.1371/journal.pcbi.1003963.g001
直观展示 1960 张合成图像的构成:Cars、Fruits、Animals 三类的各两张样例,类内变化来自实例更换、位置/尺度/旋转姿态的几何变换与独一无二的背景。读图关键是体会"变化凶狠到什么程度"——同一张背景只用一次,物体与背景统计上脱钩,这正是能够让 V1/V2 式模型归零、把模型彼此拉开的高难度来源,支撑主要结果 1 的前提。
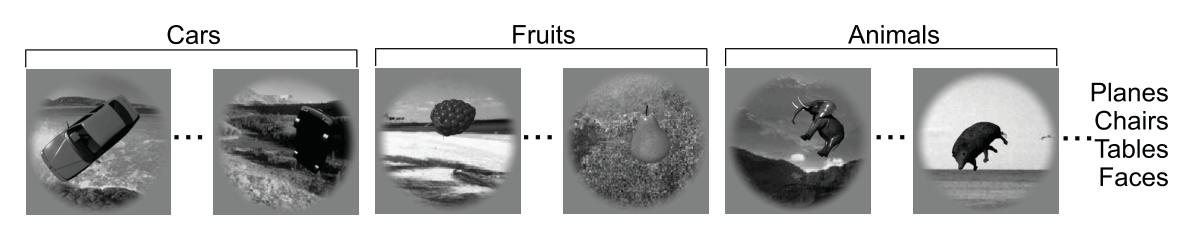
图 2 · 六个模型表征的核分析曲线
原文图注:Fig. 2. Kernel analysis curves of model representations. Precision, one minus loss (1{looe(l)), is plotted against complexity, the inverse of the regularization parameter (1=l). Shaded regions indicate the standard deviation of the measurement over image set randomizations, which are often smaller than the line thickness. The Zeiler & Fergus 2013, Krizhevsky et al. 2012 and HMO models are all hierarchical deep neural networks. HMAX [41] is a model of the ventral visual stream and the V1-like [35] and V2-like [42] models attempt to replicate response properties of visual areas V1 and V2, respectively. These analyses indicate that the task we are measuring proves difficult for V1-like and V2-like models, with these models barely moving from 0.0 precision for all levels of complexity. Furthermore, ……(后略:HMAX 仅略好,三个 DNN 大幅领先且 Zeiler & Fergus 2013 全程最佳)
横轴是复杂度 1/λ(从左到右决策函数从线性到逐点插值),纵轴是精度(1 减留一误差),阴影为图像集随机化的标准差。读图要点是曲线的"整体高度"而非单点:V1-like 与 V2-like 全程贴零说明任务对早期视觉模型不可解;DNN 曲线整体抬高、且在低复杂度(强正则、少训练样本)端也高,说明它们把类别相关方差挪进了表征空间的低维主方向。此图为全文立基准,对应主要结果 1。
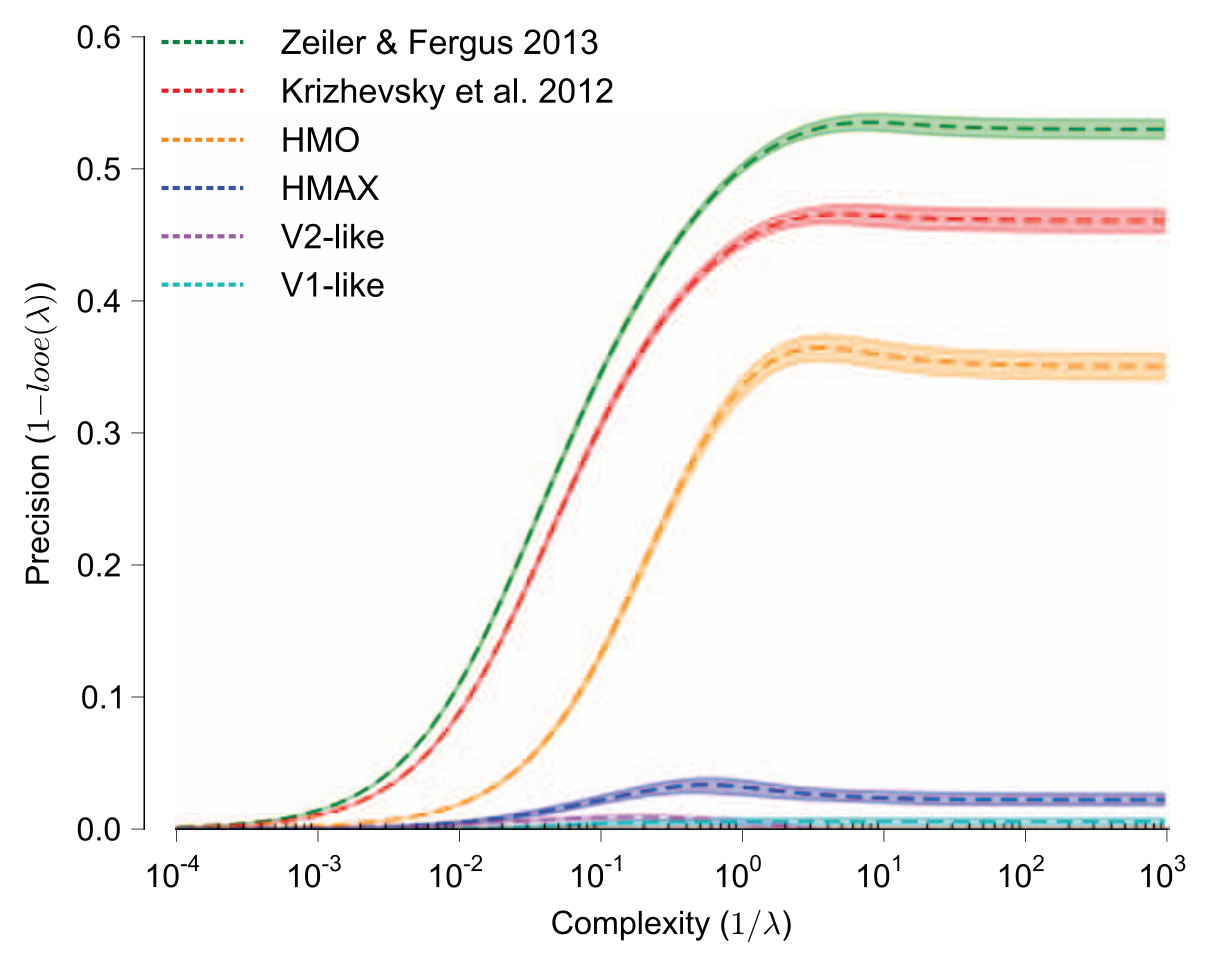
图 3 · 样本与噪声匹配后的神经—模型对比
原文图注:Fig. 3. Kernel analysis curves of sample and noise matched neural and model representations. Plotting conventions are the same as in Fig. 2. Multi-unit analysis is presented in panel A and single-unit analysis in B. Note that the model representations have been modified such that they are both subsampled and noisy versions of those analyzed in Fig. 2 and this modification is indicated by the { symbol for noise matched to the multi-unit IT cortex sample and by the { symbol for noise matched to the single-unit IT cortex sample. To correct for sampling bias, the multi-unit analysis uses 80 samples, either 80 neural multi-units from V4 or IT cortex, or 80 features from the model representations, and the single-unit analysis uses 40 samples. To correct for experimental and intrinsic neural noi ……(后略:所有模型校正后精度下降;三个 DNN 显著好于 V4;A 中 IT 仅被 Z&F 2013 匹配,B 中 Krizhevsky 与 Z&F 超过 IT)
这是全文的主结果图。A 面板(80 个多单元位点/特征):IT 实测曲线高居顶部,V4 明显更低,HMAX/V1/V2 式模型贴零,三个 DNN 中只有 Zeiler & Fergus 2013 与 IT 曲线重合。B 面板(40 个单单元/特征,噪声更大):IT 单单元曲线整体下移,被两个 ImageNet DNN 超越。读图时注意图注中的花括号符号表示"加噪匹配"——直接与图 2 对比就能看到校正把模型精度整体压低,可见前人不做校正会怎样高估模型。对应主要结果 2、3。
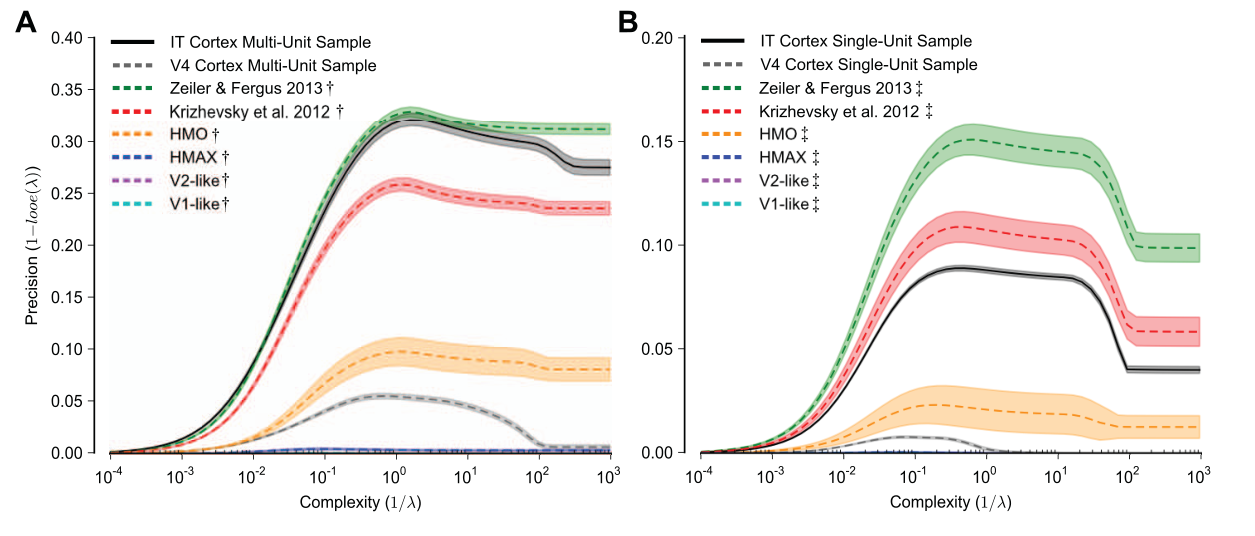
图 4 · 性能随采样数变化的面积指标
原文图注:Fig. 4. Effect of sampling the neural and noise-corrected model representations. We measure the area-under-the-curve of the kernel analysis measurement as we change the number of neural sites (for neural representations), or the number of features (for model representations). Measured samples are indicated by filled symbols and measured standard deviations indicated by error bars. Multi-unit analysis is shown in panel A and single-unit analysis in B. The model representations are noise corrected by adding noise that is matched to the IT multi-unit measurements (A, as indicated by the { symbol) or single-unit measurements (B, as indicated by the { symbol). For the multi-unit analysis, the Zeiler & Fergus 2013 representation rivals the IT cortex representation over our measured sample. For t ……(后略:单单元分析中 Krizhevsky 在低特征数追平、高特征数略超 IT,Z&F 全程超 IT)
把图 3 的整条曲线压缩成面积(KA-AUC)后随样本数(10–160)重画。实心符号为实测值、误差棒为标准差。读图要点:80 样本处见到的"IT 与 Z&F 并驾、两者均高于 Krizhevsky 再高于 HMO/V4"的格局在全部采样数上稳定成立,说明结论不是某个采样量的偶然,同时呈现了曲线之间的"追赶/反超"交叉关系(单单元口径下 DNN 随特征数上升越过 IT)。支撑主要结果 2、3 的稳健性。
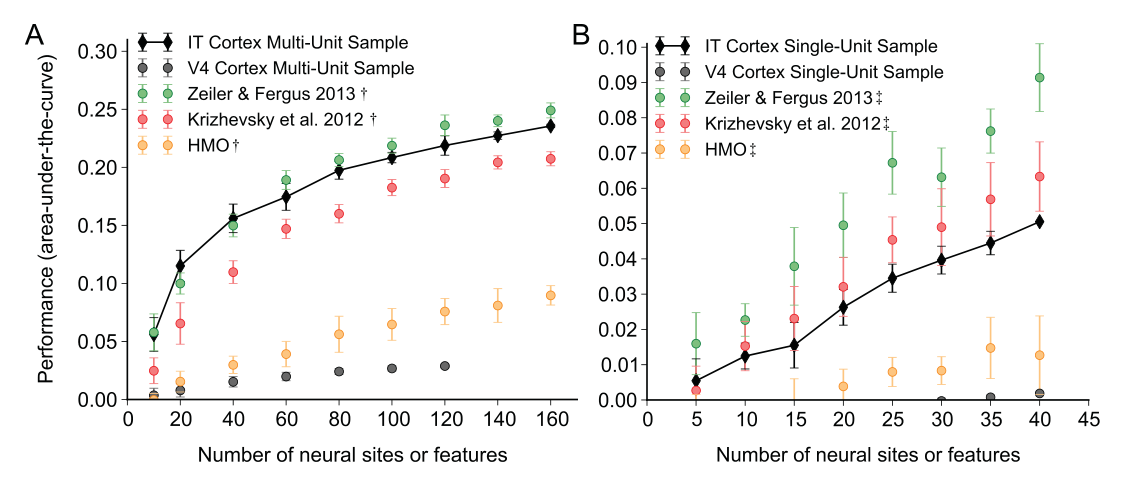
图 5 · 线性 SVM 泛化性能的复验
原文图注:Fig. 5. Linear-SVM generalization performance of neural and model representations. Testing set classification accuracy averaged over 10 randomly-sampled test sets is plotted and error bars indicate standard deviation over the 10 random samples. Chance performance is ,14.3%. V4 and IT Cortex Multi-Unit Sample are the values measured directly from the neural samples. Following the analysis in Fig. 3A, the model representations have been modified such that they are both subsampled and have noise added that is matched to the observed IT multi-unit noise. We indicate this modification by the { symbol. Both model and neural representations are subsampled to 80 multi-unit samples or 80 features. Mirroring the results using kernel analysis, the IT cortex multi-unit sample achieves high generat ……(后略:IT 多单元样本的高泛化精度仅被 Z&F 2013 匹配)
横轴并排各表征、纵轴测试集分类准确率(柱状),随机水平约 14.3%。模型同样先降采样到 80 特征再加匹配噪声,故柱高整体低于其原始性能。读图要点:柱状的排序与图 3A 完全一致,证明核分析的结论不依赖于特定核方法的实现——不管是非线性核岭回归还是简单线性边界,IT 与 Zeiler & Fergus 2013 都并肩居首。对应主要结果 3 和"复验"环节。
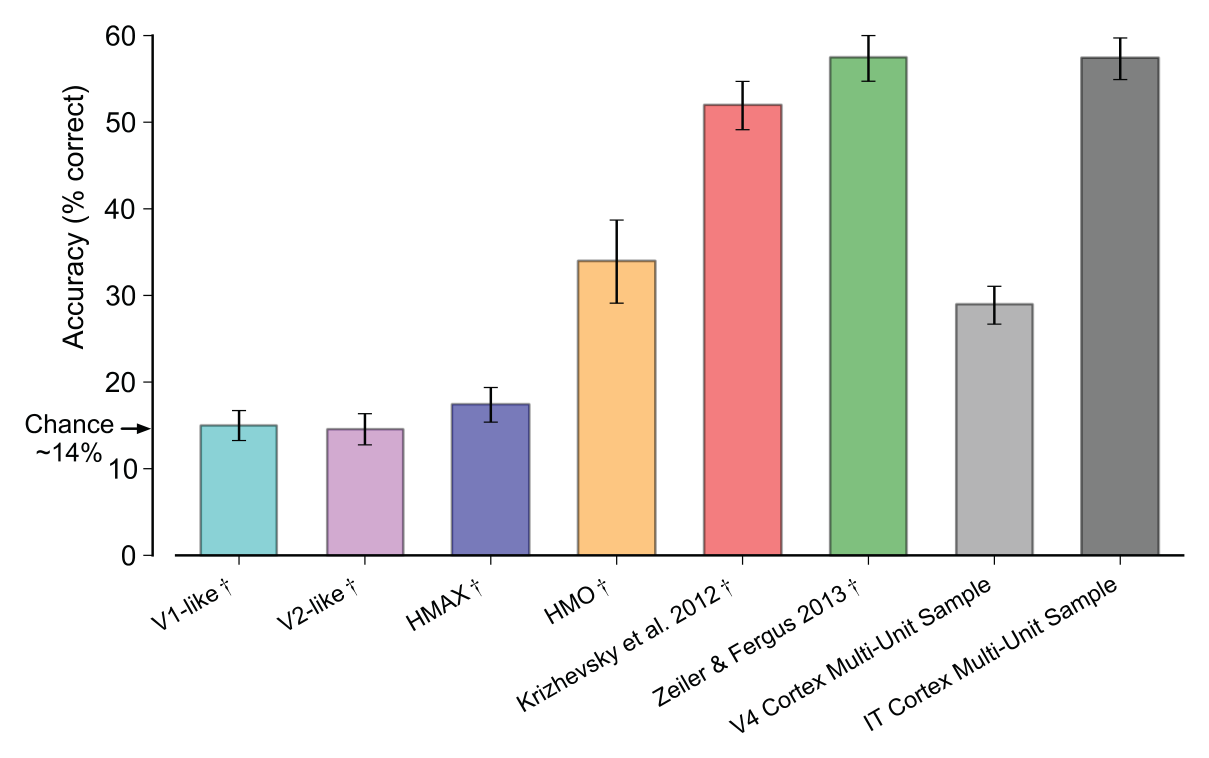
图 6 · 模型与 V4 对 IT 反应的编码预测
原文图注:Fig. 6. Neural and model representation predictions of IT multi-unit responses. A) The median predictions of IT multi-unit responses averaged over 10 train/test splits is plotted for model representations and V4 multi-units. Error bars indicate standard deviation over the 10 train/test splits. Predictions are normalized to correct for trial-to-trial variability of the IT multi-unit recording and calculated as percentage of explained, explainable variance. The HMO, Krizhevsky et al. 2012, and Zeiler & Fergus 2013 representations achieve IT multi-unit predictions that are comparable to the predictions produced by the V4 multi-unit representation. B) The mean predictions over the 10 train/test splits for the V4 cortex multi-unit sample and the Zeiler & Fergus 2013 DNN are plotted against each ……(后略:逐位点比较)
A 面板:以模型特征做岭回归预测每个 IT 位点对 1960 张图的反应,汇报经试次间变异性校正的中位"可解释方差百分比",并于 V4 预测 IT 作对照——三个 DNN 达到与 V4 相当的预测水平,但没有一个模型穷尽全部可解释方差。B 面板逐位点画 V4 预测与 Z&F 预测的平均解释方差,两者相关仅 r=0.48(而两个 DNN 之间 Krizhevsky–Z&F 达 r=0.96、HMO–Z&F 达 0.74),说明 V4 与 DNN 捕捉的是 IT 变异的不同来源。这张图是"性能追平≠机制等同"论点的关键证据,对应主要结果 4。
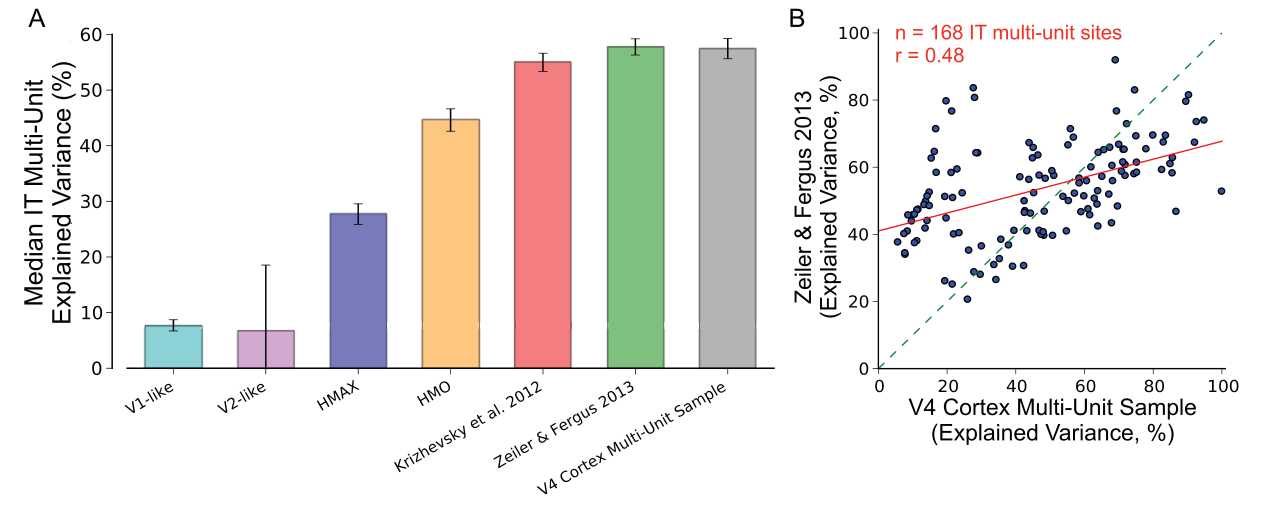
图 7 · 物体级表征相似性分析
原文图注:Fig. 7. Object-level representational similarity analysis comparing model and neural representations to the IT multi-unit representation. A) Following the proposed analysis in [32], the object-level dissimilarity matrix for the IT multi-unit representation is compared to the matrices computed from the model representations and from the V4 multi-unit representation. Each bar indicates the similarity between the corresponding representation and the IT multi-unit representation as measured by the Spearman correlation between dissimilarity matrices. Error bars indicate standard deviation over 10 splits. The IT Cortex Split-Half bar indicates the deviation measured by comparing half of the multi-unit sites to the other half, measured over 50 repetitions. The V1-like, V2-like, and HMAX represent ……(后略:HMO 与 V4 相当、两个 ImageNet DNN 介于 V4 与 IT split-half 之间;B 面板展示选代表征的 RDM)
A 面板柱状图给出各表征的 49×49 物体级不相似度矩阵(RDM)与 IT RDM 的 Spearman 相关,IT 自身的 split-half 相关充当"噪声天花板":V1/V2-like 与 HMAX 高度不相似,HMO 与 V4 相当,两个 ImageNet DNN 落在 V4 与天花板之间;加上"先用模型线性预测 IT 反应再重构 RDM"(+IT-fit)后,Krizhevsky 与 Z&F 进入噪声限内。B 面板按类别排序展示选代表征的 RDM 图样。读图要点:即使解码性能追平,原始 DNN 特征与 IT 的 RDM 仍有一段未被噪声解释的差距——作者据此在结果与讨论中一致承认"按物体级相似性衡量,DNN 与 IT 之间仍有差距",这正好修饰了标题的"rival",对应主要结果 4。
讨论
作者把结果放在两个坐标轴上解释。第一,与既往模型的差距是实质性的:V1/V2-like 与 HMAX 在这个高变化的任务上几乎无可作为,而三个 DNN(其计算概念——简单/复杂细胞层级、max-pooling、权值共享、反向传播——都可追到早期视觉模型文献)经采样与噪声校正后达到与 IT 多单元表征可以比较的水平;这确证了"深度层级 + 监督优化"这条路在表征性能上首次无可争议。第二,作者明确划出了结论的边界:三个口径不完全一致——解码性能上 Z&F 与 IT 打平,编码与相似性上仍留有未被解释的 IT 方差(甚至 V4 对 IT 的预测与 DNN 的预测弱相关,暗示 V4 把握的是与刺激派生变量无关的内在神经动态);标题的"rival"因此只对性能口径成立,机制是否相同则"尚不能仅凭表征性能排除"。此外还诚实交代:100 ms 单一呈现时长的选择有行为与生理依据但偏保守;合成图像不涵盖光照、纹理、遮挡等真实世界变化;猴子被动观看而人类做主动任务;记录位点映射为特征的方式只是"最简第一选择";以及多单元反而优于单单元这一反直觉现象(S5 图:校正试次后多单元仍占优,按单位估计的性能约 5 倍于全部单单元样本),作者猜测多单元的局部平均起到了契合该任务的正则化作用,并由此推想皮层拓扑组织可能就是读出时的天然正则化来源。
与文献的对话同样清晰:本文直接扩展了 Yamins 等 2014(HMO 与 IT 的 RDM 匹配、可预测 IT 反应)但把比较升级为绝对性能;方法论上呼应 Kriegeskorte 的 RSA 框架而补上其缺失的精度—复杂度维度;并与 Hung 2005、Rust & DiCarlo 2010 等线性解码传统接轨。对人类行为(85%)与 DNN(77%)的差距,作者推断人类仍领先,即便允许人类受训也只会更高。
一句话总结
这篇的方法论遗产比结论本身更长久:把"模型像不像大脑"拆成采样、噪声、分类器复杂度三笔账再比较,后来几乎所有 brain–DNN 对齐论文都在还这笔账。我读下来最大的感受是标题的"rival"取得相当克制——真正无争议的只有解码口径,RDM 与编码方差里那 40% 的缺口,以及 V4 与 DNN 各说各话的相关结构,都在提醒我们性能等价离机制等价还差得远;作者在 2014 年就把这条边界划得这么清楚,坦率得让人放心。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[A, B] - Fig4: 提取质量
good,对齐度full,识别面板[A, B] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[A, B] - Fig7: 提取质量
good,对齐度full,识别面板[A]
关键事实与局限性声明
- 审校纠偏: 无实质性过度推论。MD 对「rival」的边界处理与原文一致:解码口径追平、编码/RSA 口径仍有差距、机制等价未被确立;未发现相关被夸大为因果的情况(V4 与 DNN 预测弱相关 r=0.48 被正确表述为「提示解释不同方差来源」,与原文推测性语气一致)
- 补充要点: 人类行为测量通过 Amazon Mechanical Turk 完成(S2 Fig 的方法细节),MD 只引用了结果(100 ms 达 2000 ms 的 92%、85% vs 77%)未提测量平台,属可接受的省略但可补一句
- 补充要点: V2-like 表征的 IT 编码预测不稳定、方差过大(Methods 末尾明确交代),属负结果/方法学警示,MD 未提
- 补充要点: 图像生成中「背景偶尔碰巧与物体相关(如飞机配天空)但多数不相关」的细节,MD 只说「统计上脱钩」,基本等效,非必须