IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
256| 原始基线:V0_ZCODE_BASELINE| 语义审核:minor_revision| 图表审核:pass
Firing rate distributions and efficiency of information transmission of inferior temporal cortex neurons to natural visual stimuli
Treves · Neural Computation · 1999 · Zotero itemID=2332
这篇文章用猕猴下颞叶皮层(inferior temporal cortex, IT)神经元在准自然视觉刺激下的放电记录,系统检验了一个流行假说:感觉神经元的放电率分布是指数分布,因为指数分布在固定平均放电率下熵最大、信息传输最"划算"。作者发现指数模型在 84% 的情况下必须被统计拒绝,而他们提出的"慢+快"(S+F)变异性模型——一个不依赖任何优化原则的生成式模型——只在 16% 的情况下被拒绝;再直接测量信息传输效率,得到中等的 0.5–0.7,远未达到最优。这是一篇把"有效编码"叙事拉回地面的典范之作:形状像指数,不等于为指数而设计。
研究背景
大范围自然刺激下单神经元的放电率分布(firing rate distribution)有一个相当普遍的经验形态:连续渐变(graded)、单峰(unimodal,峰常在零或自发放电率附近)、尾部近似指数(exponential tail)。这一形态不限于视觉皮层,额叶皮层、海马及相关结构都有报道,甚至在形式神经网络分析中被当作真实分级放电率分布的一阶近似。它在感觉皮层引起特别兴趣,源于 Shannon 1948 年的一个定理:在固定平均计数的约束下,指数分布使放电计数分布的熵(entropy)最大化。Levy & Baxter(1996)和 Baddeley(1996)等人据此提出,神经元之所以趋向指数分布,是因为在给定的代谢"预算"(平均放电率)下它能携带最多的信息——即分布形状本身就是代谢效率优化的产物。
但这条推理链有两个明显的缺口。其一,无噪声条件下最大化信息的分布在有噪声时是否仍最优,文章直言"dubious";而且在别的合理假设下,完全不同的分布也可以是最优的——例如二值(binary)分布才使有噪声脉冲码对慢变刺激的信息传输率最大。其二,存在一整类不诉诸优化的替代解释:放电是许多突触输入电流涌入胞体后经阈值线性整流(threshold-linear rectification)的产物,若输入弱相关,中心极限定理给出近似高斯的电流分布,于是放电计数应近似截断高斯分布(truncated Gaussian distribution)再加一个零峰;若快变异性主导,则接近泊松分布(Poisson distribution)。这些简单模型虽然都被人提出过,却没有人在接近自然视觉的刺激条件下被定量地逐一检验过——用什么分布描述数据、又为什么是这个分布,在当时是悬而未决的。
研究思路
作者的策略是"先把候选模型写成显式概率分布,再用拟合优度检验逐个裁决"。关键的一步是构造出一个有生理含义的替代模型:S+F 随机模型。它把驱动神经元的激活变量(流入胞体的电流)的涨落拆成两个都近似正态分布的成分——"慢"变异(时间尺度长于计数窗口,可粗略对应不同刺激/场景带来的平均电流差异)与"快"变异(时间尺度短于窗口,对应窗口内噪声)——再让电流经阈值线性变换转成放电率,对快噪声积分后得到放电计数分布。逻辑链很清楚:如果指数模型拟合差、而 S+F 拟合好,那么指数尾巴就只是"高斯输入 + 阈值 + 快噪声"的机械后果,不需要用最大熵或最大效率来解释;随后再用信息论指标直接测效率,检验神经元是否真的接近最优。
实验设计上刻意用了两种非常不同的呈现方式做交叉验证:自由观看连续视频(无注视约束,逼近自然观看行为),以及大量静态自然图像的重复呈现(注视任务,便于计算互信息)。若两种模式下放电计数分布的形态和模型检验结论一致,就能排除"分布形状是某种特定刺激呈现方式的伪迹"这一质疑。
方法
电生理记录取自两只恒河猴(ay、ba)上颞沟前部(anterior superior temporal sulcus, aSTS)皮层的 15 个面孔选择性(face-selective)神经元——筛选标准是对最有效面孔刺激的反应至少是对最有效非面孔刺激的两倍。记录期间猴子观看一段 5 分钟无剪辑的日常实验室场景视频(含房间、设备、日常见到的人和猴,约 30% 时长内画面含面孔),不要求保持注视;同一细胞多次放映视频可形成多个数据集,共得 22 个数据集(ay 20 个、ba 2 个),且明确说明各次观看时猴子不要求行为一致。第二套数据来自另一只猴(am)的 14 个 IT 面孔选择性神经元:65 张静态自然图像(23 张面孔、42 张非面孔)在注视任务下重复呈现,每次 500 ms,每细胞 380–600 试次。
分析时把记录时间切成不重叠的窗口并数每窗口的 spike 数构建概率直方图:视频数据用 L = 50、100、200、400、800 ms 五档窗口,静态数据用 L = 50、100、200、400 ms(从刺激起始后 100 ms 起)。模型与数据的吻合用卡方拟合优度检验(χ² goodness-of-fit test,含 Yates 连续性校正,p < 0.01 判拒绝)评估。指数与泊松模型只有一个自由参数(平均放电率,直接由数据读出,不靠最小化 χ²);截断高斯有两个(慢变异幅度 σS 与平均激活减阈值之差 h₀,靠最小化拟合);S+F 有三个(h₀、σF、σS),且对视频数据在五个窗口上同时拟合、h₀ 跨窗口取同值——作者特意如此,以免 h₀ 沦为每个尺度各有一个、可被过拟合操纵的无意义参数。效率分析用每脉冲信息量(information per spike,文中符号在 PDF 提取中显示为 Â):即信息随时间传输速率除以平均放电率,只依赖对各刺激的平均响应而不依赖响应围绕均值的涨落分布;再除以同稀疏度(sparseness)分布族中的理论最大值 log₂(1/a),得到 0 到 1 之间的编码效率 η。改为:短时近似对全部细胞在25–40 ms内与直接互信息高度一致,对部分低放电率细胞可延伸至50–100 ms;更长窗口中的每脉冲信息量可近似估计初始信息传输率,但线性互信息近似本身会因饱和而逐渐失准。
主要结果
- 四个简单模型里只有 S+F 站得住。视频数据的 110 个拟合(22 数据集 × 5 窗口)中,泊松 100% 被拒,截断高斯 96.3%,指数 83.6%(p<0.01),而 S+F 仅 15.4%——22 个数据集中 13 个在所有窗口都被接受,且没有一个在四个以上窗口被拒;拒绝集中在短窗口(50 ms 处 5 例、200 ms 处 6 例、800 ms 处 0 例)。静态图像数据结论相同:泊松 100% 被拒,截断高斯 89.2%,指数 75%,S+F 仅 1/56(1.8%)。从直方图看,指数拟合的系统性失败在低放电端:低计数处 spike 太少、稍高计数处太多(Table 1;图 2、图 3、图 4)。
- S+F 的参数有可验证的物理意义。若快慢变异确如模型所述且总功率守恒,应满足 σS²+σF² ≈ 常数:图 5 中各数据集五个窗口的参数点连线确实近似圆弧,且大多落在 30°–60° 方向区间。快变异功率占比 F/(S+F) 随窗口长度对数增长,从 50 ms 处约 0.2 升至 800 ms 处约 0.6–0.7,恰是"每个倍频程贡献等量功率"的 1/f 型分布,作者将其联系到自然场景缺乏特征时间尺度的统计性质(图 5、图 6)。
- spike train 功率谱在低频(约 4–8 Hz 以下)呈近似 1/f,与 S+F 拟合推出的慢变异幅度随频率的变化一致;高频段变平是 spike 作为全或无事件的固有伪迹,S+F 参数不受此影响且在更宽频率范围上提供信息(图 7)。
- 每脉冲信息量在 12–400 ms 窗口间对静态图像数据基本恒定(各细胞无系统性升降趋势),而 spike 计数分布的熵却随窗口长度剧烈变化——熵不能替代信息,这也是对"最大熵"路线的直接批评(图 8)。
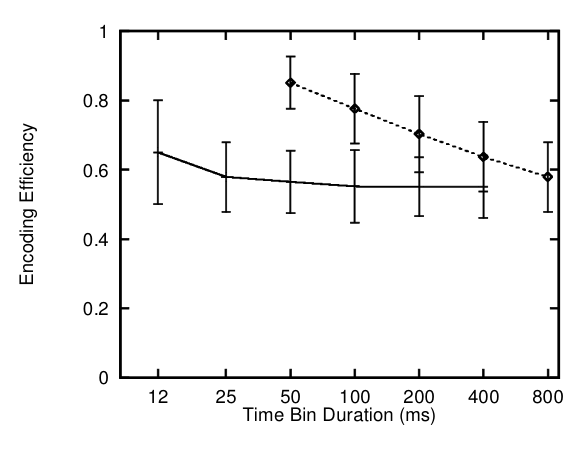
- 编码效率中等而非最优。静态图像数据 η 多在 0.5–0.7(25 ms 窗口平均 0.58、50 ms 0.56、100–400 ms 0.55,12 ms 略升至 0.65);视频数据 400/800 ms 为 0.64/0.59,短窗口下许多数据集升至约 0.9,但作者指出这部分是伪迹(单试次分布被迫二值化、且短窗口下该指标把噪声传输也计入)。换用 Bialek 等基于熵的定义 η_B,则仅约 0.1——即信息可比熵小约 9 倍(图 9)。
图注解读
图 1 · 阈值线性激活函数与快噪声平滑后的"有效"激活函数
原文图注:Figure 1: Activation functions in the model. The solid line is the instantaneous threshold linear activation function (with g D 1). The dashed line is an example of an “effective” activation function obtained integrating over fast noise, using equation 2.10, with sF D 50 Hz. The dotted and dashed line is another example of effective activation function, equation 2.10, obtained with sF D 10 Hz.
这张示意图的横轴是激活变量(流入胞体的电流,以等效放电率单位 Hz 计),纵轴是放电率。实线是瞬时阈值线性变换:阈值以下输出为零,以上线性增长(增益 g=1)。虚线与点划线是对快噪声(σF 分别为 50 Hz 与 10 Hz)积分后得到的"有效"激活函数:阈值附近的硬拐角被抹平,形成一个上凸的超线性段,快噪声越大平滑越强。这一机制是全文的核心:正是阈值附近的超线性把激活分布的高斯尾部转化为放电率分布的指数样尾部,但不会产生峰值恰在零点的完整指数分布——这解释了为什么数据有指数尾巴却仍拒绝指数模型。讨论部分明确依赖此图立论。
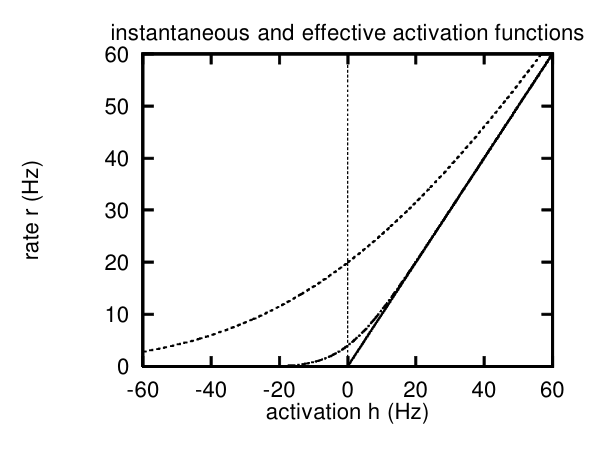
图 2 · 视频数据、100 ms 窗口下 9 个数据集的放电计数直方图
原文图注:Figure 2: Probability histograms for nine data sets (video data). The time window is 100 ms long. Each graph plots the probability on the y-axis of the number of spikes, in a 100 ms time bin, given in the x-axis. The histogram is the neurophysiological data from the neuron, with the standard deviation shown; the dashed line shows an exponential distribution fitted to the mean firing rate of the cell; and the solid line shows the fit of the S+F model described in the text.
九个小图对应九个数据集(如 ay080-05、ay087-01、ba003-03 等),横轴为 100 ms 窗口内的 spike 数,纵轴为对应概率。直方图是实测数据(误差棒按各 bin 频数的泊松式标准差画出),虚线是按该细胞平均放电率定标的指数分布,实线是 S+F 模型拟合。读图重点在低计数端的错位:指数虚线在零附近与实测的偏离(正文指出指数拟合"低率处 spike 太少、稍高率处太多"),而实线整体贴合。这九组是 22 个数据集的代表,其各模型拒绝比例(S+F 16.6%、指数 83.3%、泊松 100%、高斯 100%)与全样本几乎一致,支撑结果第 1 条。
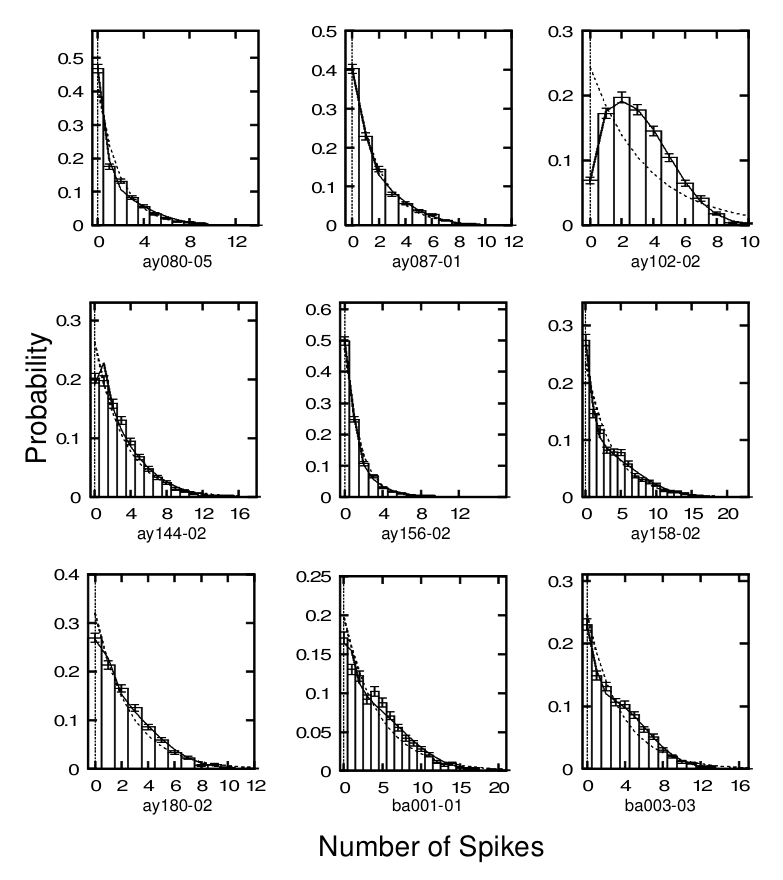
图 3 · 同上,但窗口加长到 400 ms
原文图注:Figure 3: Probability histograms for nine data sets (video data). The time window is 400 ms long. The conventions are as in Figure 2.
与图 2 完全同构,只是窗口加长到 400 ms,横轴 spike 数范围相应增大(最大可到 60 左右)。加长窗口后指数模型的失配更刺眼——正文明确说"尤其对较长的窗口,许多细胞拟合很差"——而 S+F 实线仍然贴合。两图合看的意义在于:指数模型的失败不依赖于计数时间尺度的选取,短长窗口下结论一致,排除了"只是某个窗口长度选得巧"的可能。
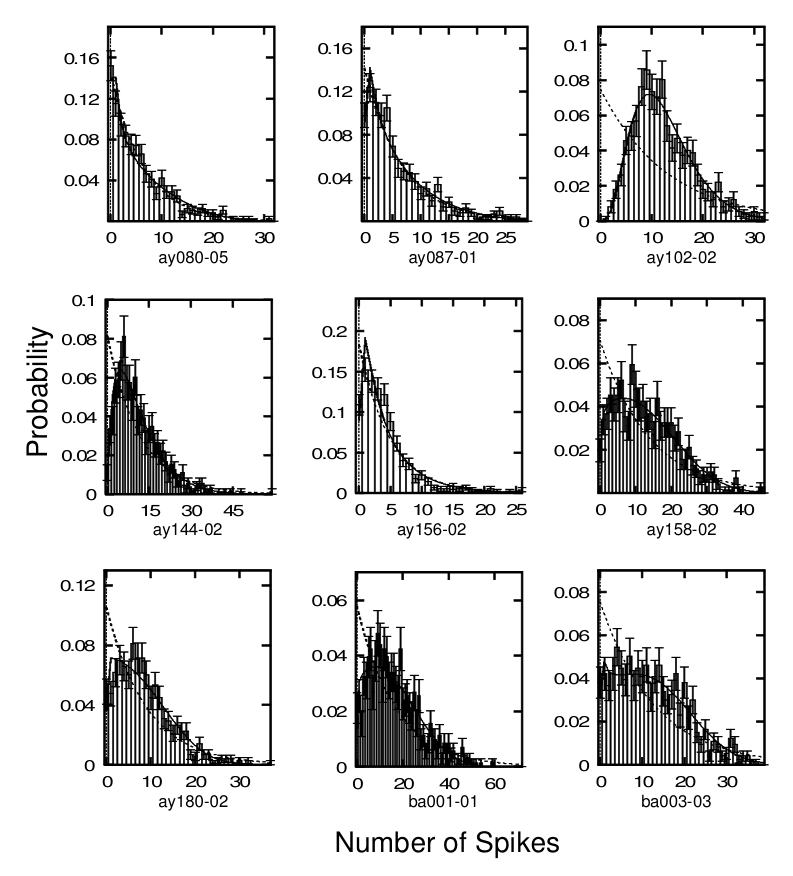
图 4 · 静态图像数据的三例直方图(A:100 ms;B:400 ms)
原文图注:Figure 4: Probability histograms for three cells (responding to static stimuli). (A) The time window is 100 ms long. (B) The time window is 400 ms long. The conventions are as in Figure 2.
这是交叉验证的关键图:另一只猴(am)的三个细胞(am164、am231、am235)对 65 张静态自然图像的响应分布,格式与图 2 相同,A 为 100 ms 窗口、B 为 400 ms 窗口。渐变性、单峰、指数样尾巴等特征在静态刺激下同样出现,且删除“信噪比更高”,改为:静态实验因样本数较少而整体较不容易拒绝模型,但380–600个试次仍足以拒绝指数、泊松和截断高斯模型,S+F仅有1/56次被拒绝。它支撑结果第 1 条,并证明分布形态不依赖于"看视频"这一特定刺激方式。
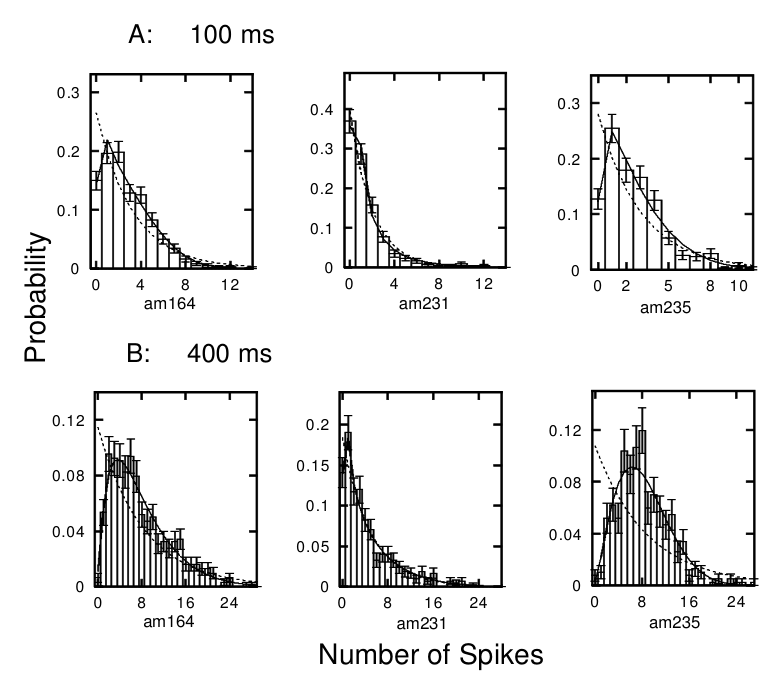
图 5 · 快噪声与慢噪声标准差的关系
原文图注:Figure 5: (Ordinate) The standard deviation of the fast noise, sF(L). (Abscissa) The standard deviation of the slow noise, sS(L). Units in Hz (video data).
横轴为慢变异幅度 σS(L),纵轴为快变异幅度 σF(L),单位均为 Hz;同一数据集在五个窗口长度的参数点连成折线。若模型前提(快慢变异功率之和守恒,σS²+σF²=常数)成立,这些折线应近似圆弧。实测确实大体如此——考虑到每个点来自各自独立的 χ² 最小化,这只是近似——且大多数数据集的曲线落在 30° 到 60° 的方向区间。这张图是模型内部的自洽性检验:支持 σS、σF 确实对应真实的慢/快变异成分,而非单纯的拟合自由参数,支撑结果第 2 条的前半。
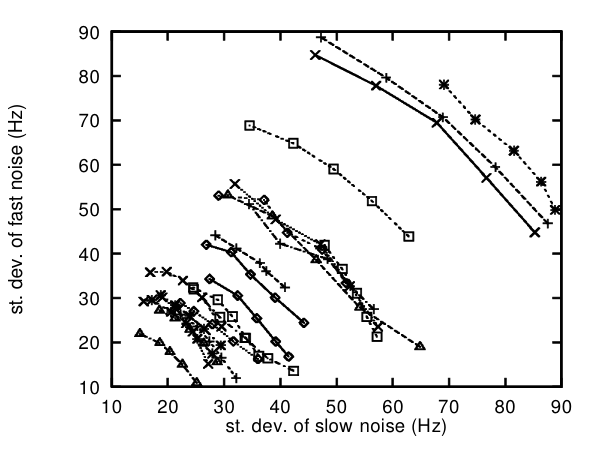
图 6 · 快变异功率占比随窗口长度对数增长
原文图注:Figure 6: (Ordinate) The fraction of the variability that is due to fast noise, F/(S C F). (Abscissa) The time window on a log scale. Dashed lines represent single data sets; the bold line is the average across data sets (video data).
横轴是窗口时长(对数刻度,50–800 ms),纵轴是快变异在总变异功率中的占比 F/(S+F)。虚线为各数据集,粗线为 22 个数据集的平均。曲线从 50 ms 处约 0.2 升至 800 ms 处约 0.6–0.7,且在对数时间轴上近似直线——这意味着每倍频程(频率减半)贡献等量功率,即 1/f 律。作者的解释是自然影像的元素缺乏特征性持续时间,涨落功率在很宽的时间尺度范围内近似均匀分布。这张图给出结果第 2 条的后半,也是全文最有生理趣味的一张:放电率分布的形状参数随窗口的移动方式本身携带了刺激统计的信息。
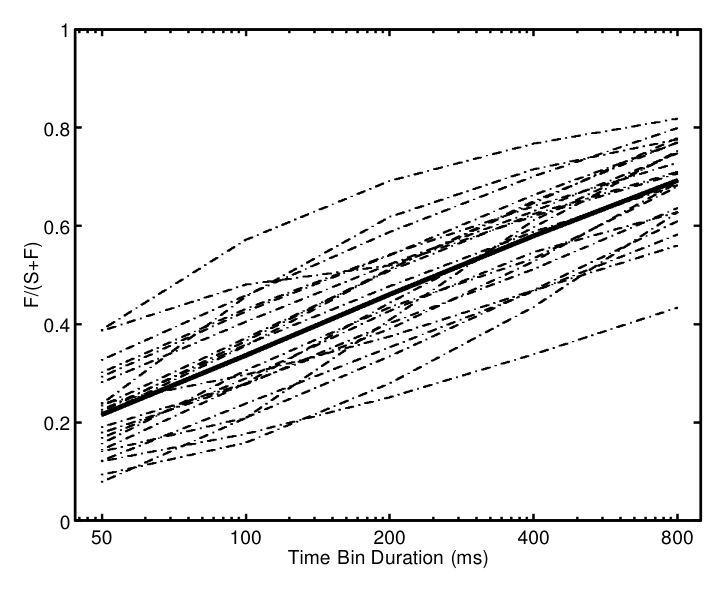
图 7 · spike train 的平均归一化功率谱
原文图注:Figure 7: The average across data sets of the normalized power spectrum of the spike train for each recording session. The sampling frequency is 200 Hz (video data).
横轴为频率(标注 0.78–25 Hz),纵轴为归一化功率(采样率 200 Hz,各数据集谱先归一化为总功率 1 再平均)。低频段(约 4–8 Hz 以下)呈近似 1/f 下降,之后变平。读图时要按作者的提醒区分两部分:平坦的高频段是 spike 作为全或无离散事件(近似 delta 函数、傅里叶变换平坦)造成的固有伪迹,不是神经信号的性质;有信息量的是低频端,其形状与 S+F 拟合推出的慢变异幅度变化一致。作者借此说明:直接测功率谱反而会掩盖 1/f 趋势,而通过模型拟合反演激活变量的方法绕开了这一失真。支撑结果第 3 条。
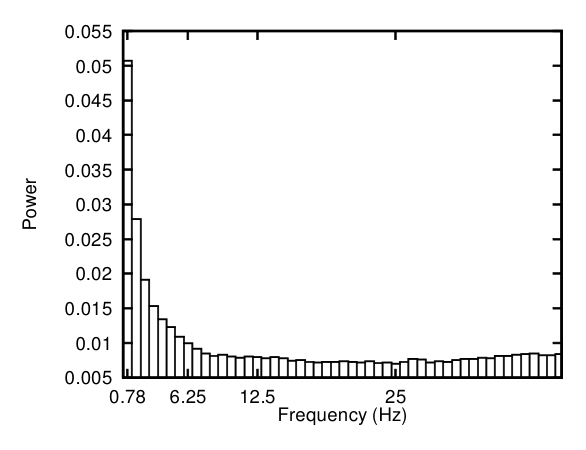
图 8 · 每脉冲信息量随窗口长度基本恒定
原文图注:Figure 8: The average across the population (C /¡ S.D.) of the information per spike Â(L) for 14 cells tested with 65 static images of natural scenes of faces plotted as a function of the time bin length L. The time axis is on a log scale.
横轴为窗口时长(对数刻度,12–400 ms),纵轴为 14 个静态图像细胞平均(±SD)的每脉冲信息量。关键观察:该量随窗口长度没有明显的单调趋势,平均值基本持平。这看似平淡,实为效率分析的合法性前提——它说明即使用长窗口测平均响应,也能合理估计短时信息传输率;与之对照,spike 计数分布的熵随窗口长度剧烈变化,根本不能作为信息量的稳定代理。这张图支撑结果第 4 条,也是对 Levy & Baxter、Baddeley 所用"熵"指标的方法论打击。
图 9 · 编码效率:静态数据(实线)与视频数据(虚线)
原文图注:Figure 9: The encoding efficiencies %(L) for 14 cells tested with 65 static images of natural scenes of faces plotted as a function of the time bin length L (solid line; C /¡ S.D.). The encoding efficiencies %(L) for all 22 data sets recorded with the video (dashed line; C /¡ S.D.). The time axis is on a log scale.
横轴为窗口时长(对数刻度),纵轴为编码效率 η(0 到 1,1 对应同稀疏度下的最优分布即二值分布)。实线是 14 个静态图像细胞的平均 ±SD:多数窗口落在 0.5–0.7(25 ms 处 0.58、50 ms 0.56、100–400 ms 0.55),12 ms 短窗口略升至 0.65——作者说明这一上翘部分是因为窗口短到只含 0 或 1 个 spike 时分布被迫趋近二值。虚线是 22 个视频数据集:长窗口 400/800 ms 处为 0.64/0.59,越短的窗口 η 越高、50 ms 处许多数据集达约 0.9,但同理这上翘含有伪迹成分(单试次分布二值化、且短窗口下该指标把噪声传输也计入)。全图的核心结论是:两种刺激模式下效率都稳定在 0.5–0.7 的中等水平,远离 1——分布形状不是为最大化信息传输效率而生。支撑结果第 5 条。
讨论
作者对发现的解释落在机制而非目的上:S+F 模型既不需要假设真实脉冲动力学的细节,也不需要假设突触输入如何被求和,只要求激活变量的快慢涨落都近似正态——这在输入弱相关时由中心极限定理保证(作者引 Settanni & Treves 1998 的分析说明,即便突触输入与权重因学习而相关,对分布形状的修正也很小)。快噪声与阈值线性变换共同造就的有效激活函数在阈值附近超线性,把高斯尾部转换为指数样尾部而不产生零峰的完整指数分布;数据中也没有任何需要饱和的证据——完全的 sigmoid 会在尾部产生更陡的截断,与观察到的长指数尾不符,这与 IT 神经元放电很少超过 100 spikes/s 的事实一致。作者坦率承认 15% 视频拟合失败主要源于模型刻意求简:阈值线性变换太粗糙、快/慢二分太武断、忽略输出的脉冲离散性、连续分布转直方图只是近似;但他们坚持 h₀ 跨窗口同值的拟合方案,认为可解释性比逐尺度过拟合更重要。
对话的对象有两条线。对 Baddeley、Levy & Baxter 一系,文章的批评是方法论层面的:熵只是总变异的量度,而互信息要从总变异中扣除"消息固定时仍存在的变异";本数据中信息可比熵小约 9 倍,因此放电率分布的形状不能由最大化信息传输率来解释。对 Softky & Koch(1993)一系,文章给出了另一个侧面的回应:他们以放电的高变异性论证皮层神经元需要同步输入,而本文通过模型反演发现激活变异中相当大的比例发生在快于分析窗口的时间尺度上——这些快速信号无需同步即可贡献于放电统计,从而挑战了"精确同步必不可少"的观点(作者也说明这不直接处理突触输入变异本身的问题)。结尾的立场相当克制:这些分布与任何特殊优化原则(信息效率、熵极值、同步性、速度、平稳性、细胞集群)的关系,都得靠别的分析去找证据;放电计数直方图本身不偏向其中任何一个。
一句话总结
这篇文章最打动我的地方是把一个时髦命题拆回到了物理常识:放电率分布长着指数尾巴,只说明"许多近高斯的输入汇入一个带阈值的非线性单元",而不说明大脑在按最大熵原则精打细算地编码。0.5–0.7 的效率意味着 IT 神经元的编码"够用,但没有被优化到极限"。在我看来它给整个有效编码范式提了个醒——看见指数尾巴就谈代谢优化之前,得先排除最平凡的解释;不过我也想保留一点:效率在 0.5–0.7 而非随机水平,或许说明优化压力存在只是不占主导,这是我的理解,文中未展开。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[D] - Fig2: 提取质量
good,对齐度full,识别面板[F] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[A, B] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[C, F] - Fig7: 提取质量
good,对齐度full,识别面板[] - Fig8: 提取质量
good,对齐度full,识别面板[C, D] - Fig9: 提取质量
good,对齐度full,识别面板[C, D]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'classification': 'OVERCLAIM', 'severity': 'major', 'md_section': '研究思路/一句话总结', 'current_text': '如果指数模型拟合差、而 S+F 拟合好,那么指数尾巴就只是“高斯输入 + 阈值 + 快噪声”的机械后果;放电率分布长着指数尾巴,只说明“许多近高斯的输入汇入一个带阈值的非线性单元”。', 'problem': '拟合优度比较不能唯一确定真实生成机制,更不能把模型一致性提升为因果证明。原文使用的是“can be largely accounted for”和“consistent with the possibility”等限定表达,并承认模型简化、参数间接估计及其他可能机制。', 'source_page': 624, 'source_section': 'Discussion and Conclusion', 'recommended_fix': '改为:S+F模型表明,近高斯的快慢输入变异经过阈值非线性即可在不诉诸最优化原则的情况下解释大部分观测分布;结果支持这种可能性,但不能唯一证明真实生成机制。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'classification': 'OVERCLAIM', 'severity': 'minor', 'md_section': '研究思路', 'current_text': '若两种模式下放电计数分布的形态和模型检验结论一致,就能排除“分布形状是某种特定刺激呈现方式的伪迹”这一质疑。', 'problem': '两种范式的一致性能够降低该解释的可能性并提供交叉验证,但不能排除所有与呈现方式、眼动、注意、细胞筛选或样本结构有关的混杂。', 'source_page': 604, 'source_section': 'Methods 2.1', 'recommended_fix': '将“排除”改为“降低其由单一呈现方式造成的可能性”。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'classification': 'OVERCLAIM', 'severity': 'moderate', 'md_section': '主要结果/图注解读/图5', 'current_text': 'S+F 的参数有可验证的物理意义;支持 σS、σF 确实对应真实的慢/快变异成分,而非单纯的拟合自由参数。', 'problem': '图5只是模型内部一致性检查。作者的表述是这些参数“may indeed be associated” with slow and fast fluctuations;讨论部分还明确称频率分布结论是基于拟合参数的间接结果。', 'source_page': 617, 'source_section': 'Results 3.2', 'source_figure': 'Fig. 5', 'recommended_fix': '改为:参数随窗口长度的关系与慢、快变异的解释相容,为该解释提供内部一致性证据,但不是对这些潜在成分的直接测量。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_004', 'classification': 'OVERCLAIM', 'severity': 'minor', 'md_section': '讨论', 'current_text': '这在输入弱相关时由中心极限定理保证。', 'problem': '中心极限定理只在许多近独立、无单项占主导且输入与突触权重不存在显著相关等条件下支持近似正态分布;本文没有直接验证这些条件。“保证”过强。', 'source_page': 624, 'source_section': 'Discussion', 'recommended_fix': '改为:在许多输入近独立、无单项占主导且输入与权重仅弱相关时,中心极限定理使近似正态分布成为合理假设。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_005', 'classification': 'OVERCLAIM', 'severity': 'moderate', 'md_section': '一句话总结', 'current_text': '效率在 0.5–0.7 而非随机水平,或许说明优化压力存在只是不占主导。', 'problem': 'η=0.5–0.7是相对于固定稀疏度下理论最大信息量的归一化效率,不是相对于随机基线的检验。本文没有定义“随机水平”,也没有据此检验自然选择或编码优化压力。', 'source_page': 627, 'source_section': 'Discussion 4.3 and Conclusion', 'recommended_fix': '删除“而非随机水平”及关于优化压力的推断,或明确标注为缺乏本文数据支持的外部假说。'} -> 评注:
- 补充要点: : (第 613 页)
- 补充要点: : (第 609 页)
- 补充要点: : (第 623 页)
- 补充要点: : (第 605 页)