IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
242| 原始基线:V0_ZCODE_BASELINE| 语义审核:revise| 图表审核:pass
Fast readout of object identity from macaque inferior temporal cortex
Hung · Science (New York, N.Y.) · 2005 · Zotero itemID=2253
这篇文章把"IT 皮层里到底装了多少信息"变成了可以定量回答的问题:作者用生物上说得通的线性分类器读出(classifier-based readout)技术,测出约 100 个随机选取的 IT 位点、在短至 12.5 ms 的尖峰计数内,就能以相当高的准确率读出物体的"身份"与"类别",且信息对位置和尺度变化具有不变性。它为此后的群体解码研究提供了范式与基准数字。
研究背景
灵长类在刺激出现后约 200 ms 就能完成物体识别与归类(Fabre-Thorpe et al., 1998),这凸显了腹侧视觉通路识别计算的高速与高效。由于从视网膜到前部颞下皮层(inferior temporal cortex,IT)的前馈回路至少需要八个以上突触,有研究者据此提出:通路各阶段的计算可能只基于每个神经元的一或极少几个尖峰(Keysers et al., 2001; vanRullen & Thorpe, 2002)。在腹侧流末端,IT 单个细胞对复杂物体表现出选择性,并对物体尺度与位置的变化有一定容忍(Desimone et al., 1984; Logothetis et al., 1995 等);由此推测,对物体和物体部件调谐的小群 IT 神经元或许足以支持识别、归类等多种视觉任务,信息可由下游回路"读出"(Riesenhuber & Poggio, 1999; Freedman et al., 2001)。
生理学与功能成像数据都指向物体身份与类别编码于 IT 神经元活动中,但其编码的一些基本侧面仍有争论:识别力与群体规模的关系、时间分辨率、时间过程。这些必须在群体水平上回答,才能为视觉物体识别的模型提供定量约束——这正是当时的缺口:多数研究描述单个神经元的偏好,却很少量化"一小群随机神经元的响应能被读出多少信息"。
研究思路
作者不再问"单个神经元偏好什么",而是问"一小群随机神经元的响应能否被下游以简单方式读出"。具体做法是:从两个被动注视的猴身上独立收集大量无偏选取的 IT 记录位点,把每个位点在短时窗内的尖峰计数作为特征向量,训练正则化线性分类器学习"神经响应→物体标签"的映射,再在未参与训练的数据上测试泛化。该读出方案的一个关键性质是它给出的是信息量的下限:分类器不预设训练样本的先验分布,只从数据中学习映射;一个线性分类器在实际下游神经理论上只需对传入尖峰做加权求和,就能在单个试次上达到这一识别水平——这是"生物可行"的含义。
检验顺序层层递进:先证选择性(能否读出类别与身份),再证不变性(只在一个位置与尺度上训练,测试移动或缩放后的物体),再证时间上的快速性(最短需要多少毫秒)以及同一群体的多任务共用性(身份、类别与位置/尺度信息是否由同一群神经元承载)。
方法
两只被动注视的猕猴,从 IT 皮层顺序独立收集 300 余个记录位点,分析对象以多单元活动(multi-unit activity,MUA)为主,同时比较单单元活动(single-unit activity,SUA)与局部场电位(local field potential,LFP)。刺激为 77 幅灰度图片,实验前预先定义八个类别(玩具、食物、人脸、猴脸、手/身体部位、车辆、盒子轮廓、猫/狗,见注 29);事后对神经反应做无监督聚类可得到相近的分组,而把这些类别随机打乱重设时,归类性能大幅下降,说明分类器读到的不是任意可分的表面特征。
读出框架:one-versus-all 方案——对每个类别(归类 8 类、识别 77 类、尺度/位置读出 3 类)各训练一个二元线性正则化分类器,测试时取激活最大的分类器输出作为预测。输入为刺激开始后 100–300 ms 内连续 50 ms bins 的尖峰计数;顺序记录的位点在合并时假设彼此独立(作者强调相关性可能携带额外信息,故该估计是下限);误差棒为 20 次随机抽取位点组合的 SD。更细的记录与训练细节(如正则化方式、交叉验证)在在线补充材料中,正文未详述。
主要结果
-
类别与身份的准确读出(图 1B):256 个随机 MUA 位点的尖峰活动足以以 94±4% 的准确率对 77 个物体完成八类归类(机遇 12.5%;100 位点插值性能 81%);识别任务(说出是 77 个物体中的哪一个)同样可行但更难:256 位点 72±3% 正确(机遇 1.3%;100 位点插值 49%)。性能随位点数的对数近似线性增长,支持分布式表征而非"祖母细胞"式表征。SUA 读出性能与 MUA 十分接近(图 1C),LFP 也携带类别信息。
-
信息对噪声与单试次稳健:所有性能都基于未参与训练的单独呈现(单试次),对皮层神经元高试次间变异性的条件下依然成立(Koch, 1999);且对删除大量神经元(模拟神经元或突触死亡)与扣除部分尖峰(模拟递质释放失败)均稳健(补充图 S1)。同一 IT 群体甚至能准确读出刺激起始时刻(图 S5)——故"依赖精确的刺激起始信息"并非该方法的隐藏前提。
-
位置与尺度不变性(图 2):用 71 个额外位点,只让分类器在标准位置与尺度上"见过"每个物体,再测试位移与缩放版本:归类性能下降小于 10%;身份读出同样稳健泛化(补充材料);对从未见过的新异物体也表现出尺度与位置不变性(图 S6)。作者对比指出,V1 类区域的选择性不会在位置变化下泛化(补充材料),故 IT 群体表征的"选择性+不变性"组合高度非平凡——这也是哺乳类视觉仍远胜计算机视觉算法的原因所在。
-
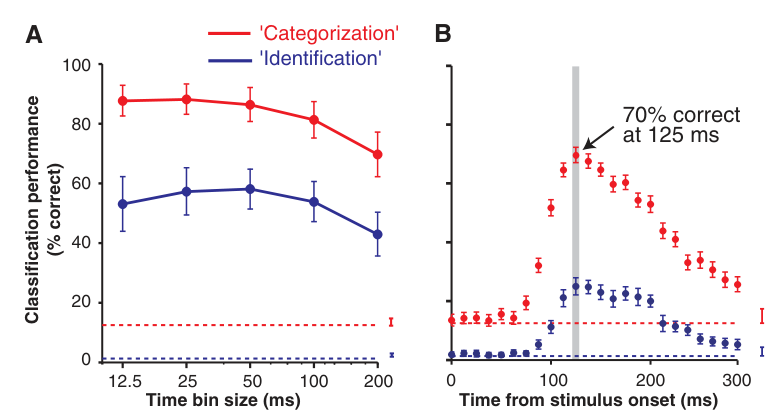
神经编码的时间分辨率(图 3A、3B):在 100–300 ms 窗内计数尖峰时,bin 大小取 12.5 至 50 ms 的性能优于更大的 bin。更惊人的是:只用刺激开始后 125 ms 处的单个 12.5 ms bin,就能以 70±3% 的准确率读出类别(图 3B,n=256 位点),而该 bin 平均仅含 0.18±0.26 个尖峰(通常 0–2 个尖峰)——本质上是一个由 0 和 1 组成的二值向量。这说明在行为相关的时间尺度上,少量神经元的一两个尖峰就足以编码"是什么"。
-
同一群体承载多种信息:归类与识别的时间过程和时间分辨率差别不大(图 3);两者最优位点重叠、信噪比强相关(r=0.54,p<10⁻¹⁰),同一组随机位点可同时服务两个任务。此外,以同样的读出方法、不依赖身份,也能从同一群体中粗略读出物体尺度与位置("where"信息,图 S4A),其时程与类别读出相似(S4B);而单个位点传信号息尺度/位置的能力与其传信号息类别的能力几乎不相关(S4C),提示 IT 神经元同时编码这两类信息。
图注解读
图 1 · 类别与身份均可从群体活动准确读出
原文图注:Fig. 1. Accurate readout of object category and identity from IT popula- tion activity. (A) Exam- ple of multi-unit spiking responses of 3 indepen- dently recorded sites to 5 of the 77 objects. Ras- ters show spikes in the 200 ms after stimulus onset for 10 repetitions (black bars indicate object presentation). (B) Performance of a linear classifier over the entire object set on test data (not used for training) as a function of the number of sites for reading out object category (red, chance 0 12.5%) or identity (blue, chance 0 1.3%). The input from each site was the spike count in consecutive 50-ms bins from 100 to 300 ms after stimulus onset (28). Sequentially recorded sites were combined by assuming independence (Supporting Online Material). In this and subsequent figures, error bars show the SD for 20 random choices of the sites used for training; the dashed lines show chance levels, and the bars next to the dashed lines show the range of performances using the 200 ms before stimulus onset (control). (C) Categorization performance (n 0 64 sites, mean T SEM) for different data sources used as input to the classifier: multi-unit activity (MUA) as shown in (B), single-unit activity (SUA), and local field potentials (LFP, Supporting Online Material). (D) This confusion matrix describes the pattern of mistakes made by the classifier (n 0 256 sites). Each row indicates the actual category presented to the monkey (29), and each column indicates the classifier predictions (in color code).
(A) 先展示单点的反应:3 个独立记录位点对 5 个物体的栅格图(刺激后 200 ms,10 次重复,黑条为呈现期)——单个位点的响应有差异但远不足以判定物体,这是后面群体读出必须超越的"起点"。(B) 是全文主图:横轴为位点数(对数刻度 1→256),纵轴为测试数据上的正确率;红线(归类,机遇 12.5%)始终在蓝线(识别,机遇 1.3%)上方,虚线旁的短条为用刺激呈现前 200 ms 尖峰训练的对照(接近机遇)。(C) 比较 MUA、SUA、LFP 三种输入的归类性能(n=64,均值±SEM):前两者相当,LFP 低于两者但高于机遇。(D) 8×8 混淆矩阵(n=256),行=实际类别、列=分类器输出(颜色编码),显示哪些类别容易混淆。此图支撑主要结果 1、2。
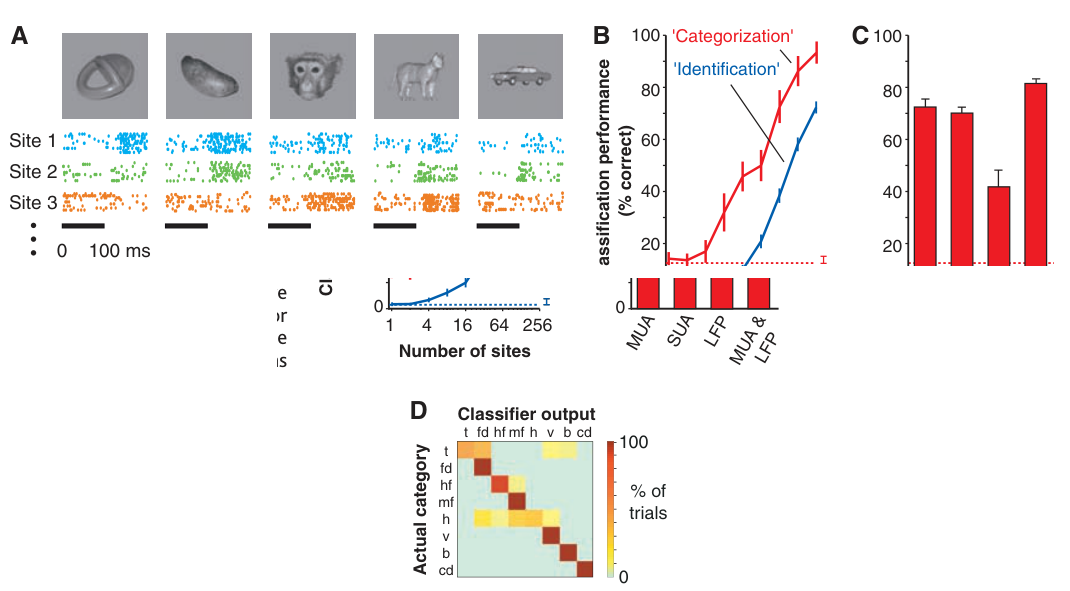
图 2 · 训练与测试的空间变换不匹配,性能几乎不掉
原文图注:Fig. 2. Invariance to scale and position changes. Classification performance (categori- zation, n 0 64 sites, chance 0 12.5%) when the classifier was trained on the responses to the 77 objects at a single scale and position (de- picted for one object by ''TRAIN'') and perform- ance was evaluated with spatially shifted or scaled versions of those ob- jects (depicted for one object by ''TEST''). The classifier never ''saw'' the shifted/scaled ver- sions during training. Time interval 0 100 to 300 ms after stimulus onset, bin size 0 50 ms. The left-most column shows the performance for training and testing on separate repetitions of the objects at the same standard position and scale (as in Fig. 1). The second bar shows the performance after training on the stan- dard position and scale (scale 0 3.4-, center of gaze) and testing on the shifted and scaled images of the 77 objects. Subsequent columns use different image scales and positions for training and testing.
柱状图:每根柱是一种"训练位置/尺度→测试位置/尺度"组合下的归类性能(chance 12.5%)。最左柱是训练与测试都在标准条件(3.4°、注视中心)但用不同重复次数的基准;第二柱为标准条件训练、变换条件测试;后续柱为不同的尺度(中心 1.7°、6.8°)与位置(水平位移 2°、4°)组合的训练/测试配对。要点在于:所有跨变换柱都贴近基准柱、下降不到 10%,而分类器在训练中从未见过被测的变换版本——这就是结果 3 的"不变性"证据。
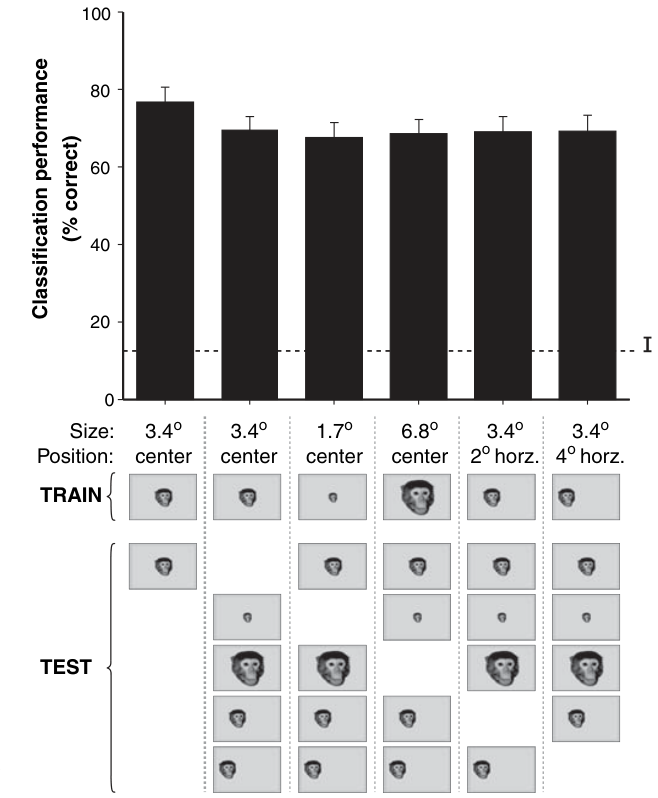
图 3 · 编码的时间分辨率与时程
原文图注:Fig. 3. Latency and time resolution of the neural code. (A) Classification performance (n 0 128 sites) as a function of the bin size (12.5 to 200 ms, i.e., temporal resolution) to count spikes within the 100- to 300-ms window after stimulus onset for categorization (red) and identification (blue). The same linear classifier as in Figs. 1 and 2 was used. (B) Classification performance (n 0 256 sites) using a single bin of 12.5 ms to train and test the classifier at different latencies from stimulus onset (x axis). The colors and conventions are as in Fig. 1B.
(A) 横轴为 bin 大小(12.5→200 ms),纵轴为性能:计数窗固定为刺激后 100–300 ms,bin 越小(时间分辨率越高)性能越好,12.5–50 ms 明显优于 100–200 ms。(B) 横轴为单个 12.5 ms bin 相对刺激起始的延迟(0→300 ms),性能曲线快速爬升,约 125 ms 处归类已达 70%(图中标注 "70% correct at 125 ms"),其后维持平台;归类与识别两条曲线形状相似。此图支撑结果 4、5:信息出现得早、分辨率要求不高,且同一群体可服务不同任务。
讨论
作者的立场很克制:这些观察刻画的是 IT 中"可获得的信息",并不必然意味着大脑只利用 IT 神经元、或采用与本文相同的解码算法(Tjan, 2001)。但一个接近最优的线性分类器在神经硬件上极易实现——下游神经元只需对来自 IT 的输入做适当加权和;因此 IT 的下游区域(如前额叶皮层,PFC)完全可能用小群体(约 100 个神经元)在极短时间窗内完成解码。作者进一步给出一个诱人的图景:IT→PFC 突触权重的动态设定可以在不同任务间切换,从而从同一 IT 群体中按需读出"归类"或"识别"信息(Freedman et al., 2001)——在这个视角下,IT 的一部分神经元类似于学习网络中的调谐单元,可支持 PFC 中多种识别任务(Poggio & Bizzi, 2004)。
方法论层面,作者把这套读出方案定位为刻画皮层区信息的通用工具:可以对任一刺激属性训练分类器,再系统检验该属性的候选神经编码。两处限制被明确写进注释:其一,顺序记录位点按独立性合并,相关性可能携带额外信息,故所有性能都是下限,且"大脑可能把 IT 输出选择性接到最相关的特征上"——简单的信噪比预筛选表明更少的位点即可达到高性能(注 31);其二,对神经元删除与尖峰丢失的稳健性(注 35)说明编码是分布式且冗余的。归类与识别的时间过程与任务弱相关的发现,也与此前关于 IT 中类别与个体信息分离的时间动态研究(Sugase et al., 1999; Vogels, 1999)形成对照:至少在读出水平上,同一群体、同一时间窗都能同时支持两类任务。
一句话总结
用最朴素的机器学习读出,这篇文章把 IT 的信息含量钉成了几个硬数字:百来个神经元、十几毫秒、平均不到一个尖峰,就足以读出"看见的是什么",还能顺带读出它大概在哪儿。在我看来,它真正的遗产是立起了一个可比较的基准——此后视觉表征模型(从当时的分层模型到后来的深度网络)都被放到同样的读出测试上打分;而独立性假设给出下限、线性读出接近最优这两件事,既是这篇文章的锋利之处,也是解读其数字时必须记住的边界(这是我的理解)。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[A, B]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'current_text': '“因此IT的下游区域(如前额叶皮层,PFC)完全可能用小群体(约100个神经元)在极短时间窗内完成解码。”', 'classification': 'INTERPRETATION', 'problem': '研究没有记录PFC、操纵IT到PFC的连接或证明动物实际采用该线性权重。数据只证明IT活动中存在可由线性分类器利用的信息;PFC读出属于作者提出的生物可行性假说。', 'source_page': 865, 'recommended_fix': '改为:“作者推测,PFC等IT下游区域原则上可能通过加权求和读出这些信息;本文未直接检验这种下游机制。”'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'current_text': '“性能随位点数的对数近似线性增长,支持分布式表征而非‘祖母细胞’式表征。”', 'classification': 'INTERPRETATION', 'problem': '原文将该趋势称为分布式表征的指示性证据,但这一群体解码曲线不能严格排除稀疏编码或少数高信息神经元的贡献。', 'source_page': 863, 'recommended_fix': '保留为作者推论并降调:“该趋势与分布式表征相符,但不能单独排除更稀疏的编码方案。”'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'current_text': '“IT群体表征的‘选择性+不变性’组合高度非平凡——这也是哺乳类视觉仍远胜计算机视觉算法的原因所在。”', 'classification': 'INTERPRETATION', 'problem': '这是作者的背景性解释,不是本文通过对照实验建立的因果结论;研究未直接比较哺乳类视觉与计算机视觉算法。', 'source_page': 864, 'recommended_fix': '明确标为作者观点:“作者认为,选择性与不变性的结合是哺乳类视觉优势的一个可能原因;本文未直接检验这一跨系统比较。”'} -> 评注:
- 补充要点: : (第 865 页)
- 补充要点: : (第 865 页)