IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
186| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass_with_minor_revisions| 图表审核:pass
Deformation-specific and deformation-invariant visual object recognition: pose vs. identity recognition of people and deforming objects
Webb · Frontiers in Computational Neuroscience · 2014 · Zotero itemID=1713
同一个视觉系统,既能"认出这是个坐着的人"而不问是谁,也能"认出这是老张"而不问他坐着还是走着——本文用腹侧视觉通路模拟器 VisNet 演示:同一条带短时记忆痕迹的赫布学习规则(trace learning rule),仅靠改变训练时图像呈现的先后统计(按姿态分组还是按个体分组),就能分别学会"姿态特异而个体不变"与"个体特异而姿态不变"的两类表征,思路对旗帜形变同样成立。它值得读,是因为"学习什么不变性取决于视觉输入的时间统计"这一假设给出了一个可解释、可预测的统一框架,而且作者顺手预言了两类表征应在皮层上分区存放。
研究背景
问题来自一个日常观察的双重性:看见一个坐着的人,我们既能识别姿态(独立于个体),也能识别这个人(独立于姿态);被风吹动的旗帜也一样,风致形变(deformation)与其国别(identity)可以彼此独立地被认出。当时的工程方法处理形变很吃力,比如基于部件的人体姿态识别(Yang 等 2010)依赖对每个部件的准确识别与部件间空间关系的显式处理,对旗帜这类会流动变形的物体很难奏效。神经科学这边也知道一些相关事实:上颞沟前部有对面部表情反应、独立于个体身份的神经元(Hasselmo 等 1989a),下颞叶皮层有独立于表情的身份神经元,还有对面部视角(如右侧脸)反应的细胞(Perrett 等 1985)与对行走人像反应的细胞(Barraclough 等 2006)——即"姿态特异"与"身份特异"的表征在脑里确实并存。但缺少一个机制性解释:这两类不变的知觉表征是怎么被学出来的,为什么自然世界里两者都能形成?
缺口正好卡在"学习原理"上。Rolls 实验室此前发展的假说认为,腹侧通路借助时-空连续性(temporo-spatial continuity):真实物体连续变换时,相邻时刻的视网膜输入大概率来自同一物体,于是用带先前活动短时记忆痕迹的突触学习规则就能把"该物体的一切变换"绑到同一批神经元上,学习平移、尺寸、视角、光照与旋转不变性。但姿态/形变这类"内部变形"与"个体身份"之间的双轴独立,尚无人用这套框架检验——这正是本文的切入点。
研究思路
作者的核心推理只有一步但很关键:不变性的方向由训练序列的统计决定。如果训练时让"大量不同的人依次出现于同一姿态"(场景连续性作用于姿态轴),轨迹规则看到的时间连续性就属于姿态,于是会形成对姿态反应、对个体与视角不变的神经元;反之,如果让"同一个体依次变换姿态"(连续性作用于个体轴),就形成对个体反应、对姿态与视角不变的神经元。尤为关键的是,两种情形下呈现的图像集合完全相同,唯一变化是呈现顺序——这把"学什么不变"干净地归因于视觉输入的时间统计,而非刺激内容本身。作者为此设计了两个方向正好互为镜像的训练模式(object recognition mode 与 deformation recognition mode),并配上一面镜子式的对照:用纯赫布规则(无时间痕迹)训练,看性能掉多少。判断标准沿用信息论 单细胞信息量 / 多细胞信息量,外加一个生物学上更合理的模式联想器(pattern associator)解码,模拟眶额皮层、杏仁核等下游读出结构。
方法
模拟器为 VisNet:四层等级化竞争网络,第 1–4 层依次对应 V2、V4、后部 IT(TEO)与前部 IT(TE),输入层先用二维 Gabor 滤波器模拟 V1 简单细胞(四个空间频率倍频程、0°–135° 每 45° 一个朝向、正负相位分离处理)。本研究的网络比早期版本大 16 倍:每层 128×128 神经元,输入层 256×256×16;每层收敛连接使感受野逐层增大(第 1 层 100 个连接、第 2–4 层各 400 个)。学习规则用 Rolls 与 Milward 2000 的修正迹规则 δwⱼ = α·y^(τ−1)·x_j^τ——突触更新取决于前一时间步的后活动痕迹乘以当前前馈输入,踪迹参数 η 第 2 层取 0.6、第 3/4 层取 0.8,第 1 层用纯赫布规则(先学高精度特征组合再学不变性);学习率第 1–4 层分别取 0.05/0.03/0.005/0.005,每层配合侧向抑制与 sigmoid 激活(阈值控制群体稀疏性)。
人体刺激用 Blender 渲染(模型来自 MakeHuman):3 个个体(男、女、士兵)×3 种姿态(站、坐、走)×12 个视角(30° 步进),8 位灰度、均值 127。旗帜刺激用 Blender 布料模拟加侧向风力场生成:4 个国家(荷兰、西班牙、英国、美国)×5 档风速(0–200 blender 单位等距,风致形变从无到烈)×2 个视角(正对与背面)。训练时图像呈现在"视网膜"中央,按身份或按形变分组作随机排列,每组结束后痕迹值清零(加速收敛),共 50 个训练轮(capacity 实验用 60 轮)。成绩用两种信息量衡量:单细胞信息量以单个神经元对最有效刺激的信息为准,理论上限 log₂(刺激数);多细胞信息量取每对象信息量最高的 5 个细胞、经解码步骤计算互信息;分别说明:多细胞信息量使用每类5个最高单细胞信息量的细胞;附录的一般模式联想器示例使用每对象10个细胞;姿态泛化实验的模式联想器使用每姿态5个细胞。作者特意不用支持向量机等解码器,理由是这类学习在生物学上不可信,且能让权重完全随机的多层网络也跑出好成绩,从而混淆"模型学到的"与"解码器硬凑出的"。
主要结果
-
按身份训练 → 身份特异、姿态/视角不变的神经元出现(图 4):最佳细胞之一对"士兵"的全部 3 姿态×12 视角都反应、对另外两人不反应,单细胞信息量 1.59 bit(=log₂3,完美选择性);另一个细胞对"女人"的大部分视角反应(1.5 bit)。信息量最高的 75 个细胞整体表现强(图 4C),多细胞信息量 1.55 bit,对应 96% 正确(图 4D)。换用纯赫布规则,多细胞信息量跌到 0.42 bit、52% 正确——痕迹规则是关键。
-
按姿态训练 → 姿态特异、个体/视角不变的神经元同样出现(图 5):对"坐姿"反应的细胞几乎跨 3 个人×12 视角不变(1.59 bit),另一个对"站姿"(1.5 bit);多细胞信息量 1.55 bit、96% 正确;纯赫布对照只有 0.41 bit、56% 正确。这两条结果合起来是全文题眼:同样一张图集,只改呈现顺序,就学到方向相反的两套不变性。
-
旗帜国别可独立于形变与视角被识别(图 6):对"美国旗"反应的细胞跨 5 档风速×2 视角不变,单细胞信息量 2.0 bit(=log₂4);前 100 个最选择性细胞的信息量-ranked 图接近满值(图 6B),多细胞信息量 2.0 bit、100% 正确。
-
风速/形变亦可独立于国别与视角被识别(图 7):对风速参数 150 的细胞跨 4 国旗×2 视角反应、对其他形变几乎不反应,单细胞信息量 2.32 bit(=log₂5);125 个最选择性细胞中许多达到满值,多细胞信息量 2.32 bit、100% 正确——网络实际上学会了"风有多大"。
-
容量与泛化:把旗帜集合扩到 28 面(北约成员国旗)后做随机子集训练测试(图 9),8 面以内接近 100%,10 面 92%、15 面 86%、20 面 79%。跨个体的姿态泛化(留一法交叉验证:6 人训练 5 人、测留出的第 6 人)达到 76% 正确(随机水平 33%,二项检验 p<10⁻³⁷),个体间波动 30–92%(SD 26%);未训练网络的对照仅 19%。这说明姿态识别跨越个体具有域泛化性。
图注解读
图 1 · 人体训练刺激的三姿态×十二视角
原文图注:FIGURE 1 | Different views of human stimuli used to train the VisNet model. Each row shows each stimuli in one of three different poses (sitting, standing, and walking) varying across view rotation. The 12 rotations are shown, starting with 0° on the left and proceeding in 30° increments.
每行是一个姿态下的某个人物随视角旋转的 12 帧(0° 起、30° 步进)。这张刺激总览说明"姿态"与"视角"在本实验中是两套独立坐标系:视角绕物体旋转(可逆的刚体变换),姿态是身体构型的非刚体变化。读后文信息分析时应记得"transforms vary fastest over views"——横轴上 12 个一组的块对应同一姿态的 12 个视角。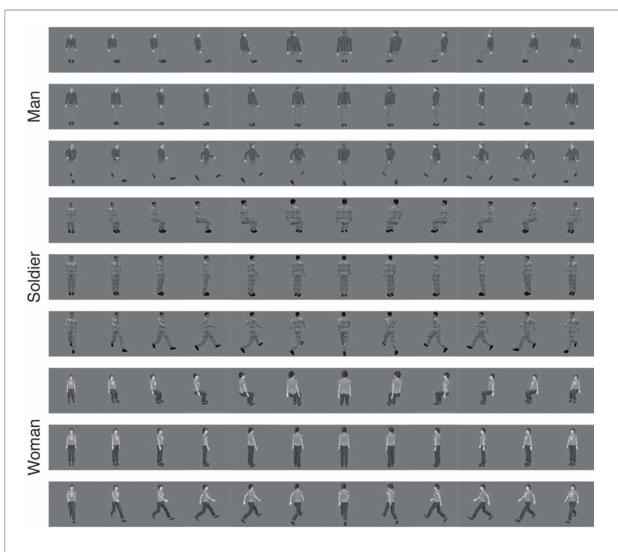
图 2 · 风速形变的旗帜刺激
原文图注:FIGURE 2 | The flag stimuli used to train VisNet. Each flag is shown with different wind forces and rotations. Starting on the left the first pair, both the 0° and 180° views are shown for windspeed 0, and each successive pair is shown for wind force increased by 50 blender units.
从左到右每对 0°/180° 视角对应风速递增 50 blender 单位(0 到 200)。这是把"形变"操作化的方式:同一面旗、同一个刚体视角旋转,只改变布料模拟下的风吹弯曲程度。它支撑旗帜实验的设计前提——形变(风速)与国别、视角三者正交可分。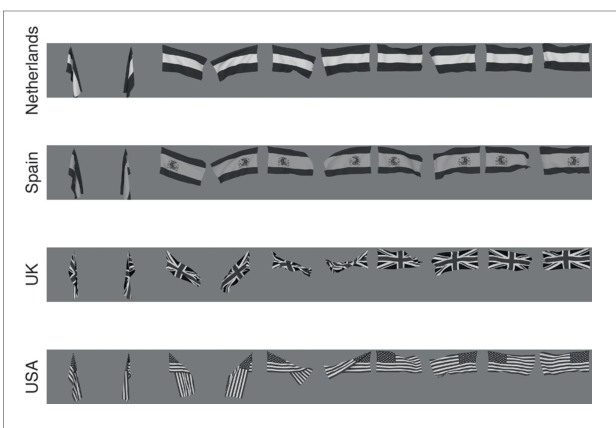
图 3 · 视觉系统的收敛架构
原文图注:FIGURE 3 | Convergence in the visual system. Right—as it occurs in the brain. V1, visual cortex area V1; TEO, posterior inferior temporal cortex; TE, inferior temporal cortex (IT). Left—as implemented in VisNet. Convergence through the network is designed to provide fourth layer neurons with information from across the entire input retina.
左右对照脑与模型的对应关系:V1→V2→V4→TEO→TE 的等级收敛,使第 4 层每个神经元的感受野覆盖整个输入视网膜。这是全文的解剖学骨架:正因为收敛,改为“前层的局部特征组合被逐层汇聚到具有大感受野的第4层模拟神经元,使其能够形成跨视角的选择性表征”。,不变性才能层层累积。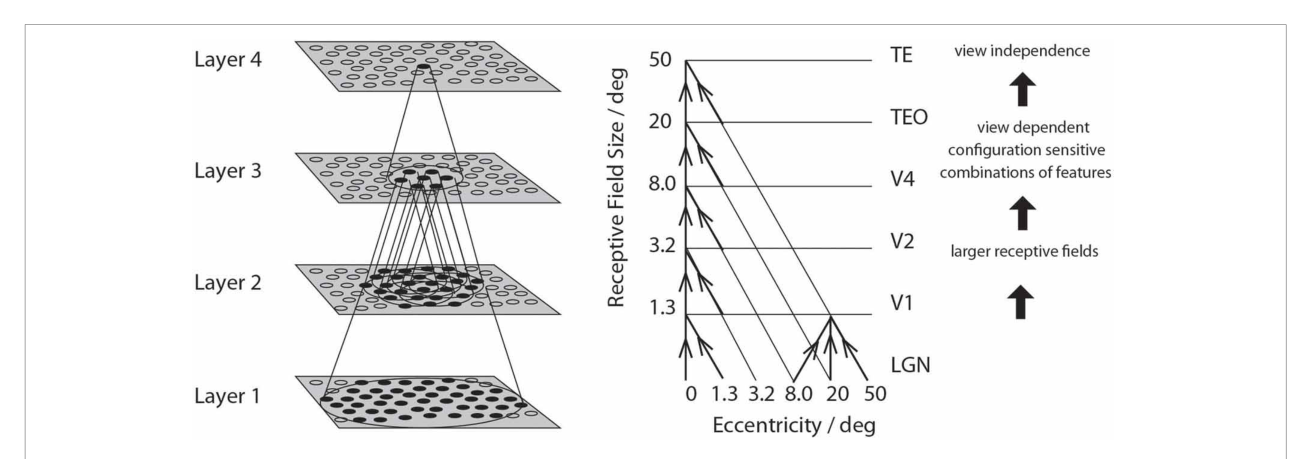
图 4 · 按身份训练后的身份不变表征
原文图注:FIGURE 4 | Information analysis of the network trained to recognize human stimuli. (A) Firing rate response of the best single cell responding to an individual, the soldier, independently of poses and views. The transforms vary fastest over views. Thus transforms 1–12 are all views of pose 1, followed by all views of pose 2, etc. (B) Firing rate response of another single cell responding to an individual, the woman, across most poses and views, and not responding to most poses and views of the two other individuals. (C) A sorted ranking of the information for the set of 25 single cells with the highest information for each stimulus. (D) The multiple cell information of the network using the set of five best cells for each stimuli.
四个面板:最佳细胞的放电率反应直方图(横轴 36 个变换:先姿态 1 的 12 视角、再姿态 2 的……),对"士兵"连续整齐地高、对他人齐零(图 4A,1.59 bit);另一个细胞示"女人"选择性稍逊(1.5 bit,图 4B);(C) 是按信息量排序的前 75 个细胞;(D) 给出多细胞信息 1.55 bit ≈ 96% 正确。它支撑结果第 1 条:身份训练让网络"认人不认姿势"。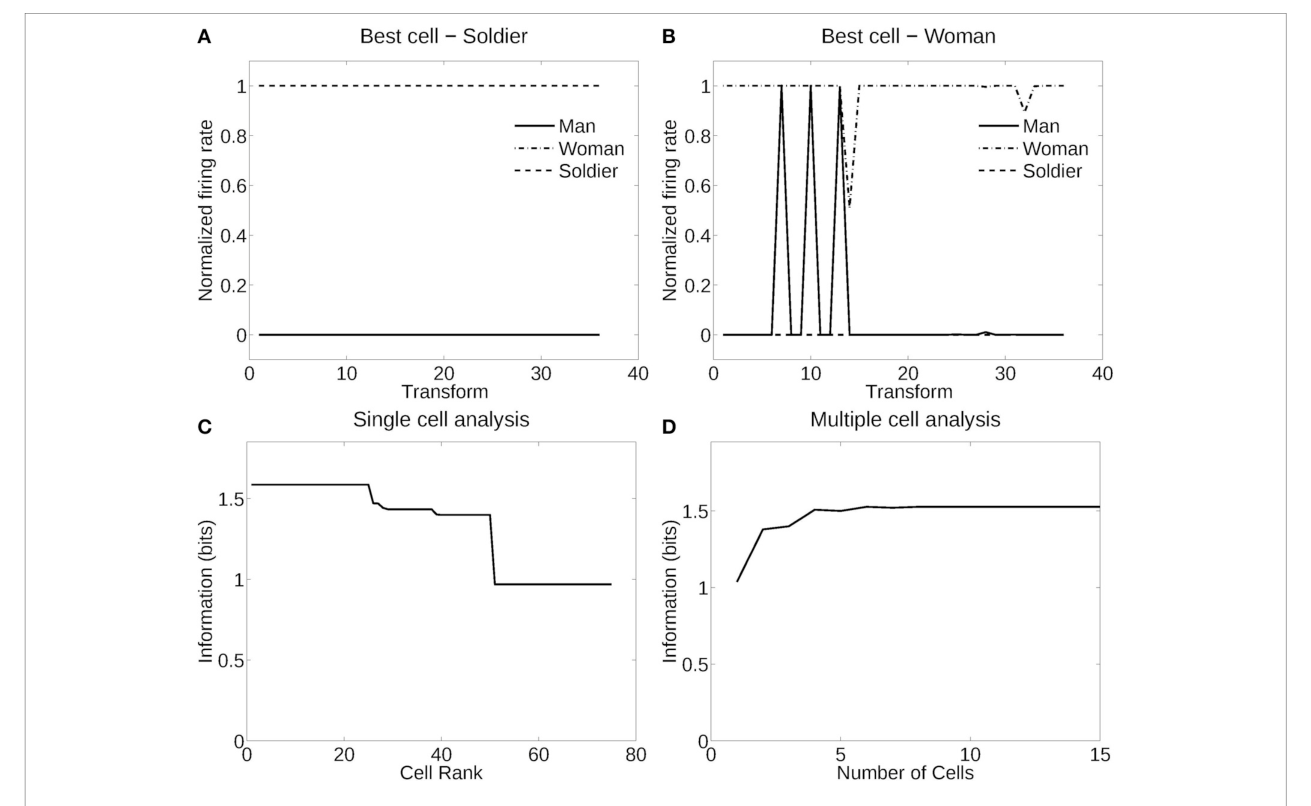
图 5 · 按姿态训练后的姿态不变表征
原文图注:FIGURE 5 | Information analysis of the network trained to recognize human poses invariantly with respect to individual and view. (A) Firing rate response of a single cell with responses to the pose of sitting almost invariantly with respect to the 3 individuals and 12 views. Transforms vary fastest over views. (B) Firing rate response of a single cell with responses to the pose of standing almost invariantly with respect to the 3 individuals and 12 views. (C) A sorted ranking of the information for the set of 25 single cells with highest information for each pose. (D) The multiple cell information of the network using the set of five best cells for each pose.
与图 4 同一套读法,但选择性换轴:图 5A 的细胞对"坐姿"(3 人×12 视角共 36 个变换)都反应、对其他姿态不反应(1.59 bit),图 5B 对"站姿"。多细胞信息 1.55 bit ≈ 96% 正确。与图 4 并排看,即是"同一网架构、同一套刺激、两种训练顺序、两种相反的不变性"这一核心结论的图形证据,支撑结果第 2 条。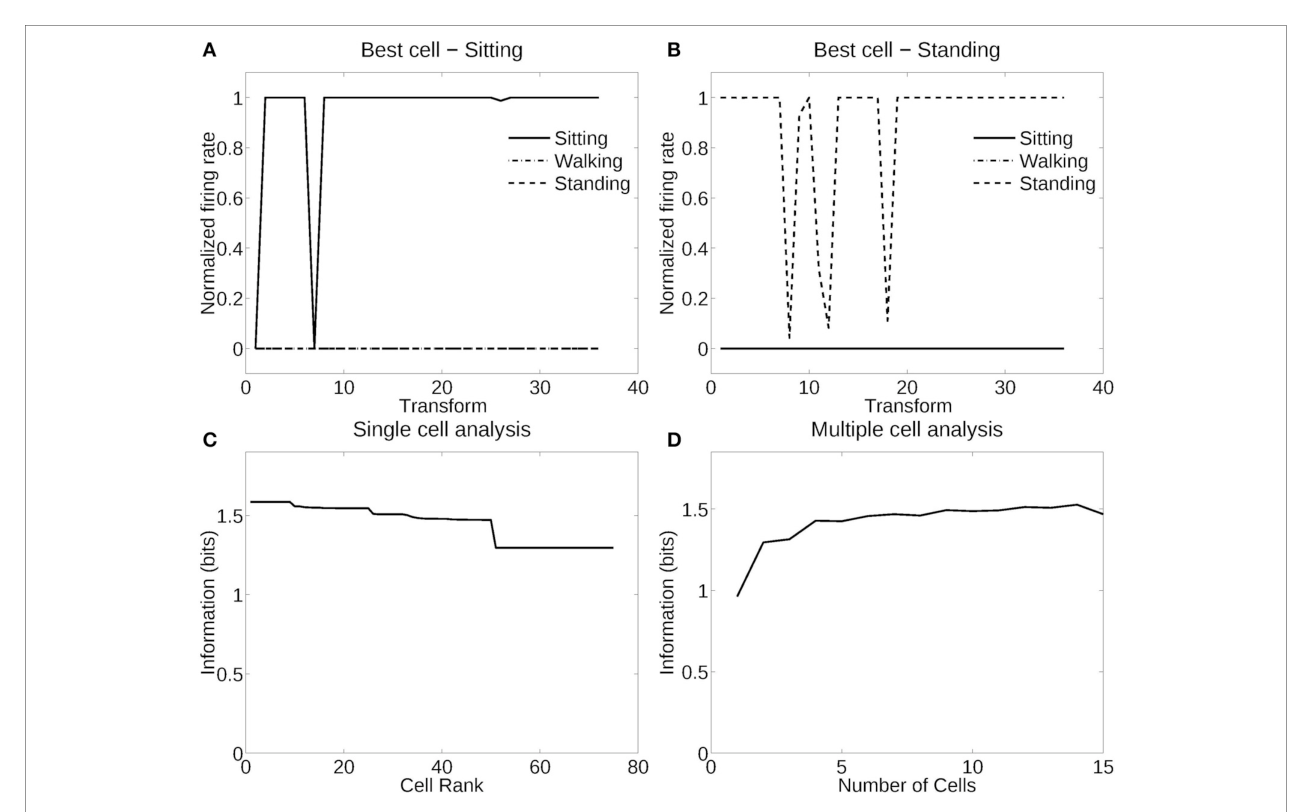
图 6 · 旗帜国别的不变识别
原文图注:FIGURE 6 | Information analysis of the network trained to recognize flag countries invariantly with respect to deformation produced by different windspeeds and views. (A) Firing rate response of a single cell with responses to the USA flag invariantly with respect to the five windspeed deformations and two views. Transforms vary fastest over views. (B) A sorted ranking of the information for the set of 25 single cells with the highest information for the flag of each country. (C) The multiple cell information of the network using the set of five best cells for each pose.
对"美国旗"的细胞跨 5 档风速×2 视角响应整齐(图 6A,单细胞信息量 2.0 bit 即 log₂4 的上限);(B) 显示每国前 25 个高信息量细胞排序后接近满值;(C) 多细胞信息量 2.0 bit、100% 正确。它支撑结果第 3 条:形变识别模式之外的"物体识别模式"对会变形的物体同样有效。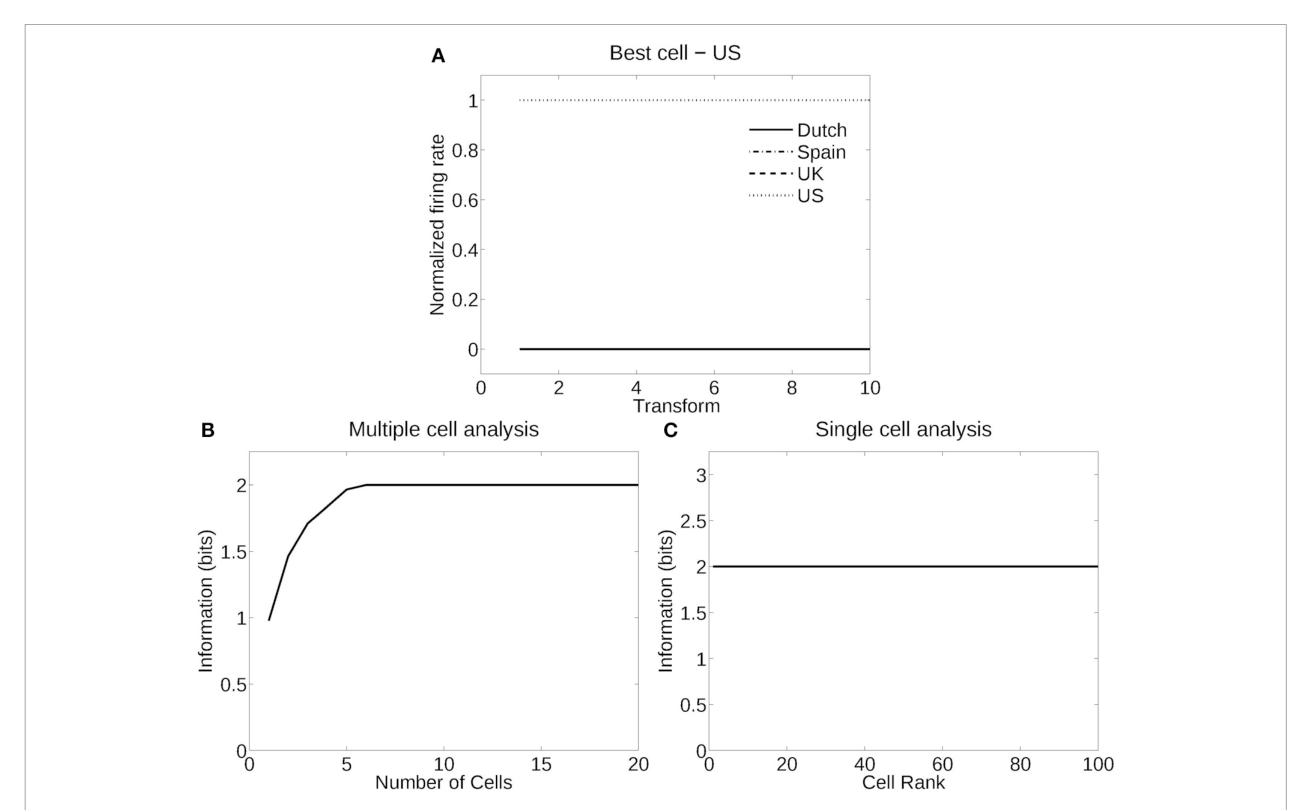
图 7 · 风速形变的不变识别
原文图注:FIGURE 7 | Information analysis of the network trained to recognize flag deformation invariantly with respect to flag country (four) and views (two). (A) Firing rate response of a single cell with responses to the windspeed with deformation parameter 150 invariantly with respect to the four country flags and two views. Transforms vary fastest over views. (B) A sorted ranking of the information for the set of 25 single cells with the highest information for each of the five deformations (windspeeds). (C) The multiple cell information of the network using the set of five best cells for each deformation (windspeed).
横轴仍是物体的全部变换(按风速块排列),此时选择性方向反转:对风速 150 这一档,细胞在 4 面旗×2 视角上都反应、对其他风速几乎不响应(2.32 bit=log₂5 上限)。多细胞信息量同样满值 2.32 bit、100% 正确。它是图 6 的镜像,支撑结果第 4 条:网络学到的是一个纯"形变"概念。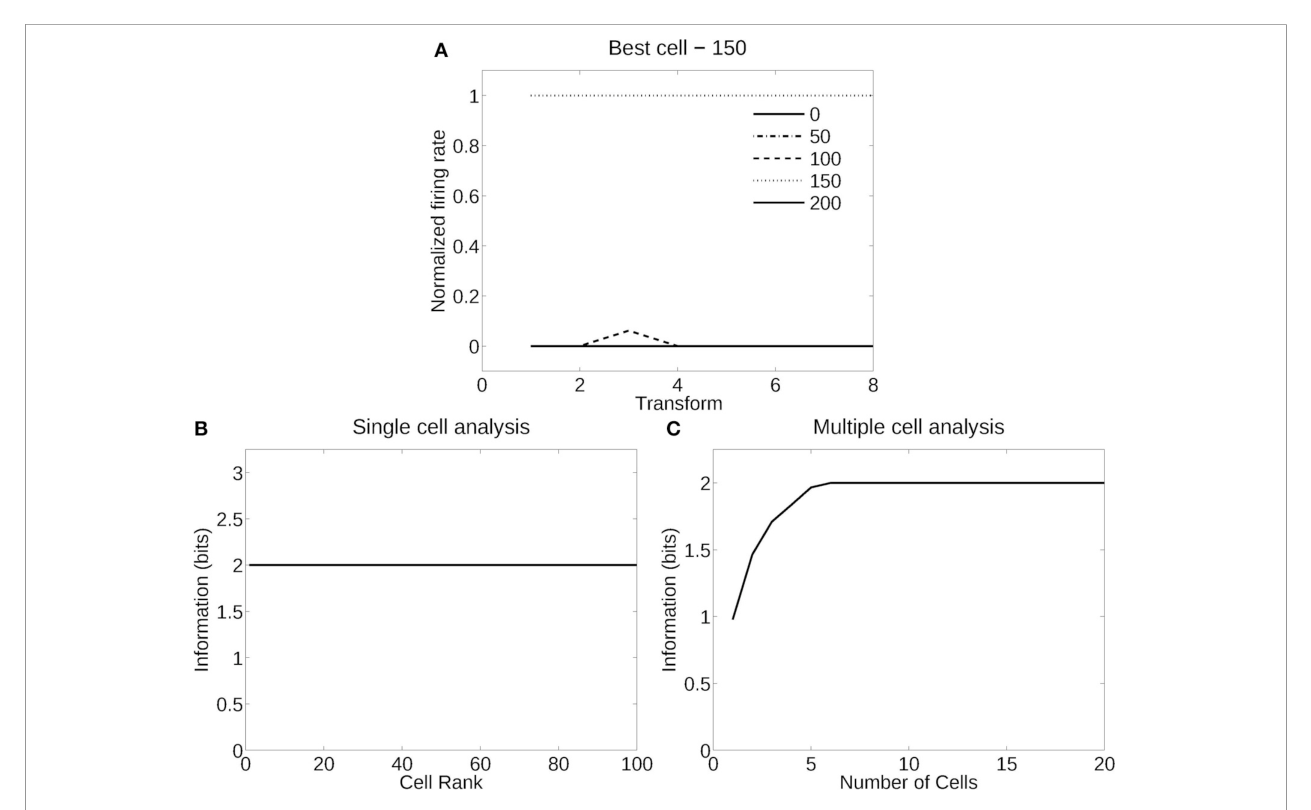
图 8 · 容量测试用的额外 NATO 旗帜
原文图注:FIGURE 8 | Four more of the set of 24 more flag stimuli used to train VisNet to test how many flags could be recognized independently of deformation (see text). Each flag is shown with different wind forces and rotations. Starting on the left the first pair, both the 0° and 180° views are shown for windspeed 0, and each successive pair is shown for wind force increased by 50 blender units.
与图 2 完全同构:另外 24 面北约旗帜中的 4 面,各自 5 档风速×2 视角。这张图本身不带结果,只为图 9 的容量实验提供刺激总览,说明容量测试的物体集合(28 面)与训练管道一致。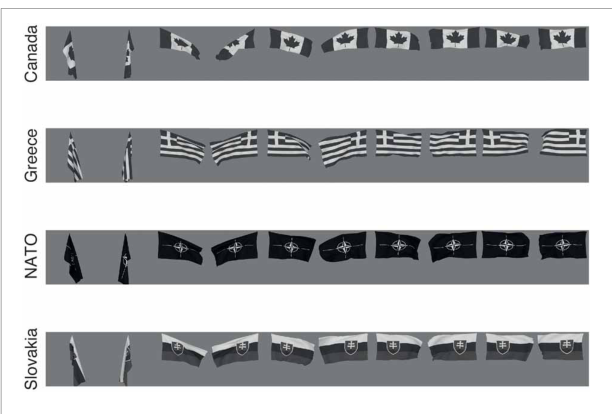
图 9 · 形变不变识别的容量曲线
原文图注:FIGURE 9 | Performance of the network when trained and tested in deformation invariant object recognition for different numbers of objects, in this case flags each in five deformations and two views. The set of neurons used were the five cells with the highest single cell information for each country. The mean and standard deviation of the percent correct are shown, taken from 20 trials, with each trial using a different random subset of the 28 NATO flags. In all trials, the network was trained with 60 epochs in each layer.
横轴为旗帜数量、纵轴为正确率(每点为 20 次随机子集试验的均值与标准差)。曲线在 8 面以内几乎持平于 100%,随后渐降:10 面 92%、15 面 86%、20 面 79%。它说明"形变不变"识别不是两面旗的小把戏,但也坦率给出容量上限,支撑结果第 5 条的前半。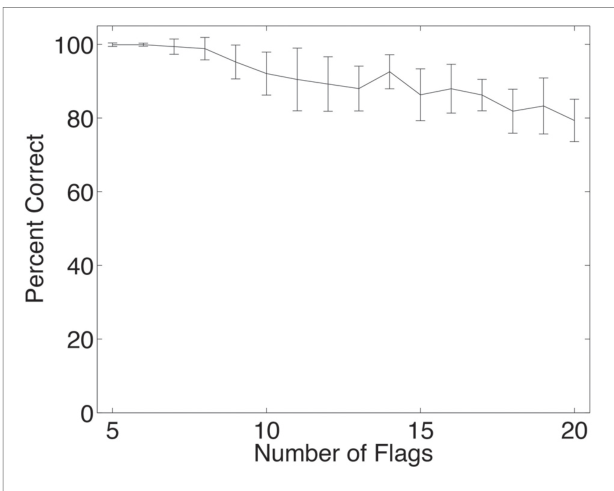
讨论
作者把结论归结为一个机制命题:同一种带痕迹的赫布学习,配上"训练序列内谁在连续"的不同统计,就能分别造出姿态特异/身份不变与身份特异/姿态不变两种表征——模拟结果全部证实了这一点,同时附加了容量可扩展与跨个体泛化两条加分项。他们随即把这套机制接到已有的生理学证据上:上颞沟的表情选择细胞与 IT 的身份选择细胞、面部视角细胞、行走选择细胞,都可由"自然环境中何时存在连续性"的统计差异解释;并给出一个有趣的皮层组织预测——编码姿态(大尺度场景性)的神经元应靠近表征场景的脑区,编码身份的应靠近表征单个物体/面孔的脑区,且自组织拓扑映射会把两类表征在一定程度上分区,行走这类带运动的姿态还可能与运动相关神经区相邻。与前人工作的对话面很宽:迹学习假说此前已在平移、尺寸、视角、光照不变性上建立,猕猴家养环境中自发观看物体即可形成视角不变的 IT 神经元(Booth 与 Rolls 1998)、以及 Li 与 DiCarlo 2008–2012 的交换实验都支持时间连续性的作用;慢特征分析(slow feature analysis)等模型走了类似原理,HMAX 加上迹规则后仍与 IT 表征有差距。局限也在文中可见:全部结论来自模拟(其局限性在于形变/姿态的双轴独立性尚未有直接生理检验),改为“容量曲线随旗帜数量增加而下降,到20面旗时为79%;这显示有限容量,但未确定严格的容量上限”。,而交叉验证的姿态识别在个体间波动很大(30–92%)。
一句话总结
按我的理解,这篇文章最重要的洞见是"不变性不是单个轴的属性,而是配对组合出来的"——姿态不变与身份不变本来就是同一套时-空连续性原理在两个正交统计轴上的两次应用,这在概念上把姿态识别从身份识别中解放了出来。当然要清醒:VisNet 的刺激是自己渲染的规则物集,"真实世界里坐在剧院的人依次被注视"这类场景统计是否充足并未量化,76% 的跨个体泛化也尚远不及人类实际能力;但对想理解不变性从何而来的人,一幅"学习顺序决定学到哪种不变"的因果图景是很有启发性的。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[A, B] - Fig5: 提取质量
good,对齐度full,识别面板[A, B] - Fig6: 提取质量
good,对齐度full,识别面板[A] - Fig7: 提取质量
good,对齐度full,识别面板[A] - Fig8: 提取质量
good,对齐度full,识别面板[] - Fig9: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'classification': 'INTERPRETATION', 'current_text': '两种情形下呈现的图像集合完全相同,唯一变化是呈现顺序——这把‘学什么不变’干净地归因于视觉输入的时间统计。', 'assessment': '在VisNet模拟的限定范围内,这是由受控训练顺序操纵支持的机制性解释;但它不能建立灵长类皮层中同一机制的因果性。', 'recommended_fix': '加上限定语“在该模型及所用刺激集合内”。'} -> 评注: 在VisNet模拟的限定范围内,这是由受控训练顺序操纵支持的机制性解释;但它不能建立灵长类皮层中同一机制的因果性。
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'classification': 'INTERPRETATION', 'current_text': '作者顺手预言了两类表征应在皮层上分区存放。', 'assessment': '原文将这种空间邻近与分区描述为有趣预测和可能结果,而不是已经观察到的事实。', 'recommended_fix': '改为“作者提出可检验预测:两类表征可能邻近不同功能区,并可能形成一定程度的空间分离”。'} -> 评注: 原文将这种空间邻近与分区描述为有趣预测和可能结果,而不是已经观察到的事实。
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'classification': 'OVERCLAIM', 'current_text': '一幅‘学习顺序决定学到哪种不变’的因果图景', 'assessment': '训练顺序对模型输出具有操纵性因果作用,但论文没有动物神经记录、行为实验或直接脑干预,不能据此宣称真实视觉系统中的因果机制已被证实。', 'recommended_fix': '改为“一个关于训练顺序如何决定模型所学不变性方向的机制假说”。'} -> 评注: 训练顺序对模型输出具有操纵性因果作用,但论文没有动物神经记录、行为实验或直接脑干预,不能据此宣称真实视觉系统中的因果机制已被证实。
- 补充要点: : (第 2 页)
- 补充要点: : (第 8 页)
- 补充要点: : (第 5 页)