IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
167| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:passAstra裁决:compromise_revision(revise)
Biologically inspired visual model with preliminary cognition and active attention adjustment
Qiao · IEEE Transactions on Cybernetics · 2015 · Zotero itemID=1584
这是 Qiao 团队在其 2014 年"给 HMAX 加入记忆与联想"工作之上的升级版:作者在经典的分层最大池化模型(HMAX)之上,补上了灵长类前部下颞叶皮层(AIT)才有的两件事——初步认知(preliminary cognition,先判断"这是什么东西类别、处于什么状态")与主动注意调节(active attention adjustment,据此旋转图像、剔除被遮挡部件、挑选可用特征)。记忆侧则引入卷积深度置信网络(CDBN)自动学习情节特征,并把同一物体不同成分的特征分簇存储、以"环式放电"(loop discharge)方式完成联想识别。在 CAS-PEAL-R1 与 AR 两个人脸库上,模型对遮挡与旋转表现出明显鲁棒性,且在围巾遮挡约 40% 面部的 AR 测试中大幅优于特征脸与 LBP 两个纯计算方法。
研究背景
HMAX 模型按照腹侧通路 V1→V4 的层级自下而上结构设计,通过模板匹配(S 层)与最大池化(C 层)交替,能输出对位置与尺度容忍的特征,在识别任务上长期作为"生物启发"的标杆。作者团队此前的工作已经把记忆与联想机制接进 HMAX:被记忆物体同时用图像块(对应人类的情节记忆)与语义属性(对应语义记忆)表示,并让"熟悉度判别"先于"回想匹配"执行,以模拟人对陌生刺激快速反应的心理过程。但该框架仍有一个明显短板:认知鲁棒性不足——在遮挡、旋转等"状态变化"面前,前馈识别会显著退化。
作者指出的另一个缺口是 HMAX 止步于后部 IT:真实视觉系统的下颞叶皮层(尤其是前部 IT)承担着类别归类与个体辨识的分离处理,还能编码物体的姿态、遮挡等"状态",并接受自上而下(top-down)注意的调制。这些机制——分类先于辨识的时序、物体状态在 IT 中的编码、以及额叶/顶叶(FEF、LIP)经皮层间前馈与反馈投射实现的注意控制——都有电生理与 fMRI 证据,却没有进入当时的层级识别模型。本文正是要用建模的方式把这三块生物学证据"补"进 HMAX。
研究思路
总体框架是一个五模块的闭环:Block 1 为已知物体;Block 2 提取每个物体各成分的特征,情节特征(episodic features,HMAX 的 C1 图像块与 C2 特征,或由 CDBN 自动学得)与语义特征(semantic features,如几何属性)成对存放在同一处;Block 3 是分布式记忆——所有物体的第 j 类特征聚在同一个记忆区 Fj,识别时各区并行给出候选身份,最后按"多数区域共同放电"的环式放电规则得出最终 ID,其融合用公式 i = argmax α·Pi,其中 α 为各区特征在训练集上的识别正确率(先验置信),Pi 为 SVM 的概率输出;Block 4 是 HMAX(对应 V1—后部 IT);Block 5 则模拟 AIT:先做类别认知(用 C2 特征相似度/SVM 判断测试物体是不是脸,把整个网络收窄到对应类别的子网络),再做状态认知(朝向、遮挡),然后主动调节——把脸旋转到正面、剔除被遮挡成分、只把可用特征送入联想识别。
这个设计的逻辑链直指人类视觉的时序证据:分类与辨识不是同时完成的(Rosch 1999;Grill-Spector & Kanwisher 2005 的"认出它在那儿就知道它是什么"),初步响应足以支持检测与归类、更长加工才够辨识;同时 IT 内有视点调谐细胞对姿态变化选择性响应而对尺度位置稳健,使"先判状态、再补偿状态"在生物学上站得住。主动调节的价值在遮挡场景下最直观:与其让整体特征被黑块污染,不如先查出哪个部件被挡、再只用干净部件的特征投票——这既呼应"陌生面孔靠图像表征、熟悉面孔靠结构表征"的二分法(Burton & Jenkins 2011),也让存储需求下降,因为不必为同一物体的所有视角都建立完整记忆。
方法
模型的实现以人脸识别为例。特征侧:用主动形状模型/ Stasm 提取 76 个面部控制点,按左眼、右眼、鼻、嘴四个成分截取 C1 层图像块(三个候选尺度 2、6、10 经交叉验证选定尺寸 10,40 人 ×5 张训练图共 800 个块),并在 20×20 像素的成分区域上计算 C2 特征;语义特征为基于 76 点计算的 17 个几何属性,归并为眼、鼻、嘴三组。CDBN 侧:图像缩放到 160×120(长边 160)、ZCA 预处理增强对比,从 200 张训练图随机抽 10000 个 31×31 图块训练第一层 CRBM(24 个 10×10 滤波器、池化比 2),第二、三层结构相同逐层堆叠;可视化显示第一层学到类似 Gabor 的朝向边缘、第二层学到器官部件、第三层学到整脸。不过作者随后说明,CDBN 只在超大数据集上才显优势、不适合本任务,因此最终实验全部采用 HMAX 提取情节特征,CDBN 留作未来扩展。
识别流程分四步:预处理与特征提取;记忆过程(七类区域特征:眼/鼻/嘴的语义特征与左眼/右眼/鼻/嘴的 C2 特征,各训练一个 SVM,用其在原始相位训练集上的正确率作为置信系数);初步认知与主动调节(类别分类的 SVM 正样本为四个相位的全部训练人脸、负样本为从 Caltech-101 的 92 个非脸类别中抽取的近似等量图像;朝向用左右眼中心坐标差的反正切公式计算并旋正,遮挡检测用无遮挡记忆的 C2 特征与测试图一致周边区域的 C2 特征做多类 SVM 比较,被遮挡成分的情节与语义特征双双剔除);总体认知(公式 (5) 的环式放电加权投票,无遮挡时共有 7 维特征参与)。评测在两个人脸库上进行:CAS-PEAL-R1(随机选 40 人,每人 5 张训练、5 张测试,原图 480×360 缩至 160×120,另对训练/测试集施加随机遮挡单眼、±45° 随机旋转及两者叠加,形成四个相位);AR 库(126 人中随机选 20 男 20 女,以中性表情与"angel"光照态图像为训练、戴围巾图像为测试)。
主要结果
-
C2 特征全面优于语义特征作为身份线索(图 9)。七个区域 SVM 在训练集上的置信系数显示:C2 特征的置信系数始终远高于语义特征,且人数增加时语义特征的置信度快速骤降、C2 特征仅缓慢微降——说明低层轮廓化的 C2 码在人数扩展时更耐打,语义特征更适合辅助描述与省内存而非主判别。
-
初步认知各环节的精度(图 11、12)。主要结果第 2 条及图 11 解读中的对应表述统一改为:“C1 patch 尺寸大于 4 时,人脸与非脸两类图像的检测准确率均接近 100%(图 11a)。”;遮挡检测精度随 patch 增大而上升,在尺寸 10 处最佳——原始相位 99.0%、遮挡相位 98.0%(图 11b),故统一采用尺寸 10。朝向评估的误差绝大多数小于 4°(图 12),但当旋转角过大或部件被遮挡时 Stasm 定点不准,实验中改用手动标定。
-
环式放电的融合优于任何单区(图 13)。在 CAS-PEAL-R1 原始相位测试集上,总体模型(虚线)的成绩稳定压过七个单独 SVM 分类器(实线),证明多区概率输出加权投票的融合有效,也佐证了"多数区域共同放电"这一联想机制的算法价值。
-
四个相位上的鲁棒性(图 14)。旋转相位与原始相位的表现几乎重合——朝向评估与旋正基本消解了旋转扰动;遮挡相位与遮挡—旋转相位同理相互贴合。由于遮挡相位中每张图总有一只眼睛被黑块盖住,依赖眼部特征的 SVM 无法贡献,总体成绩略有下滑,但损失仅约 8%,显示模型对遮挡的鲁棒性可观。
-
与既有方法的对比(图 15、16 与表 II)。在无遮挡、无旋转的原始相位上,新模型虽然用不上初步认知与主动调节的"加分项",仍一致且大幅优于作者上一版模型(人数越多优势越大),并优于特征脸(Eigenfaces+最近邻)、与 LBP(+最近邻)相当——归功于环式放电及以概率输出取代旧模型的简单排序。真正拉开差距的是 AR 库的围巾遮挡测试:围巾遮掉约 40% 的面部,特征脸与 LBP 因从整幅图像提特征而性能大幅受累,新模型则依据初步认知只取未遮挡区域的局部特征组合投票,以明显优势胜出(正文仅作定性陈述,表 II 的具体数值在本文文本层中未被提取,无法复核)。
图注解读
图 1 · 模型总体框架
原文图注:Fig. 1. General model framework proposed. The braces mean relation of subordination, the dotted lines mean congruent relationship, and the arrows mean process.
这是全文的骨架图:五个模块(已知物体、特征提取、记忆与联想、HMAX 层级、模拟 AIT 的初步认知与主动调节)由箭头串联成"记忆—初步认知—主动调节—联想识别"的闭环,花括号表示从属关系、虚线表示对应关系。读图要点是 Block 5 不在 Block 4 的前馈链上"接着算",而是回头调度 Block 4 与 Block 3——这正是"主动"二字的含义。该图支撑研究思路部分的总体设计。
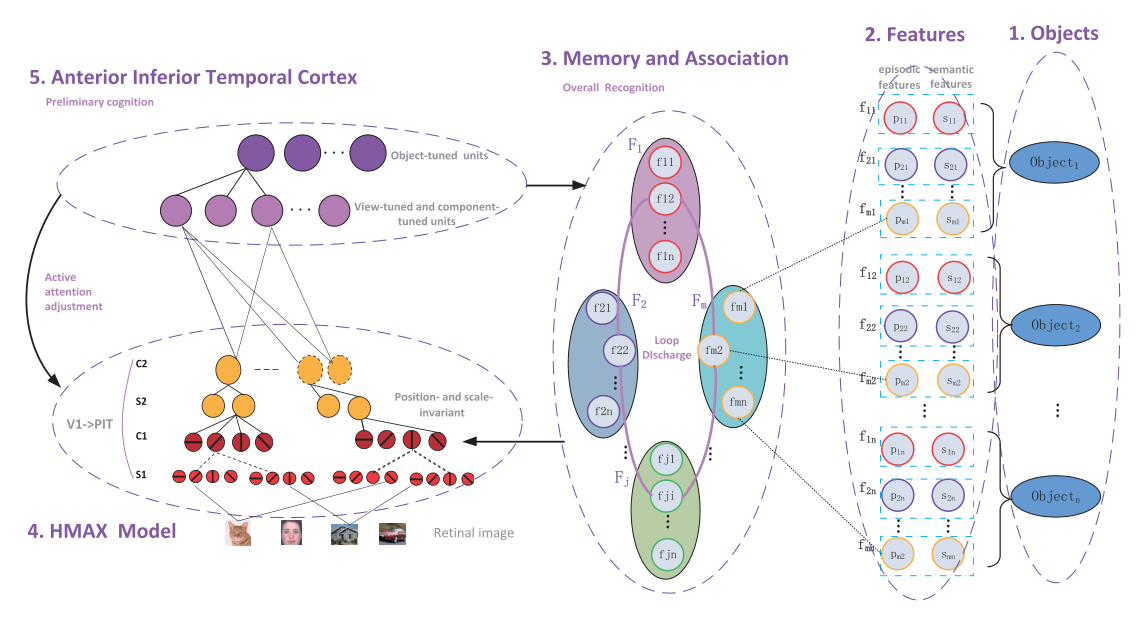
图 2 · 带最大池化的单层 CRBM
原文图注:Fig. 2. Single layer CRBM with maxpooling. We only show group k for the feature map and pooling layer for simplicity.
以第 k 组为例展示卷积受限玻尔兹曼机(CRBM)的结构:可见层输入经共享滤波器 Wk 卷积得到隐藏特征图,再接概率最大池化层。此图是 Block 2 中"用深度网络自动学情节特征"的技术底座,对应方法部分 CRBM 能量函数与训练方式(对比散度)的说明。
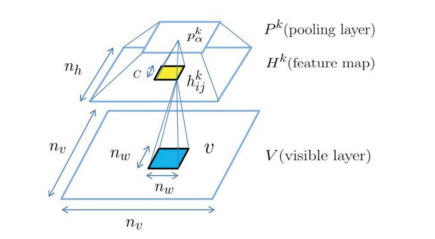
图 3 · 已知人脸及其特征
原文图注:Fig. 3. Known faces and their features.
示意一个被记忆的人脸如何被拆解:四个成分(左眼、右眼、鼻、嘴)各自对应一对情节特征(C1 图像块与 C2 特征)和语义描述(如"大眼睛""小嘴"),两类特征成对存放。它把"情节记忆/语义记忆"的认知科学二分(Tulving)落到了模型的数据结构上。
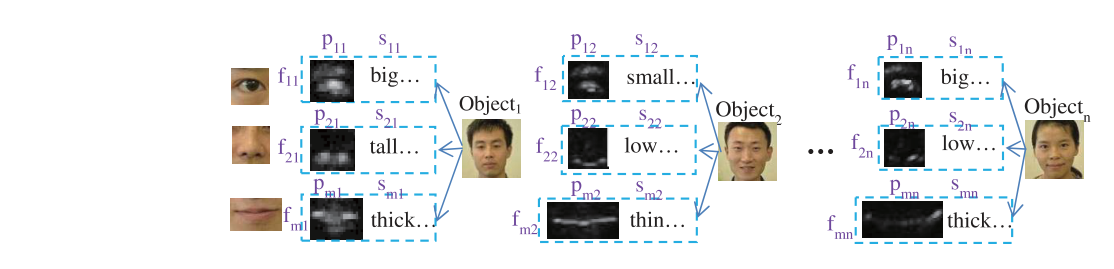
图 4 · 人脸识别任务的实现流程
原文图注:Fig. 4. Implementation of the new model for the face recognition task.
把图 1 的抽象框架实例化为人脸任务的数据流图:Block 1/2 提取特征,Block 3 分布式记忆,Block 4/5 依次做类别分类、朝向评估与旋正、遮挡检测与特征选择,最后经公式 (5) 的环式投票输出 ID。配合正文算法 1 阅读,可逐行对上初步认知与主动调节的执行顺序。
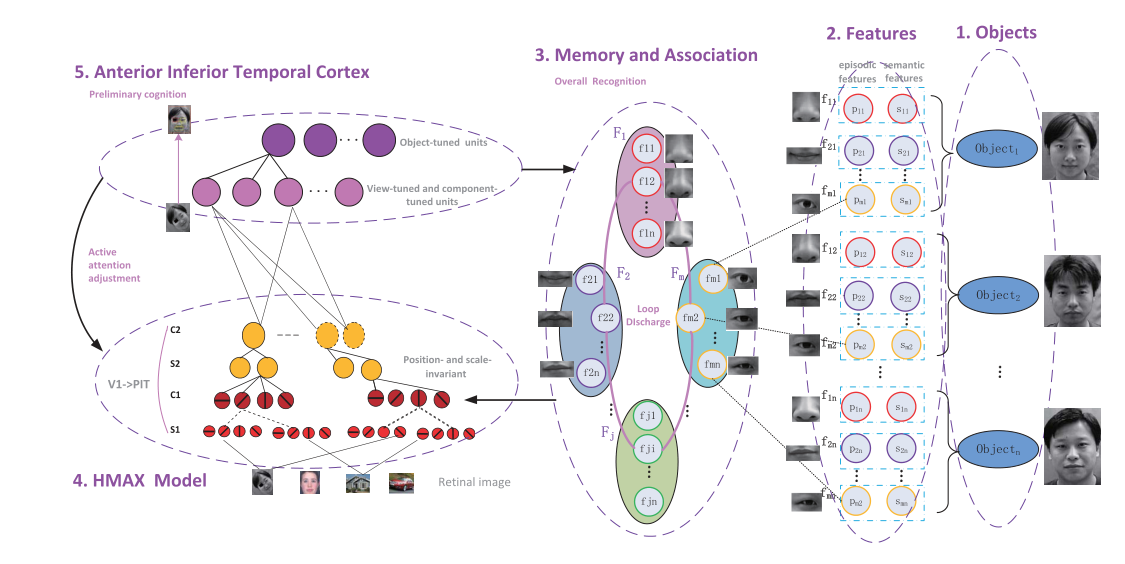
图 5 · CAS-PEAL-R1 样例
原文图注:Fig. 5. Some examples of persons from the CAS-PEAL-R1 database.
实验一所用人脸库中若干人的样例肖像,涵盖轻微表情、饰物与光照变化。它交代了评测对象的基本难度:40 人 ×(5 训练 + 5 测试),图像由 480×360 缩至 160×120。
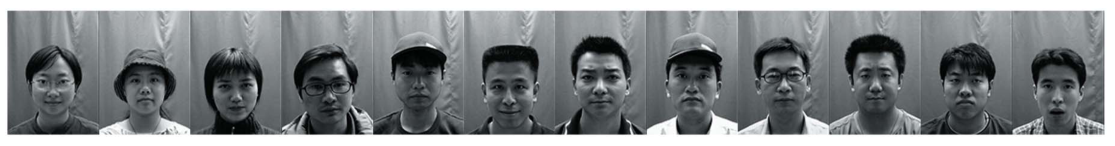
图 6 · 四个相位的训练与测试图像
原文图注:Fig. 6. Training and test images of the first person at four different phases (e.g., the third row of the left part are the training images at the occlusion phase).
以第一人为例展示四个相位(原始、遮挡、旋转、遮挡—旋转)的训练与测试图像,遮挡方式为随机等概率盖住左眼或右眼,旋转为 ±45° 随机角。这张图定义了"不变性考题"本身,是解读图 14 各相位成绩的前提。
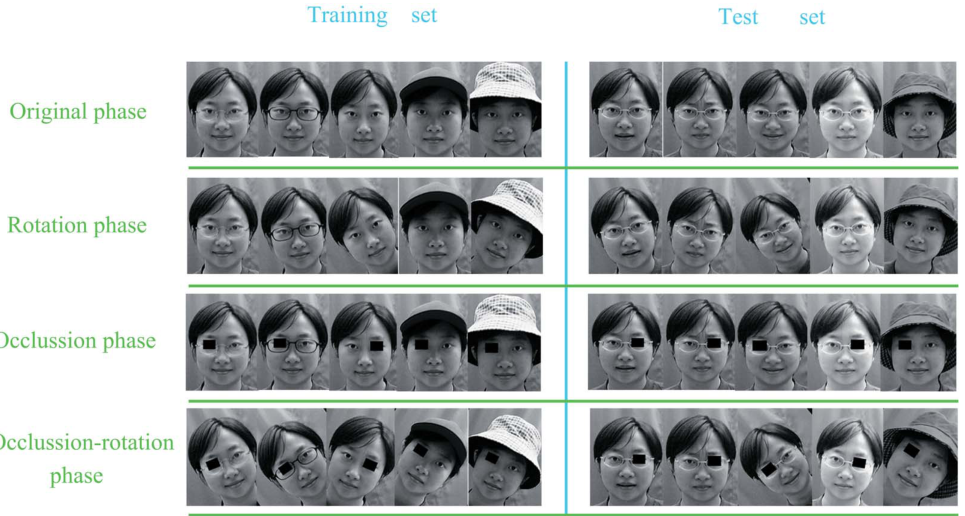
图 7 · CDBN 三层基的可视化
原文图注:Fig. 7. Visualization of (a) first, (b) second, and (c) third-layer bases. The first layer bases are visualized as "images." The second and the third layers bases are visualized as the patterns (which are obtained by hierarchical inference of the CDBN) most liked by the second and third layer's hidden units, respectively.
三层 CRBM 学到的特征:第一层基直接以"图像"呈现,呈定向局部边缘(类 Gabor);第二、三层以隐藏单元最偏爱的输入模式呈现,分别是器官部件与整脸。这与 Hubel–Wiesel 式"边缘→部件→物体"的层级直觉吻合,支撑方法部分对 CDBN 学特征的设想;不过正文随后说明最终实验改用 HMAX 特征。
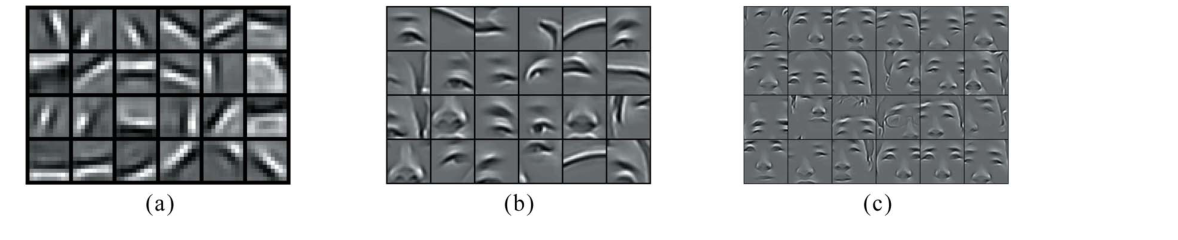
图 8 · Stasm 76 个控制点
原文图注:Fig. 8. Samples with 76 special points obtained with the Stasm.
展示 Stasm 在样例脸上标出的 76 个面部控制点。这 76 点是 17 个几何语义属性的原始材料(归并为眼/鼻/嘴三组语义特征),也是朝向计算所用左右眼中心坐标的来源,衔接方法部分 Step 1.2 与 Step 3.2。
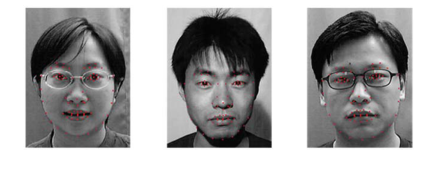
图 9 · 七个置信系数随人数变化
原文图注:Fig. 9. Seven confidence coefficients when the number of persons varies.
横轴为人数、纵轴为各区域 SVM 在训练集上的识别正确率(即公式 5 中的先验 α):四条 C2 特征曲线(左眼、右眼、鼻、嘴)整体高居上方且随人数下降平缓,三条语义特征曲线(眼、鼻、嘴)明显更低且随人数骤降。支撑主要结果第 1 条。
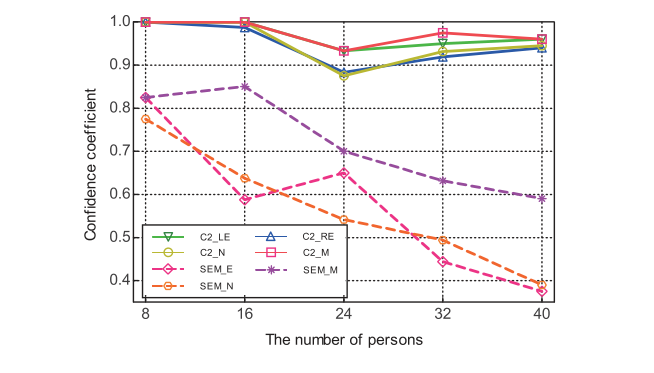
图 10 · Caltech-101 负样本
原文图注:Fig. 10. Some negative sample images from the Caltech-101 database.
训练人脸/非脸分类器所用负样本的示例,随机抽取自 Caltech-101 的 92 个非脸类别、数量与正样本近似相等。它说明类别分类是一个真正二选一的鉴别任务而非退化判断,对应方法部分 Step 3.1 的训练集构成。
图 11 · 人脸与遮挡检测精度随 patch 尺寸变化
原文图注:Fig. 11. (a) Face detection accuracy and (b) occlusion detection accuracy at different patch sizes.
横轴为 C1 patch 尺寸(2、4、6、8、10、12):(a) 人脸检测在尺寸大于 4 后两个相位都接近 100%;(b) 遮挡检测精度随尺寸上升、在 10 处达到峰值(原始相位 99.0%、遮挡相位 98.0%),据此统一选定尺寸 10。支撑主要结果第 2 条。
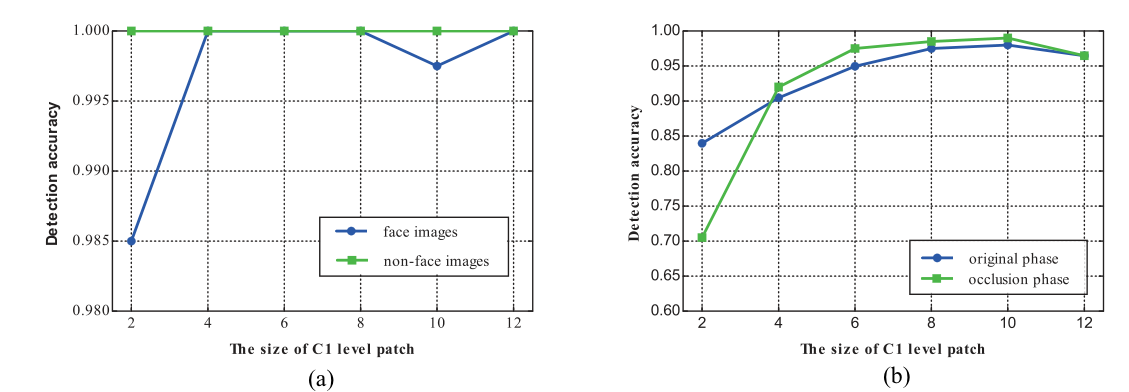
图 12 · 朝向评估的误差分布
原文图注:Fig. 12. Error distribution of orientation evaluation.
旋转相位测试集上朝向估计误差的分布直方图:绝大多数误差小于 4°,说明基于左右眼坐标差反正切的朝向估计足够支撑旋正调节。支撑主要结果第 2 条与图 14 中旋转相位成绩几乎不衰减的现象。
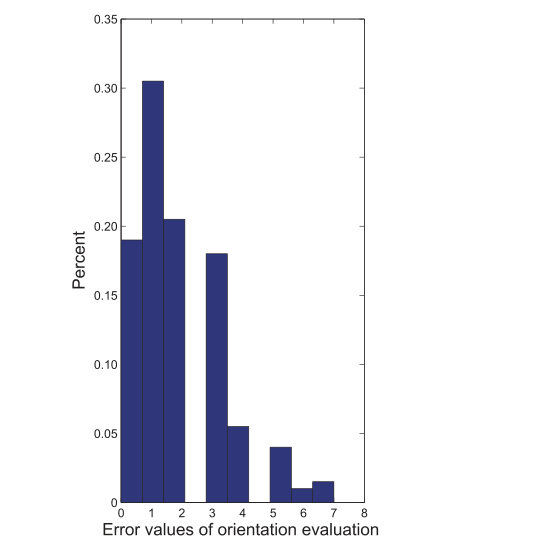
图 13 · 总体模型与七个 SVM 的对比
原文图注:Fig. 13. Recognition accuracy of the overall model and the seven SVM classifiers on the original phase of the test set from the CAS-PEAL-R1.
横轴为人数、纵轴为识别正确率:虚线为总体模型,七条实线为七个区域分类器。虚线始终居于所有实线之上,说明环式放电的多区加权融合稳定优于任何单区投票,支撑主要结果第 3 条。
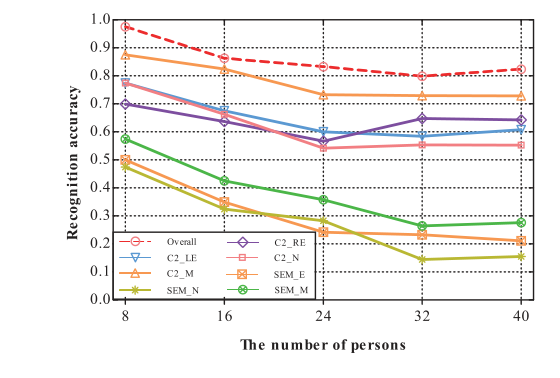
图 14 · 新模型在四个相位上的表现
原文图注:Fig. 14. Performance of the new model on the four phases of the test set from the CAS-PEAL-R1.
四个相位各一条折线(横轴人数、纵轴正确率):旋转相位与原始相位几乎重叠、遮挡相位与遮挡—旋转相位几乎重叠,两条遮挡曲线仅略低于前两条(正文估计损失约 8%)。效应方向明确:旋正机制消化了旋转、遮挡特征剔除机制把遮挡代价压到很低,支撑主要结果第 4 条。
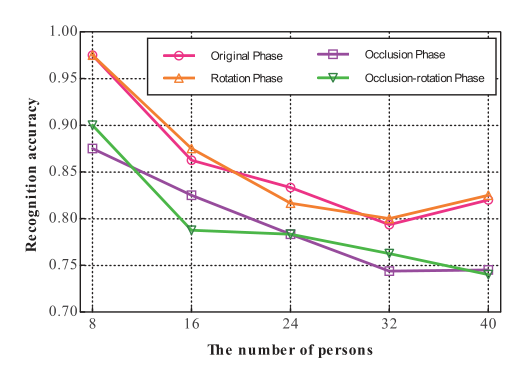
图 15 · 四种算法在原始相位的对比
原文图注:Fig. 15. Recognition accuracy of the four algorithms on the original phase of the test set from the CAS-PEAL-R1.
横轴人数、纵轴正确率,四条曲线分别为新模型、作者上一版模型、Eigenfaces(+NN) 与 LBP(+NN):新模型全程领先上一版(人数越多差距越大),优于 Eigenfaces、与 LBP 大体相当。注意这是"初步认知无用武之地"的干净场景,差距只能来自环式放电与概率融合本身,支撑主要结果第 5 条。
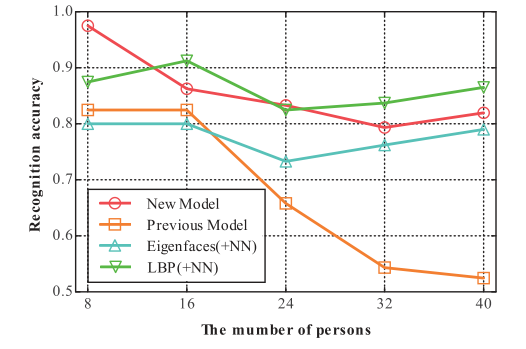
图 16 · AR 库的训练与测试图像
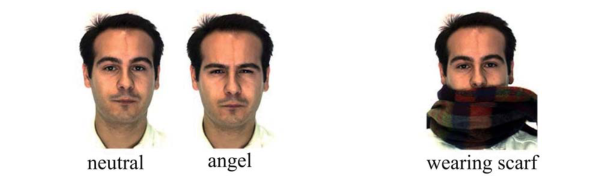
原文图注:Fig. 16. Training images (left) and test images (right) of one person from the AR database.
以 AR 库某人为例:左侧为中性表情与 angel 光照态的训练图像,右侧为戴围巾的测试图像。围巾遮住约 40% 面部,构成远比"单眼黑块"苛刻的遮挡考题,是表 II 对比结论(新模型大幅领先两个传统方法)的刺激背景。
讨论
作者在结论部分把贡献收拢为两条:其一,记忆与联想一侧,特征可由 HMAX 与 CDBN 两类层级模型提取,异类特征分簇存放、同一物体各区激活以环式放电绑定;其二,初步认知与主动调节一侧,先判类别与状态、再据先验旋正与选特征,以模仿人类认知中的自上而下效应。所有机制都标注了生物学出处(分类先于辨识的时序、IT 的视点调谐、FEF/LIP 的注意控制投射等),模型在系列对比实验中的鲁棒性则被视为"对人类视觉认知过程更深一层理解"的建模侧印证。
文中对未来工作留了几个口子,也侧面承认了当前局限:CDBN 特征学习在小数据集上不及预期、最终实验未启用;朝向与部件中心在大角度旋转或遮挡下依赖手动标定,自动化尚未闭环;框架目前只在小规模人脸任务上验证,推广到一般多类物体识别、引入情绪驱动的识别以及用深度网络学习中层级语义特征,都被列为后续方向。与 HMAX、卷积网络等纯前馈方案相比,作者的立场是:没有"先看清对象是什么、再决定往哪看"的机制,层级模型的鲁棒性上限就是图像统计的上限。
一句话总结
以今天的眼光看,这篇文章像是一次"早于 Attention is all you need 的注意力宣言":让模型先做一次廉价的类别与状态判断,再据此裁剪输入、只让干净特征参与最终投票——在围巾遮掉四成脸的 AR 测试上,这一步"先看再认"确实换来了纯前馈方法拿不到的鲁棒性。不过我也想指出(此为我的个人判断):它的"生物学实现"更多停留在机制对应层面(环式放电实为加权概率融合),且模型规模与人脸专项设定限制了结论的外推,CDBN 半途弃用也使"深度学习情节特征"这一贡献点打了折扣。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig10: 提取质量
good,对齐度full,识别面板[] - Fig11: 提取质量
good,对齐度full,识别面板[] - Fig12: 提取质量
good,对齐度full,识别面板[] - Fig13: 提取质量
good,对齐度full,识别面板[] - Fig14: 提取质量
good,对齐度full,识别面板[] - Fig15: 提取质量
good,对齐度full,识别面板[] - Fig16: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[] - Fig7: 提取质量
good,对齐度full,识别面板[] - Fig8: 提取质量
good,对齐度full,识别面板[] - Fig9: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: 像是一次"早于 Attention is all you need 的注意力宣言" -> 评注: 属评论性类比而非事实陈述,且作者明确以"以今天的眼光看""此为我的个人判断"标注为个人观点,措辞虽有文学夸张但有 hedge,不构成事实性 overclaim;可保留,但若追求严格可弱化。
- 审校纠偏: 模型鲁棒性"反映了对人类视觉认知过程的更深理解"(解读稿在讨论中作为作者立场转述) -> 评注: 这是作者本人的 INTERPRETATION(由工程性能外推至对生物认知的理解),解读稿正确将其归属为作者观点而非事实,处理得当。
- 补充要点: 对比实验的覆盖范围不对称:与旧模型、Eigenfaces、LBP 的对比只在 CAS-PEAL-R1 原始相位(无遮挡无旋转)进行,遮挡/旋转相位上新模型没有与任何基线方法比较,仅与自身在其他相位的成绩比较;真正带基线的遮挡对比只有 AR 围巾一项。这是评估"鲁棒性优势"结论强度的重要边界,解读稿未点明。
- 补充要点: 摘要宣称 "much lower memory storage requirement",但正文实验部分未给出任何存储量的定量测量或对比,该卖点在文中无数据支撑,解读稿未作提示。
- 补充要点: 朝向评估的自动化局限:原文承认旋转角过大或部件被遮挡时 Stasm 定点不准、坐标"改用手动获取",即关键实验结果部分依赖人工标注,解读稿在结果第 2 条和讨论中虽已提及,但未强调这意味着四相位鲁棒性结果并非全自动流程下取得。