IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
163| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:pass
Network Anisotropy Trumps Noise for Efficient Object Coding in Macaque Inferior Temporal Cortex
Chen · The Journal of Neuroscience · 2015 · Zotero itemID=1562
这项研究在猕猴下颞叶(inferior temporal cortex, IT,腹侧视觉通路的最后一站)约 1 mm³ 的局部组织内同时记录约 80 个神经元,逐试次地检验"噪声共变"(noise covariation,即无刺激变化时神经元放电在试次间的共同起伏)究竟帮助还是损害物体编码。结论分两面:噪声共变确实降低 IT 的物体编码能力,但真正决定编码效率的不是噪声本身,而是网络各向异性(network anisotropy,编码相关活动在神经元群里分布不均匀的程度)——高度相关、聚集在输出层的那部分神经元反而是编码的主力。它对 Barlow 式"去相关即高效编码"的经典教条给出了直接的生理学反例,值得一读。
研究背景
相关如何影响群体编码效率一直是脑加工理论的核心争论。一派证据表明相邻神经元的信息传出大体独立(噪声相关 rSC 低;Gawne 与 Richmond,1993;Zohary 等,1994;Vinje 与 Gallant,2000;Kohn 与 Smith,2005 等),由此延伸出 Barlow 式的"去相关/稀疏化支持高效加工"的主张(Barlow,1961;Olshausen 与 Field,1996)。另一派(Abbott 与 Dayan,1999;Averbeck 等,2006;Panas 等,2015 等)则推论噪声相关的效应复杂得多:取决于信号相关(rsignal,调谐相似性)与噪声相关之间的关系、群体的大小与同质性,以及编码与解码的不同视角——理论上两者同向(正相关)会损失信息,反向则可能有益。
此前的检验多是在 V1 或 MT 用少量神经元做朝向分辨,缺少的正是这一论文要补的实证:在支持物体识别的高级皮层、以密集取样的局部群体面对自然物体刺激时,编码效率如何依赖于局部的相关结构。作者团队的前期工作(Hung 等,2005 科学论文证明 IT 群体可被线性读出;Hung 等,2014;Lin 等,2014)已用密集多元电极阵列发现"调谐相关的神经元物体编码反而更好",与去相关教条相悖。本文的问题是:逐试次的噪声共变在其中扮演什么角色——它是损害了这些高相关神经元群,还是被它们所包容?以及,解码端知道相关结构是否有用?
研究思路
作者把已有密集阵列数据逐一试次重新分析,假设"噪声共变在更大且更同质的 IT 群体中损害物体编码与解码"。方法是三条腿走路:第一,用支持向量机(support vector machine, SVM)线性分类器做"未打乱"(unshuffled,真实同时记录)与"试次打乱"(trial-shuffled,在每个物体×每个单元内随机重排,模拟彼此独立的神经元)两种处理,并区分编码效应(两者都训练、都测试)与解码效应(用打乱数据训练、用真实数据测试——相当于解码器"预知"相关结构的理想情形);第二,刻画相关结构本身——信号与噪声相关的耦合、随皮层深度(cortical depth)的变化、以及按单元与同伴平均信号相关的强弱把神经元分成第 1 组(Group 1,与同阵列其他单元平均 rsignal 最高者,即前期工作所谓"合唱团/choristers")与第 2 组(Group 2,中位附近者,"独唱者/soloists");第三,向试次平均数据里注入人工噪声相关做模拟,检验效应幅度能否由相关强度参数重现。这套设计的逻辑是:如果编码优势真的与"用低维相关结构承载高维信息"的流形(manifold)表征有关,那么噪声相关的代价应集中在输出层的高相关子群,而知道相关结构的解码器不应能捞回损失。
方法
实验材料与记录来自 3 只台湾猕猴(1 雄 2 雌),在轻度神经安定麻醉与肌松下(芬太尼 0.9 µg/kg/h 静脉、70%/30% N2O/O2、0.3%–0.5% 异氟醚、肌注氟哌利多 0.25 mg/kg,肌松用罗库溴铵)从右侧前 IT 外侧面(AP16 处)插入 64 触点多深度阵列(8 柄 × 每柄 8 触点,水平与深度均为 0.2 mm 间距,共覆盖 1.4×1.4 mm),共 5 次(每次插一个阵列),阵列 2、4、5 来自同一只猴彼此相距约 3 mm 的位置;改为'跨 5 个阵列合并最多 306 个单元(单阵列 25–87 个 SUA;图 1B 的类别泛化分析即合并全部阵列)'。锋电位 400–5000 Hz 滤波后以 24.4 kHz 数字化;分析以单单位活动(SUA,WaveClus 分离)为主,多单位活动(MUA)与未分选的 threshold-crossing 数据(hash MUA)用于对照,剔除放电过少(<2000 个锋或 <4 Hz)与带缓慢速率涨落的单元;皮层深度通过插针时目视追踪确定,层次按前期 V1 同类阵列的定量标准估计(因后续损伤无法做组织学确认)。数据将上传至 crcns.org 公开。
刺激为 240 幅灰度渲染 3D 物体(无颜色与纹理,涵盖动物、面孔、植物、食物、工具、车辆、电器、家具等类别),约 10° 视角、单眼呈现、视网膜中央定位,以 5 Hz 快速序列呈现(94 ms 开 / 106 ms 关)、伪随机顺序重复 10 次;随后一个泛化块对每阵列 10 个偏好物体各呈现 25 种变化(5 姿态 × 5 光照,-45° 至 45°、22.5° 步进)。分类读出用线性 SVM(软间隔 C=10^-8),输入为刺激后 100–300 ms 的 z 归一化锋电位计数。四种检验:类别内泛化(按类训练 8 个物体、测试另外 5 个未见物体,随机水平 12.5%);物体识别(240 个物体各自一个二分类器,5 试次训练 5 试次测试,随机水平 0.42%);姿态/光照泛化(训练 4 种姿态或光照、测试未见的那一种,随机水平 10%,仅阵列 2、4——其余阵列此类较晚的记录块含麻醉积累引起的慢速率涨落,被删除);分类(8 类,试次做 5 训练/5 测试的交叉验证,并按 25 ms 时间窗做时间进程)。信号相关取各单元试次平均反应在不同物体间的 Pearson 相关,噪声相关取各物体均值扣除后逐试次偏差间的 Pearson 相关,均限不同触点间的单元对,以免同通道内的锋电位碰撞造成偏倚;各向异性按"单元与本阵列其余单元的平均 rsignal"排序分组,分组定义不使用训练或测试物体。
主要结果
-
噪声共变削弱编码、却不削弱解码(图 1–3):类别内泛化中,打乱试次(模拟独立神经元)显著优于真实数据,编码成绩降约 5%–10%,多数类别显著(faces、animals p<0.005,其余多为 p<0.01 或 0.05);物体识别(240 物体)在 50 ms 以上窗宽都有显著编码损失,说明效应并非"把类别内不同物体合并时误把信号当噪声";姿态与光照泛化同样受损(约 5%–10%)。但"知道相关结构"的解码(打乱训练、真实测试)在所有任务中都不比真实解码更好——作者援引理论认为这些相关与决策边界近于正交(Eyherabide 与 Samengo,2013)。效应在类别间不均:面孔与动物表现最高、噪声效应也最强(与 IT 中这两类的簇状表征一致),而"工具"无显著效应;没有任何类别因噪声共变而获益。
-
效应随群体规模增大、且出现极早(图 4):编码损失在每阵列 32–64 个单元时达到约 10%–15% 的相对降幅(ΔP/Pcorrected),单元很少时几乎无效应——但并非成绩触底所致(总成绩很低的阵列 3 仍表现出随规模的增强);解码端效应在所有规模都不显著(64 单元时至多 0.8%,2–8 单元时甚至略负,可能因打乱反而避免了少单元时的过训练)。时间进程上,编码效应从最早反应(约 100 ms 的 25 ms 窗)起即显著,其时间轨迹与分类读出成绩本身相似,提示它伴随快速前馈"核心"识别过程发生,而非慢速反馈或注意加工。
-
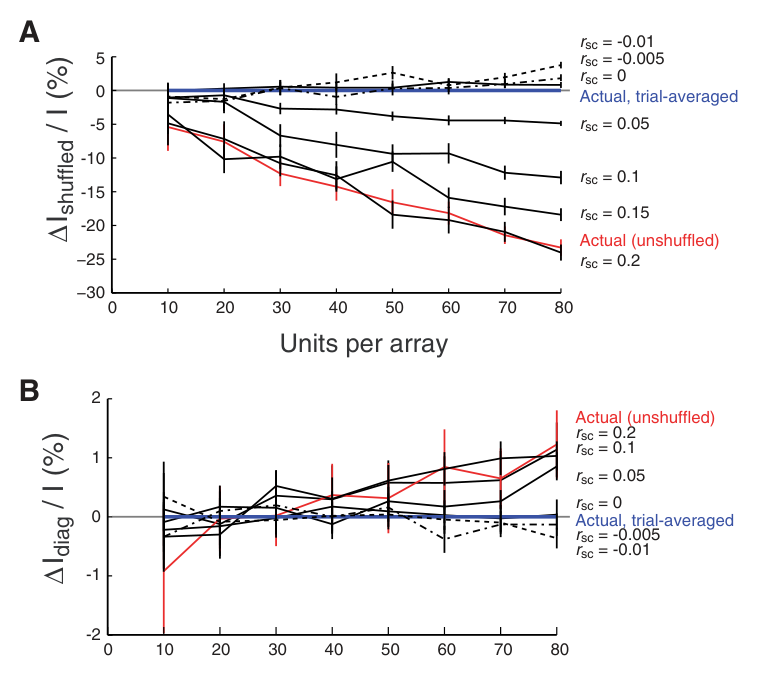
信号相关与噪声相关强耦合(图 5):五个阵列内神经元对的 rsignal 与 rSC 均显著正相关(阵列内 Fisher 校正后 R 为 0.38–0.79(SUA)与 0.49–0.81(hash MUA);SUA 均值 R=0.63)。平均而言两个相关都很弱(rsignal 均值 0.11,rSC 均值 0.05,共 10,645 对),但一致性很强(偶-奇试次调谐一致性 r≈0.6)。按理论预期,这种"调谐越相似、噪声越共变"的正向排列正是信息损失的情形——这为结果 1 提供了结构基础。
-
空间效率由层次与各向异性共同决定(图 6、7):噪声相关在颗粒层(granular layer,约 1.0–1.2 mm)最弱(SUA 均值 0.021,hash 0.035),显著低于上颗粒层与下颗粒层(0.066/0.095 与 0.065/0.096,p<0.001),也远低于清醒 V1 文献值(颗粒层 0.04 vs 上/下层 0.23–0.24);与 V1 不同,IT 上恰恰是输出层(supra/infragranular)的分类成绩最好,颗粒层最差,且编码噪声效应在输出层显著、在颗粒层不显著。按各向异性分组后,改为'Group 1 在分类与类内泛化上成绩优于 Group 2;姿态/光照泛化在 30% 规模时两组成绩相近,但仅 Group 1 的噪声效应显著',或直接把 8–16 单元检出阈值与图 7B 的 20%/30% 分组细节写全,其噪声共变效应也更强(需要至少 8–16 个单元才可检出);关键在于:尽管付出噪声代价,Group 1 单元在更小群体规模下就能达到给定成绩,即整体上更高效。解码端知道相关结构在任何分组、任何层次都无增益。
-
模拟重现并点明机制(图 8):把已知相关强度的人工噪声注入试次平均数据后,负 rSC 会略微改善编码与解码,而真实数据的表现恰对应模拟 rSC 约 0.2 的情形——远高于全体均值 0.05,说明编码主要由高 rSC 的 Group 1 输出层单元支撑。数据中确有稳定的负 rSC 子群(偶试次 rSC≤-0.05 的 434/10,645 对在奇试次仍如此,均值 -0.040,各阵列 p<10^-9),作者猜测抑制性连接可解释并可能用于清除行波噪声。此外 ΔIdiag/I 在小群体为负、大群体转正,提示高阶核(higher-order kernels)解码方式可能利用相关结构,他们的线性读出结论不排除这一点。
图注解读
图 1 · 噪声共变降低类别泛化的编码
原文图注:Figure 1. Noise covariation reduces object category generalization encoding in IT. A, Array locations 1–5, centered at A16 of right lateral inferior temporal cortex, recorded in separate sessions across 3 macaque monkeys under light neurolept anesthesia. Arrays had 64 contacts (8 shanks, 8 contacts/shank) spaced 0.2 mm apart, spanning 1.4 × 1.4 mm horizontally and in depth. STS, Superior temporal sulcus; AMTS, anterior medial temporal sulcus. B, Effect of noise correlation on classifier performance for within-category generalization. Linear classifiers were trained on 8 objects per category and tested on 5 other objects per category. Chance is 12.5% for 8 categories. For encoding, classifiers were trained and tested on unshuffled (actual) data versus trained and tested on trial-shuffled data, shown for individual categories (colors) and for the average across categories (black). For decoding, classifiers were trained and tested on unshuffled data, versus trained on shuffled data and tested on unshuffled data. Classifier input was spike count in the 100:300 ms period, pooled across 5 arrays and all trials. Data are mean ± SEM (50 permutations of objects and trials). p<0.05 (two-tailed t test, uncorrected). p<0.01 (two-tailed t test, uncorrected). **p<0.005 (two-tailed t test, uncorrected). C, Average category responses for the 5 arrays. Spike counts 100:300 ms after stimulus onset were averaged across 10 trials, z-normalized across all 240 objects for each contact, and then averaged within each category. z-scores are low because different objects in a category tend to activate different sets of contacts. White represents broken/inactive contacts.
A 面板是解剖定位图:五个 8×8 阵列(1.4×1.4 mm)在右 IT 侧凸面的插入位置,居于颞上沟(STS)与前内侧颞沟(AMTS)之间,强调记录面积小、取样致密。B 面板是主图:横轴为 8 个类别(加均值),纵轴为分类器成绩(%),彩色柱为各类别、黑柱为平均;每类并排比较"未打乱数据"与"打乱数据"(编码比较),以及"真实解码"与"打乱训练、真实测试"(解码比较)。读图要点:几乎所有黑色(均值)柱在打乱后明显升高、星号标显著,而"打乱训练/真实测试"与"真实/真实"几乎同高——这正是"编码受损、解码无补"的双重信息(主要结果第 1 条)。C 面板按阵列×类别显示平均反应(z 分数,白色为坏触点),用来解释为什么某些类别(该阵列偏好的面孔、动物)效应更强——与空间聚集编码的图景一致。
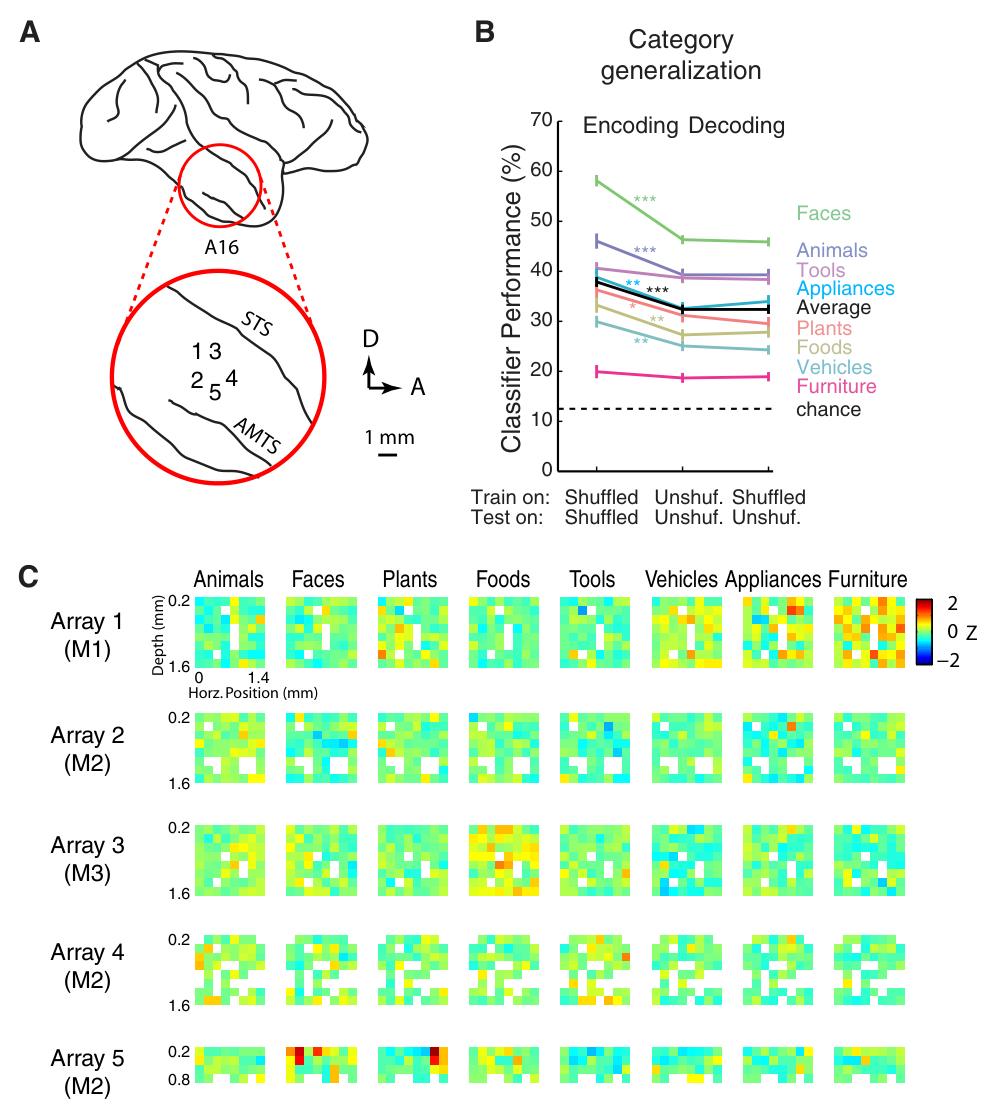
图 2 · 噪声共变也损害单个物体的识别
原文图注:Figure 2. Noise covariation reduces object identification encoding. Effect of noise covariation on classifier performance for object identification, for encoding and decoding across different bin sizes within the 100:300 ms window. Classifier training was based on 5 trials, and classifier testing was based on 5 other trials. Performance is shown for the best bin of each bin size (e.g., the 150:175 ms bin for the 25 ms bin size). Chance is 0.42% for 240 objects. Data are mean ± SEM (50 permutations). p<0.05 (two-tailed t test, uncorrected). **p<0.005 (two-tailed t test, uncorrected).
横轴为时间窗宽(12.5–200 ms),纵轴为 240 个物体逐一识别的分类成绩(随机水平仅 0.42%),同一窗宽取其最优时间窗的成绩作图;柱组分别对应编码与解码下的"未打乱 vs 打乱训练/未打乱测试"两种比较。读图要点是窗宽依赖:窗宽大于 50 ms 时编码效应显著(星号),更小窗不显著——作者归因于每类仅 1 个物体导致训练数据太少;而解码四种比较依旧无差别。它支撑主要结果第 1 条末段:效应不是类别合并造成的伪影,而是逐试次噪声共变本身。
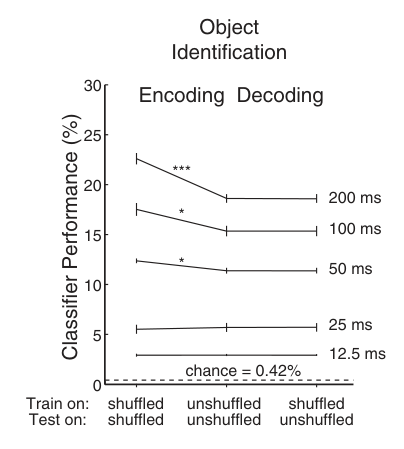
图 3 · 姿态与光照泛化同样受损
原文图注:Figure 3. Noise covariation reduces pose and illumination generalization. A, Pose and illumination variations for one object. B, C, Classifier performance for generalization across pose and illumination (colors) for encoding and decoding. Based on arrays 2 and 4, recorded in separate sessions. For each array, we tested 25 variations of 10 preferred objects. Black represents average across poses/illuminations. Classifiers were trained on 4 poses or 4 illuminations (20 variations per object) and tested on object identification at the unseen pose or illumination. Data are mean ± SD (50 trial permutations). Chance is 10% for 10 objects. p<0.05. **p<0.005. n.s., Not significant.
A 面板示意一个物体的 5 姿态 × 5 光照变化网格;B、C 分别为跨姿态与跨光照的泛化成绩,彩色为各测试变化(未见的那种姿态或光照)、黑色为平均,纵轴为成绩(随机水平 10%)。读图与图 1B 相同:各自比较"真实/真实"与"打乱/打乱"(编码),以及"打乱训练/真实测试"与"真实/真实"(解码);黑色平均柱的显著降低(B 面板 p<0.005,C 面板 p<0.05)说明对未见视角与光照的泛化编码同样被噪声共变拖累,而解码读法仍无增益。这支撑主要结果第 1 条的最后一块拼图:噪声共变的代价连"对视角与光照变化表现不变性"的泛化也不例外。
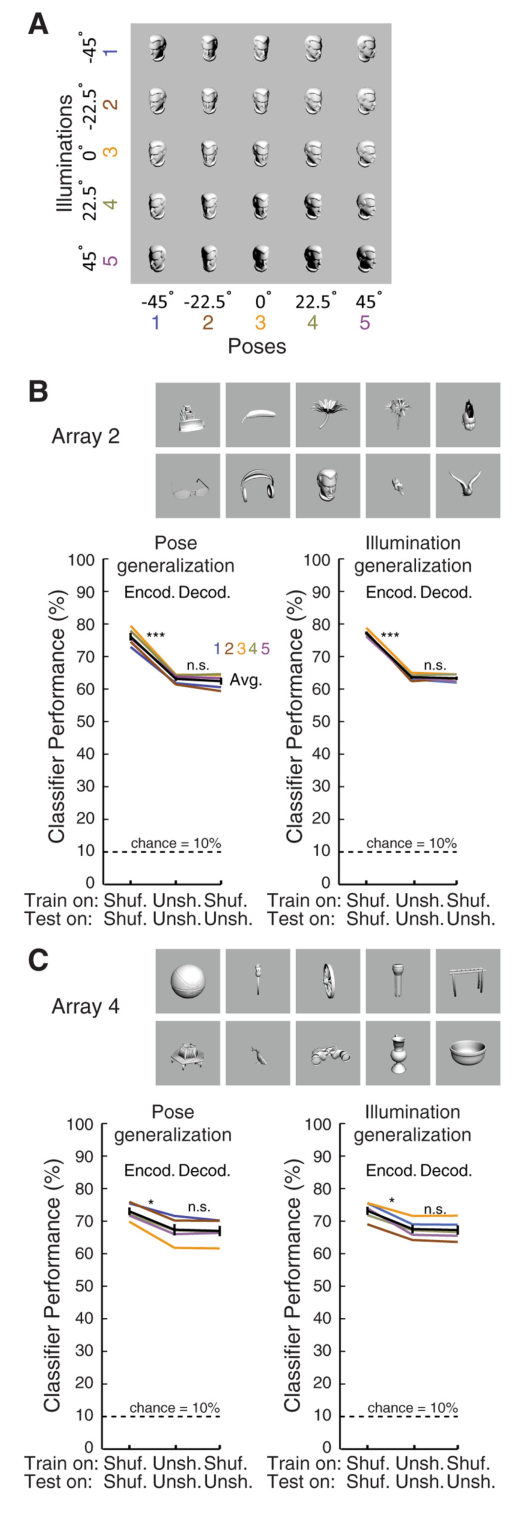
图 4 · 效应随群体规模增大且出现极早
原文图注:Figure 4. Dependence of noise covariation effect on ensemble size and latency. A, Effect of noise covariation on category encoding as a function of number of units in each of 5 arrays (colors). Classifiers were trained and tested on unshuffled data (solid lines) or trained and tested on shuffled data (dashed lines). Classifiers were trained on 5 trials and then tested on the remaining 5 trials, based on spike count in the 100:300 ms window. Data are mean ± SEM (50 permutations of units and trials). Chance = 12.5% for 8 categories. B, Effect of noise correlation on category decoding. Classifiers were trained and tested on unshuffled data (colored solid lines) or trained on shuffled and tested on unshuffled data (gray dashed lines). C, Dependence of effect on population size for encoding (left) and decoding (right). Colors show results for individual arrays, based on SUA. ΔP/Pcorrected is calculated as follow: (PU − PS)/(PU − PC), where PU, PS, and PC are performance on unshuffled training trials, shuffled training trials, and chance (12.5% for 8 categories), respectively. Mean ΔP/Pcorrected is shown as thick black line for SUA, dashed black line for MUA (pooled from SUA), and dashed red line for hash MUA. Shaded region is SEM (50 permutations). D, Time course of object categorization performance for encoding (left) and decoding (right). Classifier input was the average spike rate for one 25 ms bin in the 100:300 ms window, pooled across 5 arrays. Data are mean ± SEM (50 permutations, SUA). p<0.05; p<0.01; **p<0.005 (two-tailed t test, uncorrected).
A、B 为五阵列(彩色)的群体规模—成绩曲线:A(编码)实线为真实数据、虚线为打乱数据,两条曲线的间距随单元数增大而张开;B(解码)为彩色实线与灰色虚线,几乎重合。C 把这一间距换算成相对效应 ΔP/Pcorrected(对随机水平校准),显示编码端(左)随规模升至 10%–15%、解码端(右)不显著。D 为 25 ms 窗扫过 100–300 ms 的时间进程:编码效应实线(真实)与虚线(打乱)的分离在最早反应段(约 100 ms 起)即见星号。支撑主要结果第 2 条:效应是大群体的性质、与快速前馈识别同步,而非慢速增益过程。
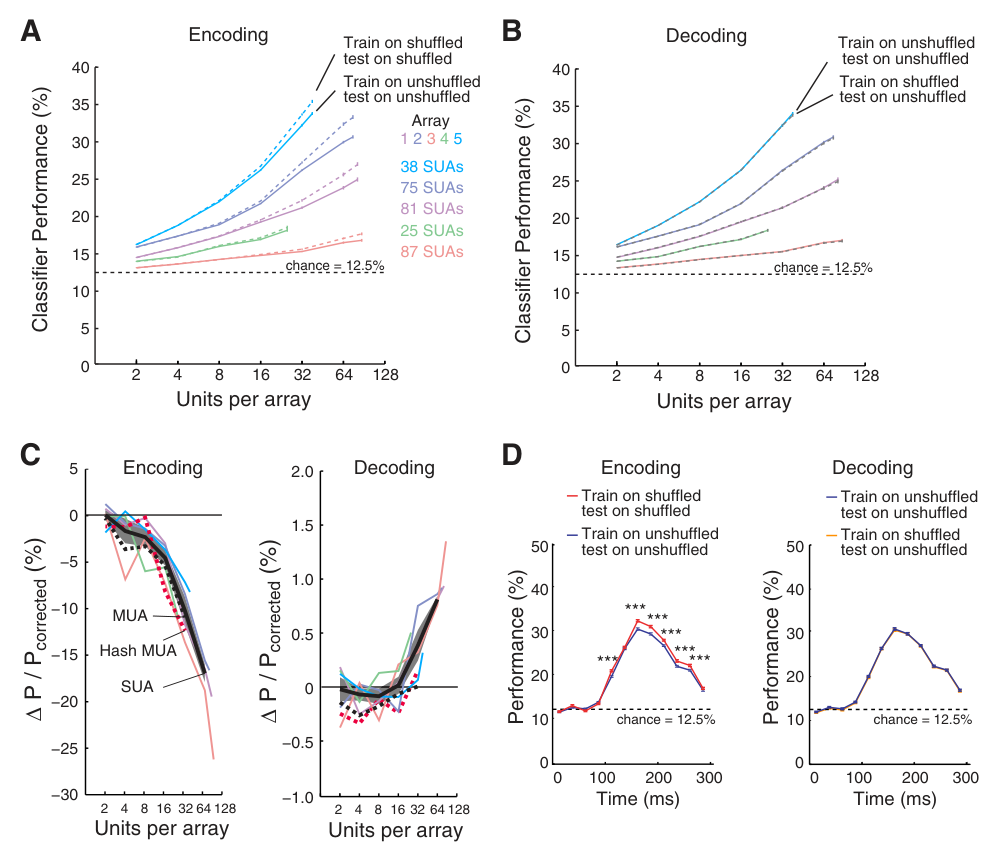
图 5 · 信号相关与噪声相关同向而行
原文图注:Figure 5. Signal correlation and noise correlation are strongly linked. A, Signal correlation (rsignal) versus noise correlation (rSC) of neuronal pairs in array 1, based on 81 SUAs (3214 pairs, recorded from separate contacts). rsignal and rSC are measured as Pearson correlation of trial-averaged stimulus responses and trial-by-trial response deviations, respectively, based on spike count from 100 to 300 ms after stimulus onset. Stimuli were 240 objects shown for 10 repetitions in pseudorandom order. Gray line indicates model II regression of rsignal versus rSC. Red marginal represents rSC after trial shuffling. ***p<0.005. B, Correlation (R) between rsignal and rSC across 5 arrays. Horizontal lines are mean across 5 arrays for hash MUA (r=0.69) and for SUA (r=0.63). p<0.005 for each array.
A 为阵列 1 的散点图:横轴为神经元对(3214 对)的信号相关 rsignal,纵轴为噪声相关 rSC,灰线为模型 II 回归,右侧的红色边缘分布显示打乱试次后 rSC 集中在 0 附近(均值约 -0.0003)——用作对照证明测到的 rSC 是真实的试次间结构。B 汇总五个阵列:横轴为五阵列的 R 值,两条水平线分别为 hash MUA(0.69)与 SUA(0.63)的平均。整图的核心信息是"调谐相似的神经元噪声也共变",且每个阵列独立成立(p<0.005)。它支撑主要结果第 3 条,也为图 8 模拟选择的效应幅度埋下伏笔。
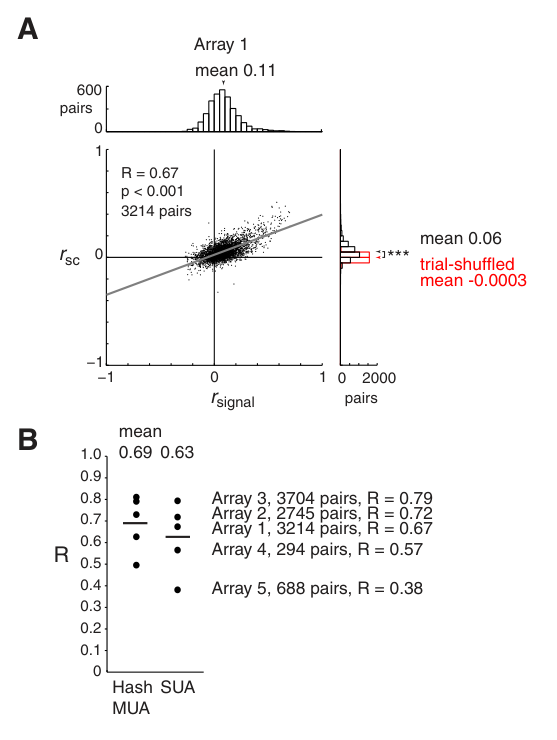
图 6 · 相关结构与编码的皮层层次分布
原文图注:Figure 6. Cortical depth dependency of signal correlation, noise correlation, and coding efficiency. A, Cortical depth versus proportion of Group 1 units, defined as the top 20th percentile of units in each array sorted by average signal with other units in the same array, based on SUA. B, Noise correlation (rSC) at supragranular (0.2–0.8 mm), granular (1.0–1.2 mm), and infragranular (1.4–1.6 mm) depths for arrays 1–3, based on hash MUA and SUA. Layers were estimated from cortical depth. Red lines indicate mean ± SD. Arrays 4 and 5 were excluded because they sampled mainly supragranular layers. p<0.05. p<0.01. **p<0.005. C, Effect of noise correlation on encoding (blue, red, and black) and decoding (gray) at supragranular, granular, and infragranular depths for within-category identification, categorization, and within-category generalization, for arrays 1–3. Based on 8 units with highest average rsignal per depth group per array, defined without training/test objects. S, Shuffled; U, unshuffled. Data are mean ± SEM (50 permutations of stimuli and trials). Chance is 12.5% for all tests, for 8 categories and 8 objects/category.
A 为各深度上 Group 1(本阵列平均 rsignal 前 20%)单元的占比:在颗粒层急剧减少(55 个单元中仅 2 个),符合"高相关单元聚在输出层"的图景。B 为三个层次上的 rSC(hash MUA 与 SUA 两组),红色线为均值 ± SD:颗粒层(约 0.02–0.035)显著低于上、下颗粒层(约 0.065–0.096)。C 是关键面板:三种任务(识别、分类、类内泛化)分别在三个层次上比较打乱/未打乱——输出层的编码、解码成绩高于颗粒层,编码噪声效应只在输出层显著(U 与 S 的成对比较),解码四组比较均无差别。整图支撑主要结果第 4 条,并抛出与 V1 相反的结论:IT 的"好编码"不在输入层而在输出层。
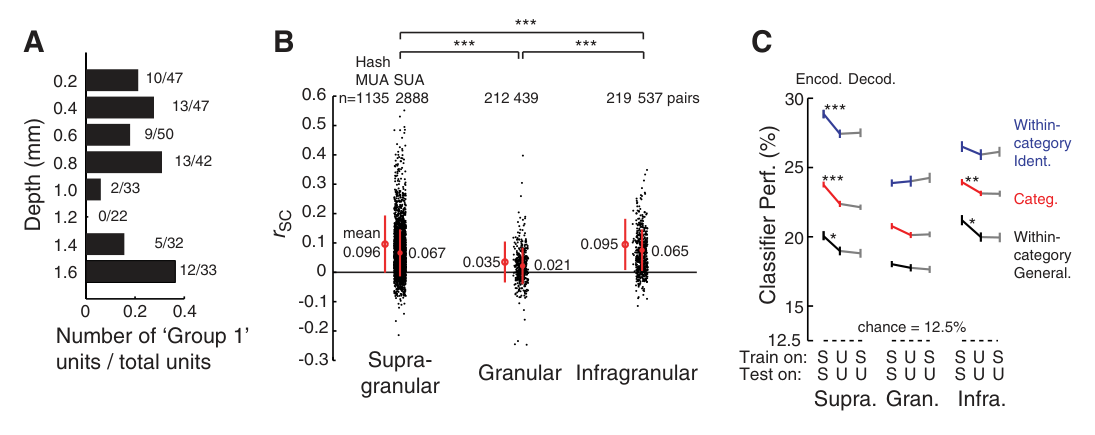
图 7 · 各向异性:谁受益、谁买单
原文图注:Figure 7. Noise covariation effect on coding efficiency depends on network anisotropy. A, Effect of noise covariation on category encoding (colors) and decoding (gray) for Group 1 versus Group 2 units in each array. Group 1 is units with the highest average signal with other units in the same array, and Group 2 is units with average signal closest to the median of each array, defined without training/test objects. Classifier training/testing is same as in Figure 4, cross-validated across trials. For both panels: p<0.05; **p<0.005. Data are mean ± SEM (50 permutations). n.s., Not significant. B, Effect of noise covariation on encoding (red, black) and decoding (gray) for categorization, within-category generalization, and pose and illumination generalization for Group 1 and Group 2 units pooled across arrays (compare with Figs. 1B, 3B, C). Solid lines are Group 1 and Group 2 units defined as the 30% highest (red) and 30% median (black, 35th-65th percentile) average rsignal of each array, defined without training/test objects. Dashed lines are Group 1 and Group 2 units defined as the 20% highest (red) and 20% median (black) average signal of each array. Data are mean ± SEM (50 permutations of stimuli and trials).
A 面板按阵列比较 Group 1 与 Group 2(两两组、横轴为每阵列单元数):Group 1 的曲线整体在上方,其编码噪声效应(U 与 S 线的间距)较大但需 8–16 个单元才检出;解码(灰)则平坦。B 面板跨阵列汇总,三个任务分列,实线为 30% 分组、虚线为 20% 分组:Group 1 的编码损失大于 Group 2,但在同样单元数下成绩更高;姿态/光照泛化在 30% 规模时两组成绩相近、却只有 Group 1 的噪声效应显著。读图关键在于:判断"Group 1 拿更少的单元就达到稳定成绩"这一效率优势,要看两条曲线的相对位置,而非只看噪声损失量的大小——它对应主要结果第 4 条的完整含义(付出更大噪声代价的子群整体上反而更高效)。
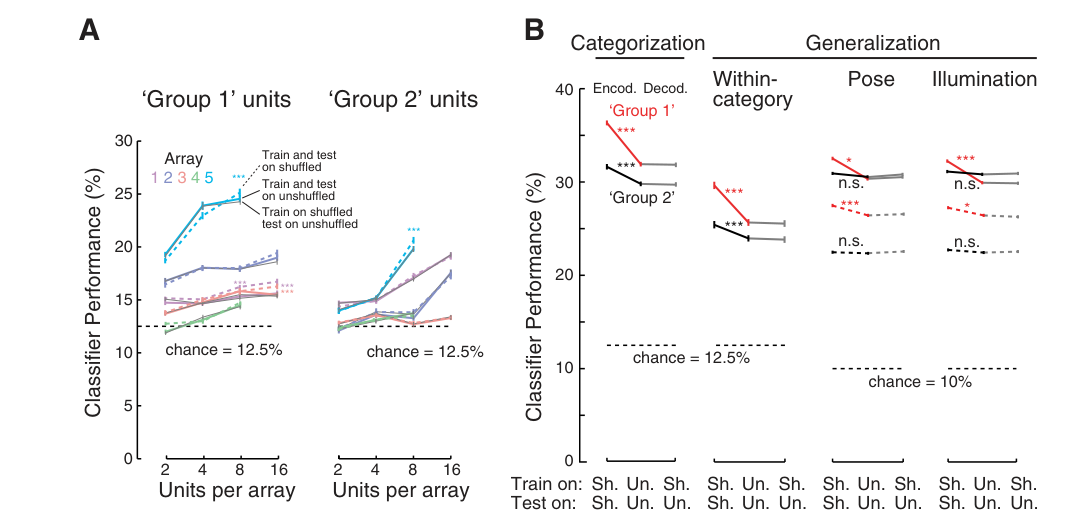
图 8 · 模拟注入人工噪声相关
原文图注:Figure 8. Effect of simulated noise correlation on category encoding and decoding. A, Effect of simulated noise correlation on category encoding. ΔIshuffled/I versus population size for simulated noise correlation rSC of -0.01 to 0.2 (black). I, Information; Ishuffled, trial-shuffled information; ΔIshuffled, I−Ishuffled. Noise correlation was simulated by injecting noise to trial-averaged data (blue). Results for unshuffled data (actual, red) approximate those of simulated rSC of 0.2. ΔIshuffled/I is positive for negative rSC. Compare with Averbeck et al. (2006; their Fig. 2). B, ΔIdiag/I versus population size. Idiag, Information that would be extracted by a decoder trained on trial-shuffled data but tested on actual correlated (unshuffled) data; ΔIdiag, I−Idiag. Compare with Averbeck et al. (2006; their Fig. 4).
A 面板以信息量损失 ΔIshuffled/I(纵轴)对群体规模(横轴)作图,黑色曲线对应从 -0.01 到 0.2 的模拟 rSC(蓝色粗线为向试次平均数据注噪的实现),红色为真实未打乱数据。读图两条:负 rSC 的曲线正向(略有好处),正 rSC 越大损失越多;真实数据的损失幅度近似 rSC=0.2 的模拟——远高于实测平均 0.05,暗示实际承担编码的恰是 rSC 较高的 Group 1 子群。B 面板为 ΔIdiag/I("聪明"解码器相对真实解码的信息差额):小群体为负、大群体转正,提示理论上仍存在高阶读出可能利用相关的空间。该图支撑主要结果第 5 条。
讨论
作者把整套发现收拢为一句话:即使弱噪声相关(群体均值 rSC 仅 0.05)也会降低 IT 的编码效率,但与前通路(V1/MT、朝向分辨)的既有结论相反,冗余(redundancy)对复杂高维物体信息的流形表征反而有益,而且"对噪声共变更免疫"的是特定子群而非全体。他们提出的图像是一个"pipe cleaner(管道清洁毛刷)"模型:Group 1 相当于毛刷中央的脊柱——输出层中彼此同步、形成低维相关结构的神经元,是物体编码的主要载体;Group 2 是四散的鬃毛——被局部平衡的兴奋/抑制去相关,作为覆盖高维空间张成(tensor)的基元来细调流形。这一图景与柱状尺度组织支持高效编码与行为(Tsodyks 等,1999;Tanaka,2003;Nienborg 与 Cumming,2014)、网络重构速度依赖各向异性(Panas 等,2015)等报告一致,也与"沿腹侧流向上一路增长的是容忍性(tolerance)而非稀疏性"(Rust 与 DiCarlo,2010;Willmore 等,2011)相吻合;效应时间进程与快速前馈识别同步,排除了注意反馈解释。
作者对局限相当坦率。最大的假设是:下游神经元以线性加权汇聚的方式读出 IT 编码——若解码器会利用相关结构(如高阶核),可能得到不同结果(Reichert 与 Serre,2014),ΔIdiag/I 随群体规模的符号翻转与类别间差异都暗示这一空间的存在;其次,全部记录在轻度麻醉下进行,作者以四点论证麻醉未强扭总体动力学(芬太尼浓度远低于已报道有/无效应的范围;噪声相关快于 3.3 Hz、注入更慢人工相关所得效应反而更大,且这类慢涨落块已被剔除;另有报道清醒与麻醉的相关更相似;实测 rSC 极弱、颗粒层尤低,不可能是全身状态波动所致),肌松也排除了注意与眼动带来的相关混淆。但正因如此,"这些相关如何影响真实行为"被明确留作未来问题。
一句话总结
这篇文章把一个长期停留在理论层面的争论(冗余到底值不值)拉到了解剖与逐试次的证据上:噪声共变有代价,可它买来的低维相关结构恰恰是承载高维物体信息的骨架——代价与收益落在同一群输出层神经元身上。我的判断是,"Group 1 载体 + Group 2 基元"的双层图景还偏于叙事(pipe cleaner 只是比喻而非定量模型),但它至少提供了一个可检验的定义:想找"编码主力"时,别按放电率强弱挑神经元,按它与邻居的平均信号相关挑。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A, B] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig4: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig5: 提取质量
good,对齐度full,识别面板[A, B] - Fig6: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig7: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig8: 提取质量
good,对齐度full,识别面板[A, B]
关键事实与局限性声明
- 审校纠偏: {'location': '开头一句话定位段', 'current_text': "它对 Barlow 式'去相关即高效编码'的经典教条给出了直接的生理学反例", 'assessment': "属轻度措辞偏强但基本可接受:作者本人即宣称 'contrary to the current view that decorrelation supports efficient coding, correlated neurons have better object coding capability',笔记的方向与原文一致;只是全部数据来自麻醉动物、且作者自己把'对行为的影响'留作未来问题,'直接的生理学反例'略去了这一限定。建议保留但可补'(在麻醉 IT 的读出意义上)'之类限定。"} -> 评注: 属轻度措辞偏强但基本可接受:作者本人即宣称 'contrary to the current view that decorrelation supports efficient coding, correlated neurons have better object coding capability',笔记的方向与原文一致;只是全部数据来自麻醉动物、且作者自己把'对行为的影响'留作未来问题,'直接的生理学反例'略去了这一限定。建议保留但可补'(在麻醉 IT 的读出意义上)'之类限定。
- 审校纠偏: {'location': '讨论段', 'current_text': '效应时间进程与快速前馈识别同步,排除了注意反馈解释', 'assessment': "原文措辞为 'The effect cannot be due to feedback from attention ... because its rapid time course matched that of feedforward recognition',笔记忠实转述了作者论证;肌松也排除了眼动/注意引起的相关混淆。此为作者推论(INTERPRETATION)而非实验直接证明,笔记未明确标注这一层级,但无方向性错误。"} -> 评注: 原文措辞为 'The effect cannot be due to feedback from attention ... because its rapid time course matched that of feedforward recognition',笔记忠实转述了作者论证;肌松也排除了眼动/注意引起的相关混淆。此为作者推论(INTERPRETATION)而非实验直接证明,笔记未明确标注这一层级,但无方向性错误。
- 补充要点: 阵列 5 的调谐与位置提示其可能落在既往报道的 'AL' 面孔 patch 内(作者在 Results 中明确提及,但只采样了该猴另外两个位置)——与结果 1 中面孔效应最强的讨论直接相关
- 补充要点: 分类/类别泛化读出实际只用 240 个物体中的 104 个(8 类 × 13 物体,不足 13 个的类别未测);类别内泛化训练的 8 个物体是从每类 13–21 个中随机选取的——笔记未交代这一子采样
- 补充要点: Group 1 的优异表现与调谐宽度(tuning selectivity/sparseness)无关(原文明确,引 Hung et al. 2014 Fig. 3)——这是作者反驳'稀疏即高效'解释的关键对照,笔记仅在讨论中间接提及
- 补充要点: 猴子从未见过这些刺激图像(排除熟悉度混淆),以及偶-奇试次调谐一致性 r≈0.6 作为数据质量对照(笔记在结果 3 提到后者,前者遗漏)