IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
132| 原始基线:V0_ZCODE_BASELINE| 语义审核:needs_revision| 图表审核:passAstra裁决:compromise_revision(revise)
Learned Value Shapes Responses to Objects in Frontal and Ventral Stream Networks in Macaque Monkeys
Kaskan · Cerebral Cortex · 2017 · Zotero itemID=1360
一句话定位:这篇论文用猕猴全脑功能磁共振成像(fMRI, functional magnetic resonance imaging),系统定位了编码"新近学会的图像价值"的脑区。结果出人意料:在猴身上长期被认为是价值编码核心的眶额叶皮层几乎没有图像价值信号,而人类影像研究强调的内侧额叶皮层却信号强烈——这为调和猴(电生理强调 OFC)与人(fMRI 强调 MFC)之间的"价值编码脑区之争"提供了关键一环,同时首次用全脑 fMRI 揭示了下颞叶视觉皮层会随学习而"染上"价值。
研究背景
大脑如何把物体的视觉表征与奖励价值联系起来,这些信息又存储在哪里、之后如何被提取,这是一个尚未解决的完整图景。此前已知的候选系统包括眶额叶皮层(orbitofrontal cortex, OFC)、腹外侧前额叶皮层(ventrolateral prefrontal cortex, VLPFC)、内侧额叶皮层(medial frontal cortex, MFC)以及杏仁核(amygdala)。但跨物种的证据对不上:猴的单细胞电生理大量报道 OFC(尤其 11、13 区)神经元编码刺激预测的奖励类型、数量与概率,而人类 fMRI 的多数研究却把价值编码定位在 MFC——人类的价值编码区(MFC)与猴的价值编码区(OFC)似乎占据了不同的领地。这种分歧部分源于命名体系和实验设计的不一致,很难用单物种单一手段去裁决。作者还提到一个值得注意的背景:近期的猴损伤研究表明,真正对追踪"刺激—奖励关系变化"至关重要的脑区反而在 OFC 之外(Rudebeck, Saunders, et al. 2013),这更让人怀疑把 OFC 单点价值信号看得太重是否有失偏颇。
缺口因此有二。第一,需要一种与人类研究"同构"的手段——全脑 fMRI——去猴身上系统扫描价值表征,而不是继续依赖电生理的局部采样;这既可能弥合物种差异,也能为未来的因果操纵与记录锁定候选脑区。第二,作者对视觉系统本身也有强烈预期:下颞叶皮层(inferior temporal cortex, IT)的细胞对复杂视觉物体有调谐反应,此前已有零星证据表明 IT 与人类的物体/场景选择区会对奖励预测性图像作出反应,但"图像价值是否会因学习而写入 IT"在猕猴全脑层面缺乏系统刻画。杏仁核与纹状体作为奖励学习的关键节点,也在待检之列。
研究思路
作者的总体策略是:让猕猴在"当下"真正学会一批新图像的价值,然后用事件相关(event-related)fMRI 把"看图像时的价值信号"与"拿到奖励时的信号"解耦开来分别建模。逻辑链是:先用行为证明动物确实学会了(参考日无偏好 → 训练后强烈偏好高概率图像);再用去卷积分析展示"学习前同一批图像不分化、学习后分化"的直接证据,从而把 BOLD 差异归因于经验而非先在的视觉偏好;最后引入强化学习模型(reinforcement learning model)对每次试验逐一估计图像价值,把价值估计作为参数化调节量放进广义线性模型(GLM, general linear model),在全脑范围内搜索编码价值的体素。之所以选择"奖励概率"而非奖励类型或数量来操纵价值,是为了让事件相关设计在固定一种液体奖励的前提下干净地分离价值与奖励本身——这一选择后来在讨论中被证明是解释 OFC 阴性结果的关键。
设计上还有一个巧妙的对照:每周第一天(Reference 日)所有图像都以 66% 概率给水,动物对将要被赋予高/低概率的两组图像并无偏好;随后两天在扫描仪外训练,再做 Test 扫描。这样,Test 扫描中出现的任何高/低概率图像反应差异,都可以追溯到这 2 天的训练经历。由于选择试验与观看试验交替进行、奖励以伪随机延迟发放,看图、选择、得奖三类事件可以独立建模,这正是不用单细胞记录、而用 fMRI 做这件事的理由——全脑覆盖加上事件解耦。
方法
被试为 3 只成年雄性恒河猴(体重 4.7–7.1 kg),植入头部固定post,训练注视中央固视点以获得水奖励。任务为"选择与观看任务"(Choice and View Task):选择试验中中央注视 250 ms 后在两侧(约 7.5°偏心)呈现一对图像,动物须继续注视 250 ms 后眼跳至其一,并保持注视 750 ms;观看试验中单张图像置于屏幕中央,动物须注视 1 s。奖励为 0.3 mL 水脉冲,按图像所赋概率(训练与扫描期:高 75%、低 25%;Reference 日:66%)在 2–4 s 随机延迟后发放。刺激为从网上挑选的彩色物体照片(消防栓、电话、飞机、吉他等),经 SHINE 工具箱亮度均衡,每周一套全新图像(2 个类别、各 10 个样本,动物每天平均看每张图 38 次)。每周时间表为:Reference 扫描 → 扫描仪外训练 2 天 → Test 扫描,每只猴重复 8 周,各计入 8 个完整 session。
扫描在 4.7 T 垂直磁体上进行,单次激发 EPI(TE 22 ms、TR 2.2 s、体素 1.5 mm 各向同性),接收线圈专门覆盖 IT、杏仁核与 OFC;辅以 MDEFT 解剖像和高分辨率 0.5 mm 解剖像,用 CARET 建立皮层表面模型供展示。分析在 AFNI/SUMA 中完成:预处理包括几何畸变校正、片层时间校正、去斜、颅骨剥离、仿射配准、运动校正与 2 mm 平滑。两条分析线:其一是去卷积分析,用 8 个均匀 B 样条基函数估计每体素的时间响应曲线(试验全长 15.4 s,峰值约出现在图像呈现后 4.4 s);其二是时间差分(TD, temporal difference)强化学习模型——按 v(k+1) = v(k) + α(R − v(k)) 更新价值、经 logistic 函数生成选择概率、以极大似然拟合学习率(20 组初值避免局部极小,初始价值设为 0.66 与 Reference 日奖励率一致)——再把逐试验价值估计(均值中心化)作为调节回归因子进入 GLM,系数经混合效应 ANOVA(猴嵌套于 session、session 为随机因子)产生组间对比图。统计阈值:未校正 P < 0.005 起步,各图 FDR 校正后 P 在 0.004–0.028 之间,并加 7 体素簇阈值(10000 次 Monte Carlo 模拟的最大簇分布第 99.9 百分位,族错误率 P < 0.001);全脑信噪比(tSNR)截断值取 40,报告各峰值的 tSNR 以排除"信号太差才没效应"的质疑。
主要结果
- 行为上确实学会了(图 3):Reference 扫描日猴子对图像组无选择偏好,随训练天数推进偏好高概率图像的比例持续上升;Day 因素效应显著(F(3,95) = 150.863,P < 1×10⁻¹⁵),个体间无差异、无侧向偏好。两天训练后的 Test 扫描中,在高对低概率图像的选择试验里,猴子选择高概率图像的比例达 92.5%。
- 价值信号是"学"出来的,不是原有的(图 4、5):右侧 IT(含 TEa、TEm、TEad)在 Test 扫描中对高概率图像反应显著强于低概率图像(t 图与 BOLD 时间曲线均为证),但同一批体素在 Reference 扫描中虽对图像本身有正反应,却对"后来将被赋予高/低概率"的两组图像无差别(图 4A 无显著体素)。图 5 把这一模式扩展到 IT 两个位点、MFC 10m/32、VLPFC 12、前部壳核与前部脑岛:训练前都不分化,训练后高概率图像反应升高、低概率降低;MFC 是例外——只出现对低概率图像的显著下降,且下降幅度比其他区更醒目。另外,训练并不改变各脑区对"奖励到手"的反应。
- 额叶的价值地图与预期相反(图 6、7):图像价值编码见于 MFC 10m/32(位于 rostral 沟背侧的内侧壁,view 试验与 choice 试验均显著)、扣带沟背侧区(可能为 9 区与辅助运动区),以及双侧 VLPFC 12 区(侧眶沟外侧);OFC 中仅右半球 13b 有一个小簇编码价值。与之鲜明对照的是,OFC 11/13/14 区对"奖励到手"有强烈的正反应(图 6C–F)。选择试验与观看试验的价值信号经 ANOVA 对比无显著差异。
- 视觉系统被"染"上价值(图 8、9):V1–V4、TEO、TE、STS 下岸均编码图像价值(表 1 中 TEO/TE 峰值 t = 7.2,V1–V4 t = 7.3);双侧前腹侧 IT 的价值效应呈斑块状;右侧颞极出现大簇价值效应,自腹侧 TG 向尾侧延伸至 TEa 与嗅周区 36,左侧效应较小。
- 杏仁核阴性、纹状体与脑岛阳性(图 10–13):杏仁核对图像价值与奖励到手均无显著效应,但其背外侧部有明确的视觉反应、tSNR 达 50–150,说明并非信号问题。纹状体中价值编码位于尾状核头与壳核(偏背侧、外侧),而奖励到手位于腹侧纹状体与腹侧壳核(壳核价值效应为全表最强,t = 11.9)。前部脑岛对价值与奖励到手都有强反应(右侧更明显),后部颗粒区岛叶只对图像反应。联合分析(conjunction)显示同时编码两者的区域很少:VLPFC 12o、前部与中央背侧非颗粒脑岛、以及腹侧/后部壳核的一小部分。
图注解读
图 1 · 任务流程示意
原文图注:Figure 1. Choice and View Task. The Choice and View Task consisted of 2 interleaved types of trials, choice trials and view trials, presented in random sequence. Monkeys initiated all trials by fixating on a spot in the center of the screen for 250 ms within a 3° window. After this fixation period elapsed, a single, centrally placed image appeared (view trial) or a pair of images appeared (choice trial). Choice trials always involved a choice between 2 images. The offered image pairs could take 3 forms: 2 high probability images, a high and low probability image, or 2 low probability images.
这张图给出任务的时间结构:从注视启动点,到单图(view)或双图(choice)呈现,再到眼跳选择与按概率奖励。三种选择组合(高高、高低、低低)的设计保证选择行为可被强化学习模型拟合出"价值差→选择概率"的映射。它支撑的是方法部分的任务定义,也是后续所有 fMRI 事件建模的行为骨架。
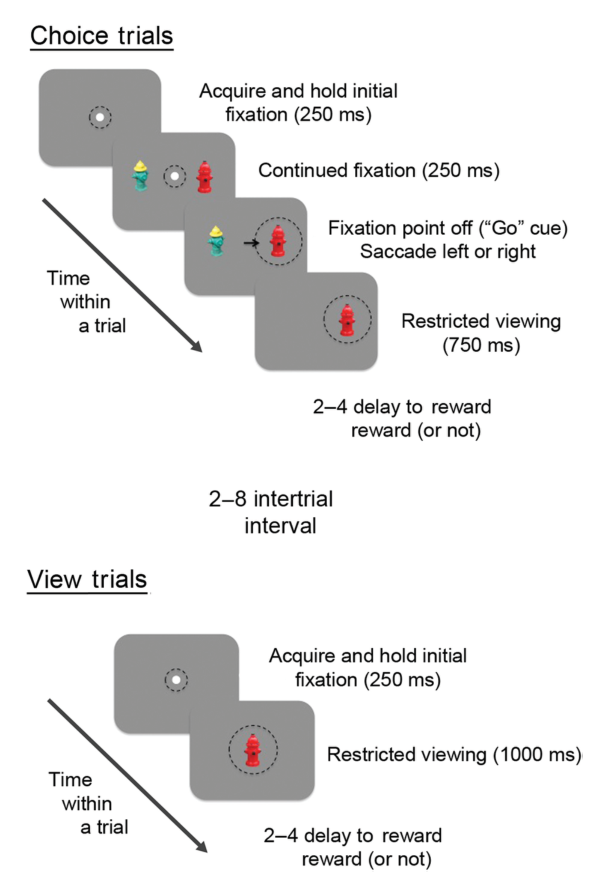
图 2 · 每周训练与扫描时间表
原文图注:Figure 2. Training and scanning schedule. Monkeys performed the Choice and View Task 4 days per week according to a fixed schedule for training and fMRI scans. Each weekly schedule consisted of 4 consecutive days with a given stimulus set: Reference scan, 2 consecutive days of training outside the scanner (Training Days 1 and 2), and a Test scan. This was repeated with novel images every week.
横轴是每周的 4 天:Reference 扫描(所有图像 66% 奖励)→ 两天扫描仪外训练(一半图像 75%、一半 25%)→ Test 扫描(保持 75/25)。每个价值效应都有"训练前/后"两个时间点可对照,正是这一时间表保证的。它支撑结果第 2 条关于"效应源于经验"的归因逻辑。
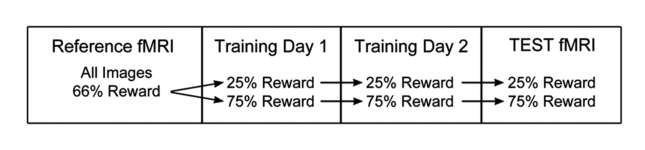
图 3 · 选择偏好随训练日上升
原文图注:Figure 3. Choice preferences. Plot shows image preferences for choice trials involving high versus low probability images for each day of the 4-day schedules. Preference for the high probability images increased over days, indicating that each of the monkeys learned the associations between images and the probability of reward. There was a significant effect of day (P < 1 × 10⁻¹⁵), but no effect of monkey (P = 0.147), nor an interaction effect (P = 0.957). Error bars are ±1 standard error of the mean (SEM) across sessions (8 sessions for each of the 3 monkeys).
横轴为 4 天时间表各日,纵轴为在高对低概率选择试验中选择高概率图像的比例。Reference 日在 50% 附近(无偏好),训练两天后爬升,Test 日到 92.5%。误差线为跨 session 的 ±1 SEM。这张图是"动物确实学会了"的行为证据,是结果第 1 条的直接出处。
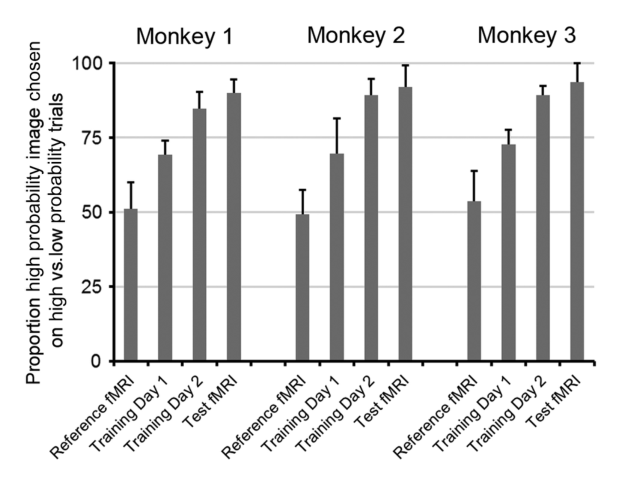
图 4 · IT 的训练前/后对比
原文图注:Figure 4. Training effects and BOLD responses in IT. (A,B) A cluster of voxels indicated by white outline (A) and corresponding BOLD time course from 3 monkeys (B) from view trials in Reference scan sessions; this significant cluster of voxels was first identified in Test scans (C). Before training, BOLD responses for high and low probability images do not differ from one another (A,B). Note, however, that IT does respond to reward-predictive visual images (B). (C) Voxels in IT (black outline) showing significant image value effects on view trials in the Test scan. (D) BOLD response time courses for images that predicted either high or low probability of reward for the voxels outlined in C.
读法:A/B 是 Reference 扫描(训练前),C/D 是 Test 扫描(训练后),都取同一右侧 IT 簇。B 中两条时间曲线(黑/灰)都明显高于基线——IT 本来就"看"图像;但训练前高/低两组曲线几乎重叠、t 图无显著体素。训练后(D)红线(高概率)抬升、黄线(低概率)下降,二者分离。t 图为峰值 BOLD(图像呈现后 4.4 s)的高对低对比,FDR 校正至 0.001。这是结果第 2 条的核心证据。
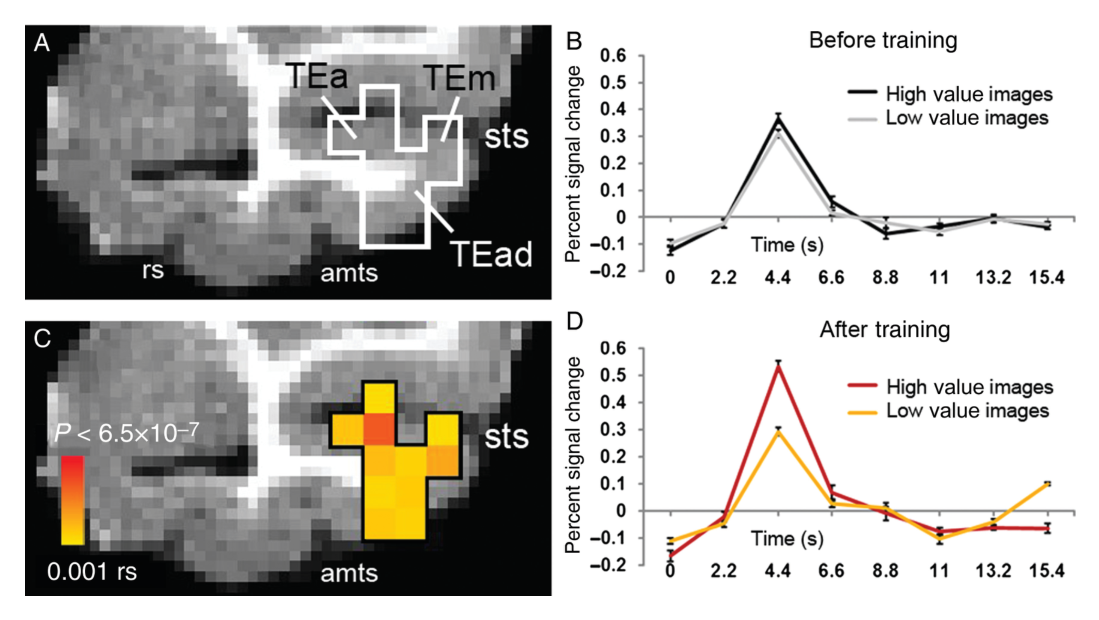
图 6 · MFC 编码价值、OFC 编码奖励到手
原文图注:Figure 6. Image value and reward receipt in MFC and OFC. A reinforcement learning model was used to estimate the values of images on each trial, which were used as a regressor in a general linear model of the data. (A,B) Significant effects of image value from view trials are shown in the mid-sagittal plane (A) and coronal plane (B), notably in a cluster of voxels on the medial wall (circle) in MFC area 10 m/32. t-Maps range from 3.125 (P = 0.005) to 7.0 (P < 6.5 × 10⁻⁷) and above; corrected FDR = 0.008. (C,D) Significant effects of reward receipt in OFC areas 11/13 and 14, shown in the mid-sagittal (C) and coronal (D) planes. Note the distinction in the regions representing image value (circle) and reward receipt (arrow).
读法:上排(A、B)是价值回归因子显著体素,圈出的簇在 MFC 10m/32;下排(C、D)是奖励回归因子显著体素,箭头指向 OFC 14 区,簇延伸至 11/13。两个不同的统计量、两个不同的解剖位置,构成"价值与奖励到手分离"的正面证据。E 显示 10m/32 对高价值图像的 BOLD 反应更强;F 显示 11/13 区对奖励到手有正反应;G 按猴分别画回归系数,说明效应并非单只动物驱动。这是结果第 3 条的主图。
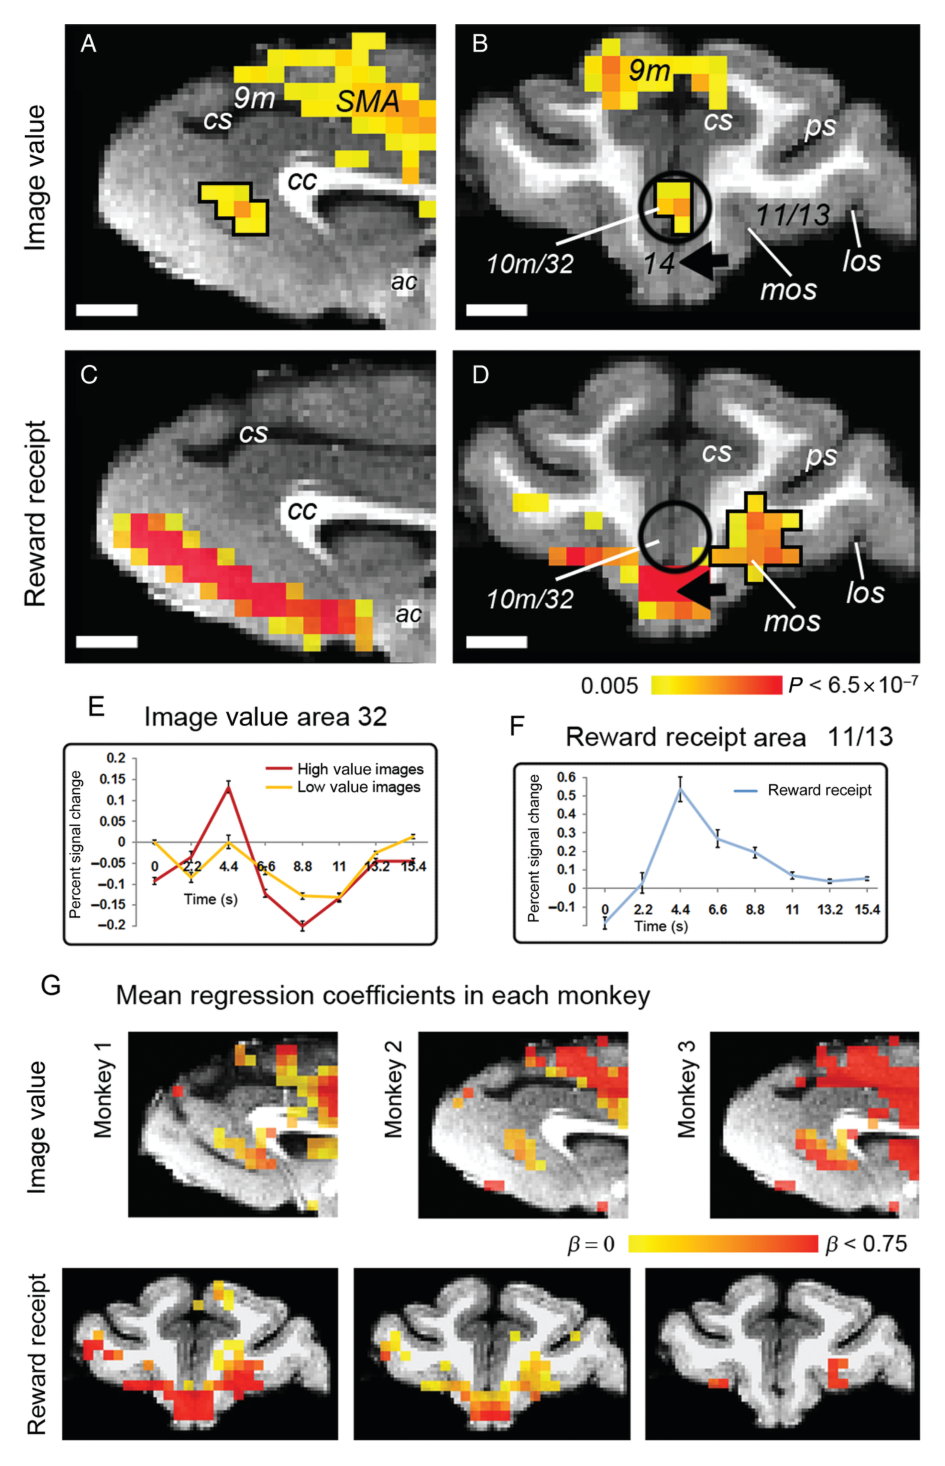
图 5 · 六个脑区的训练效应条图
原文图注:Figure 5. Image-related training effects. Percent BOLD signal change on view trials before training (Reference scans; black bars, images to be paired with high probability of reward; gray bars, images to be paired with a low probability of reward) and after training (Test scans; red bars, high probability images; yellow bars, low probability images) is shown for 6 areas in which significant voxel clusters were identified following training (P = 0.001, FDR = 0.01).
读法:六个面板分别是 IT 的两个位点(STS 底部与 STS 下方腹侧面)、MFC 10m/32、VLPFC 12、前部壳核与前部脑岛;纵轴为图像呈现后 4.4 s 峰值的 BOLD 百分比变化。黑/灰(训练前)两柱基本等高,红/黄(训练后)分离——红升黄降。唯一例外是 MFC:训练前有正反应,训练后只有黄柱(低概率)显著下降。这解释了为什么 MFC 的价值编码在整组对比中表现为"压低低价值信号"而非"抬高高价值信号"。
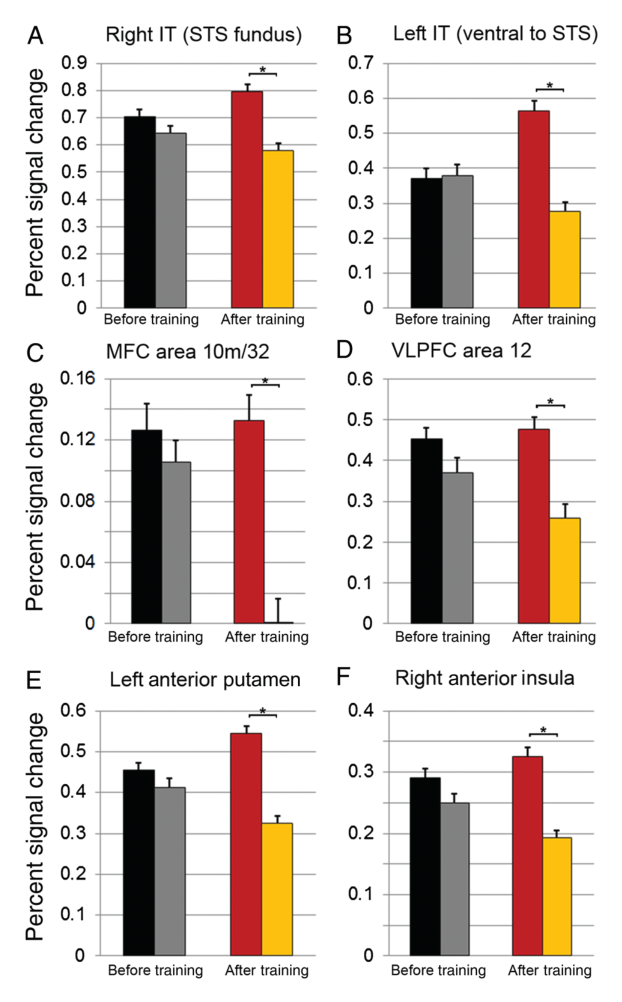
图 7 · VLPFC 12 区的价值效应
原文图注:Figure 7. Image value effects in VLPFC area 12. (A–C) Significant effects of image value in VLPFC area 12 in the left and right hemispheres from view trials shown in the coronal plane (A), a sagittal plane through the right hemisphere (B), and on a reconstruction of the frontal and anterior temporal lobe cortical surface in the right hemisphere (C). The black arrows in panels A, B, and C show the same voxel cluster in each view of the right hemisphere. (D) Bold time courses for high and low value images from VLPFC cluster surrounded by black outline in A. Other sites of activation include area 13b, insula, and TG. t-Maps range from 2.8 to 5 (P = 0.01, FDR-corrected 0.01).
读法:三个视图(冠状、矢状、皮层表面重建)用黑箭头指认同一个簇,位置在侧眶沟外侧的 12 区,左右半球均有;D 的时间曲线显示高价值图像反应高于低价值。同图还可见右半球 13b 的小簇价值效应(仅右半球)。该区 tSNR > 40,信号质量可接受。支撑结果第 3 条中"VLPFC 12 编码价值"的部分。
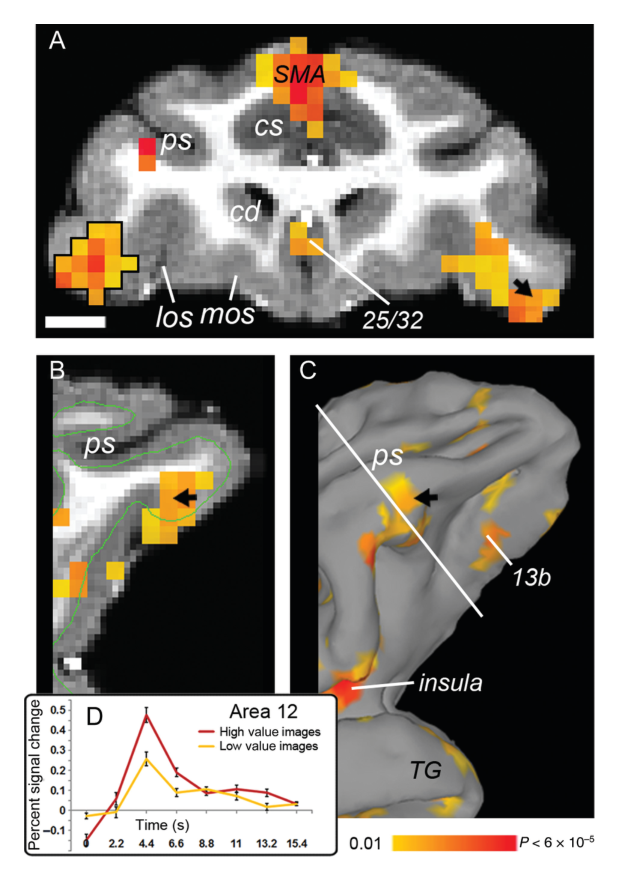
图 8 · IT 的价值编码位点
原文图注:Figure 8. Image value effects in inferior temporal cortex. (A,B) Significant effects of image value from view trials were found below and within the superior temporal sulcus (STS) in IT cortex, shown in the coronal plane for both the left (A) and right (B) hemispheres. (C,D) Sagittal sections showing the same regions responsive to image value as in A,B. (E,F) Reconstruction of the lateral surface of the left (E) and right (F) temporal lobe. The arrows in panels A, C, and E indicate the same significant voxel (t = 5.8) in TEad in the left hemisphere. Arrows in D and F indicate the same significant voxel (t = 5.2), also in TEad, in the right hemisphere. t-Maps range from 3.8 (P = 0.001) to 7.0 (P < 6.5 × 10⁻⁷) and above. Corrected at FDR = 0.028. (G,H) Plot of BOLD responses to high and low value images in the clusters indicated.
读法:A–F 从冠状、矢状、表面重建三个视角交叉定位,箭头分别锁定左右半球 TEad 的显著体素(t = 5.8 与 5.2),价值效应还延伸进 STS 内的 TEa、TEm。G、H 给出对应簇的高/低价值 BOLD 曲线。价值效应呈斑块状分布,这是讨论中"IT 价值斑块可能与物体选择皮层相关"推断的图像依据。支撑结果第 4 条。
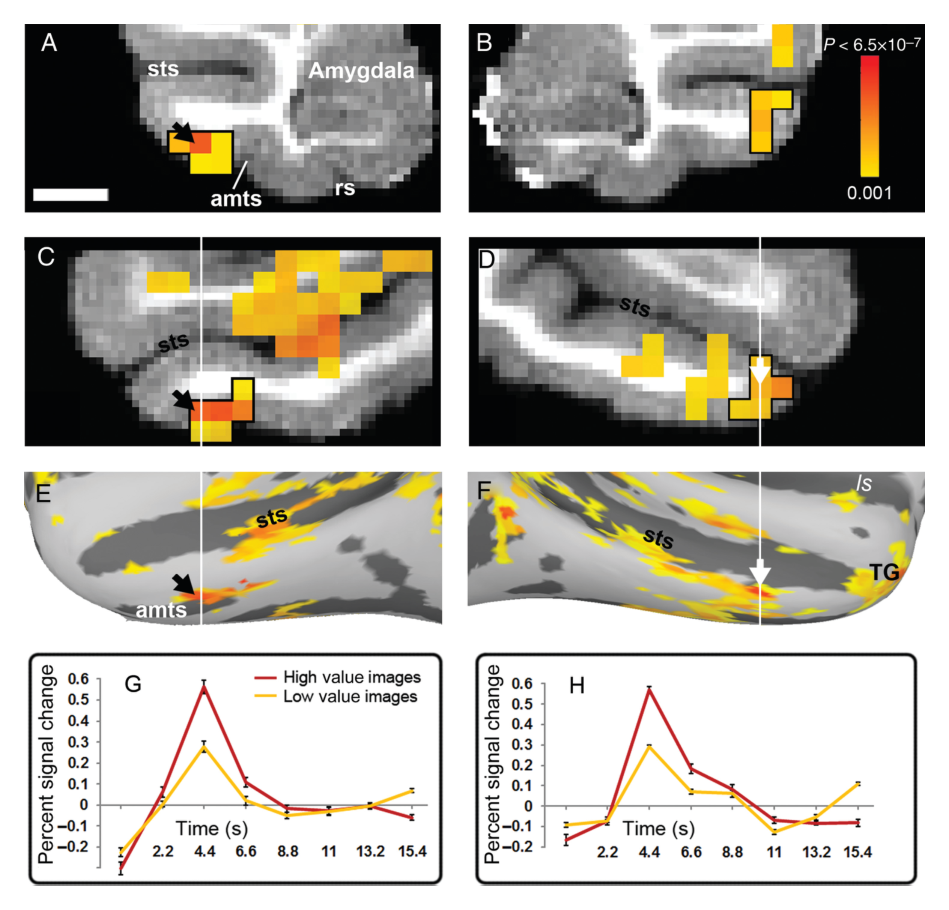
图 9 · 颞极的价值表征
原文图注:Figure 9. Image value represented in temporal polar cortex. (A) A sagittal section showing the location of area TG, surrounded by a white box. Significant effects of image value from view trials were found within the anterior temporal pole, in ventral area TG (B,C), continuing caudally to TEa/36 (E,G). White lines in B, D, and F indicate the coronal planes shown in C, E, and G; black lines in C, E, and G indicate the sagittal planes shown in B, D, and F. t-Maps range from 3.8 (P = 0.001) to 7.0 (P < 6.5 × 10⁻⁷) and above. Corrected at FDR = 0.028.
读法:用矢状与冠状切片的白线/黑线互相引用来展示价值效应在颞极的前后延伸范围:从腹侧 TG 一路到 TEa 与嗅周区 36。右侧簇大、左侧簇小。颞极/嗅周皮层是 IT 与内侧颞叶记忆系统的接口,价值信号出现在这里暗示"学会的价值"可能正在向记忆系统传递。支撑结果第 4 条的颞极部分。
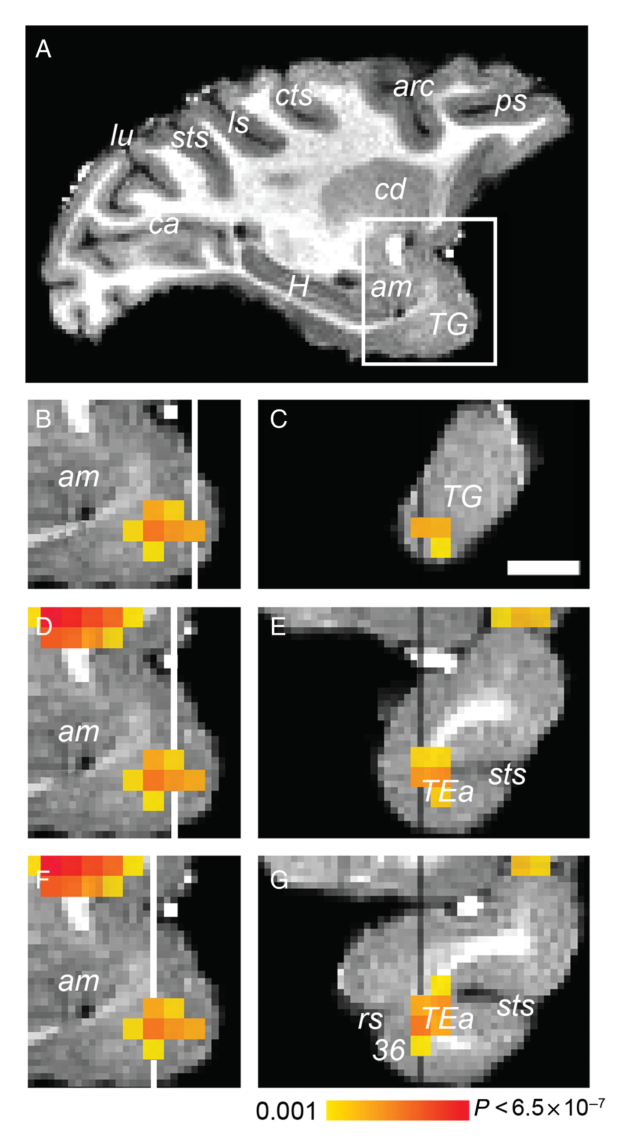
图 10 · 杏仁核的阴性结果
原文图注:Figure 10. Image value and visual responses in the amygdala. An anatomical mask was applied (not shown) to analyze data only in the amygdala; no significant effects of image value are present in the amygdala (Panel A). Visual responses are evident in the dorsal and lateral portions of the amygdala (t-statistic, P = 0.005, FDR corrected 0.008). Scale bar is 5 mm.
读法:这是一张"证明阴性结果可信"的图:A 中价值对比在解剖掩膜内无显著体素,但 B 显示同一结构对视觉刺激有明确反应(背外侧部阳性)。作者据此论证杏仁核阴性并非 tSNR 太低(实测 50–150)或信号恢复失败所致。支撑结果第 5 条,也引出讨论中"奖励预测图像与情绪面孔在杏仁核中加工方式不同"的假说。
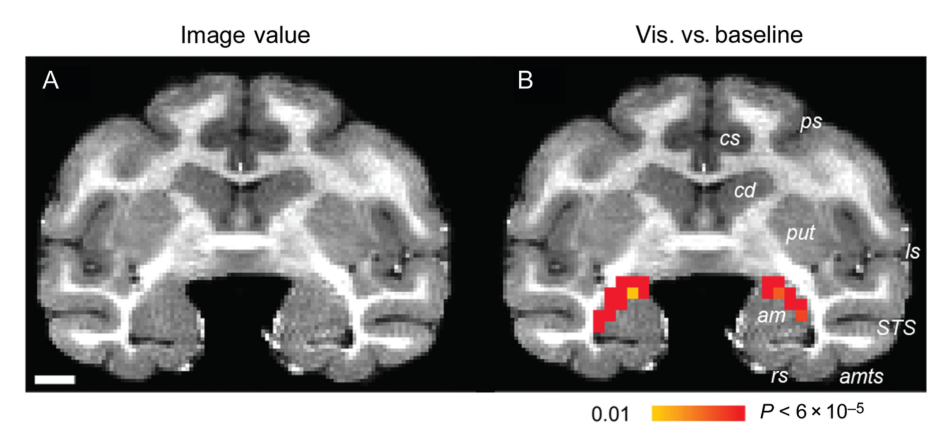
图 11 · 纹状体中价值与奖励到手的背腹分离
原文图注:Figure 11. Image value and reward receipt in the striatum. (A,B) Significant image value effects from view trials are shown at 2 anterior–posterior levels in the coronal plane. t-Maps range from 3.125 (P = 0.005) to 7.0 (P < 6.5 × 10⁻⁷) and above; corrected at FDR = 0.008. (C,D) Significant reward receipt effects are shown at equivalent anterior–posterior levels as in A,B. t-Maps range from 3.125 (P = 0.005) to 7.0 (P < 6.5 × 10⁻⁷) and above; corrected at FDR = 0.004. Dorsal striatum, including caudate head and putamen, encode value, but are not responsive to reward receipt. The ventral striatum, ventral putamen, and insula are responsive to reward receipt.
读法:A、B 是价值效应(前后两个冠状层面),C、D 是同层面的奖励到手效应。对比可见:价值信号偏背侧(尾状核头、壳核背部),奖励信号偏腹侧(腹侧纹状体、腹侧壳核);右腹侧壳核少数体素两者兼有。这一背腹分工与既有电生理结果(Apicella et al. 1991)吻合,为作者 fMRI 范式的有效性提供了内部校验。支撑结果第 5 条。
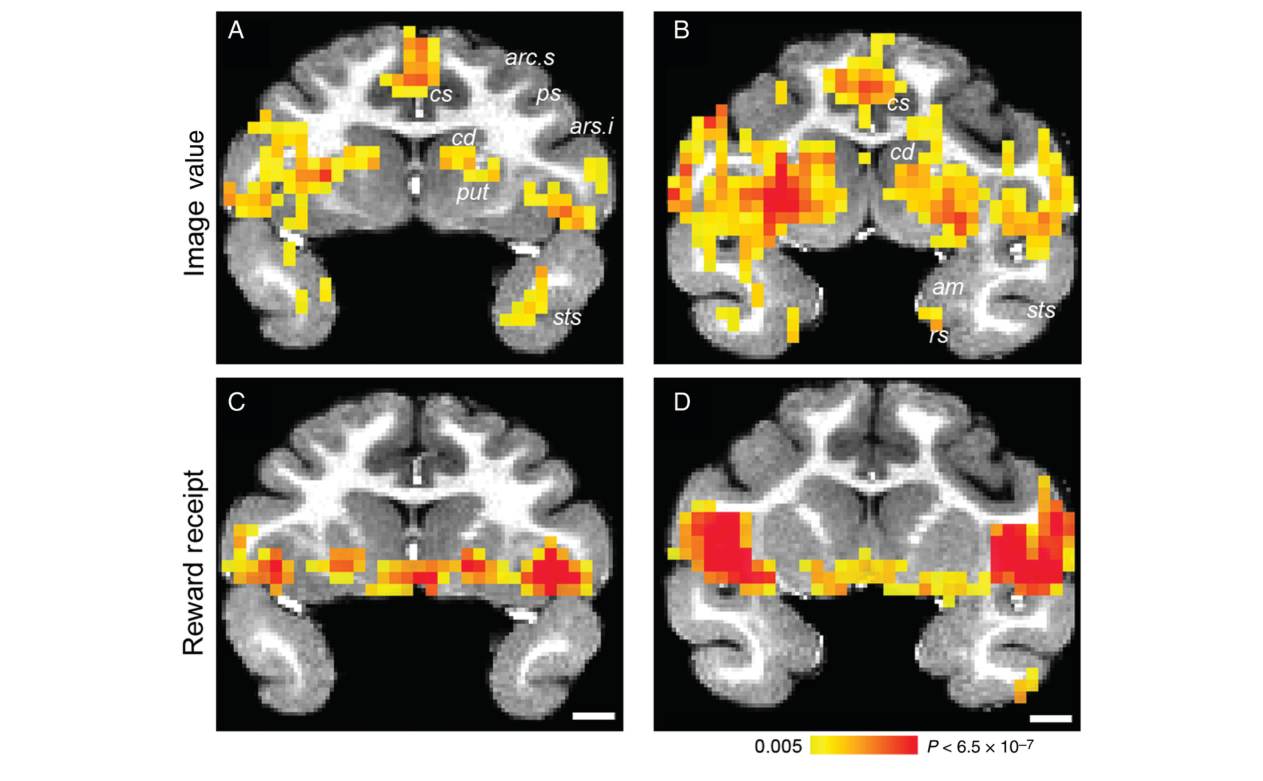
图 12 · 脑岛既编码价值也响应奖励
原文图注:Figure 12. Image value and reward receipt effects in the insula. (A,B) Sagittal (A) and coronal (B) sections showing image value effects from view trials with the anterior insula circled in black. t-Maps range from 3.8 (P = 0.001) to 7.0 (P < 6.5 × 10⁻⁷) and above; corrected at FDR = 0.012. (C,D) The same region of the insula responsive to image value (A,B) is responsive to reward receipt. The arrows in panels A and C indicate a portion of the posterior insula encoding only image value and not reward receipt. (E) Time courses of BOLD responses to high and low value images in the anterior insula (denoted by black circle) and to reward receipt in same region.
读法:A、B 中黑圈标记前部脑岛的价值效应;C、D 显示同一区域也响应奖励到手——脑岛是少数"双重职责"区。白/黑箭头指出的后部(可能为颗粒区)岛叶只对图像价值反应、不对奖励反应,说明岛内存在功能亚区。E 的曲线同时展示高/低价值图像反应与奖励到手反应。双侧效应但右侧更强。支撑结果第 5 条与联合分析部分。
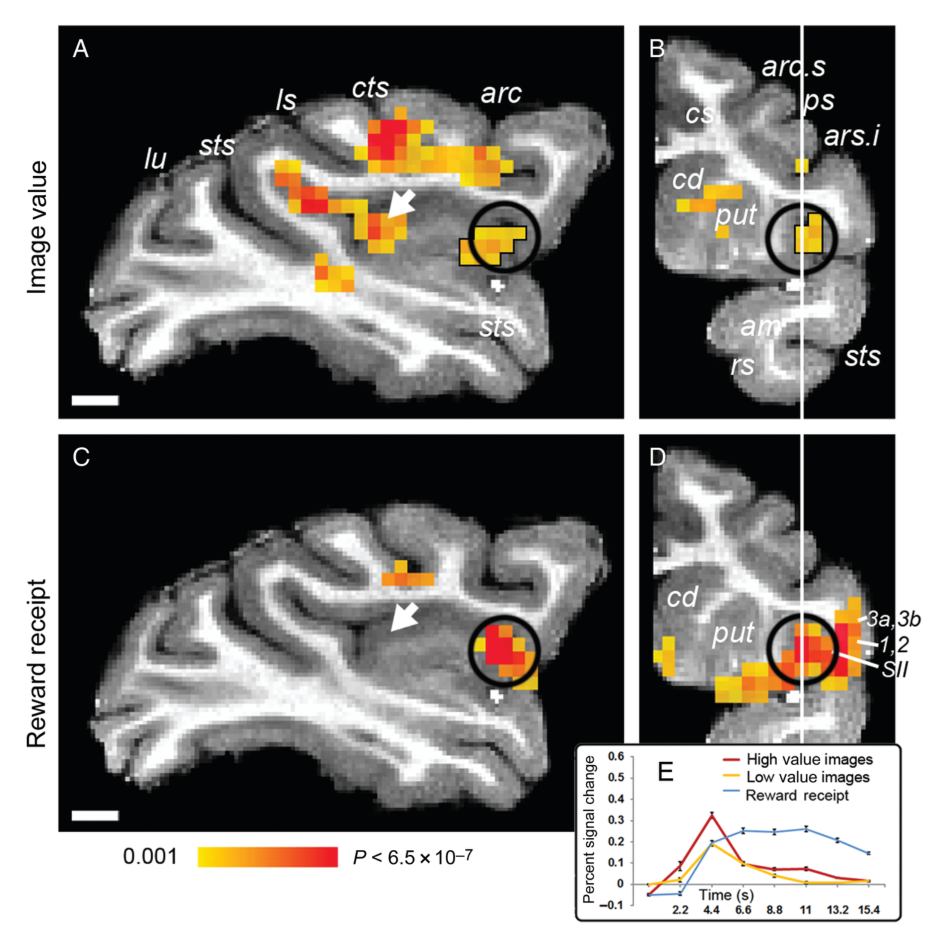
图 13 · 联合分析:兼编码价值与奖励的区域
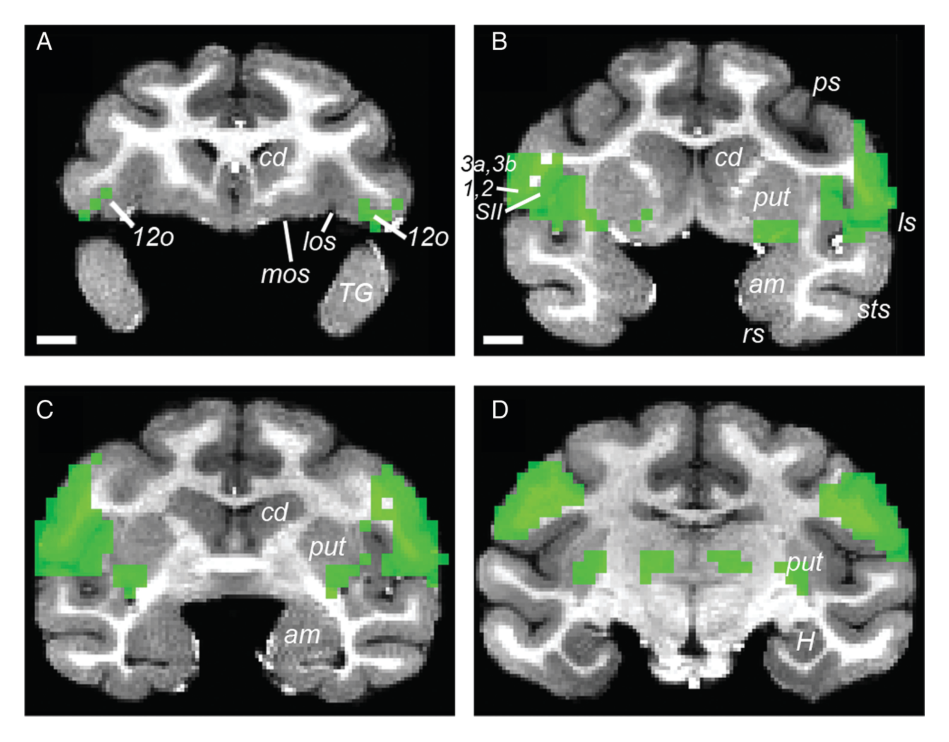
原文图注:Figure 13. Areas encoding both image value and reward receipt. A conjunction analysis revealed a limited number of areas that encode both image value (from view trials) and reward receipt (conjunction of t-Maps at P = 0.01 in each map).
读法:把"价值 t 图"与"奖励 t 图"各取 P = 0.01 阈值后求联合,剩下的交集区域很少:VLPFC 12o、前部与中央背侧非颗粒脑岛、腹侧及后部壳核的一部分(文中还提及相邻的味觉皮层 G、中央前盖部 PrCO 与面/口腔体感区,以及丘脑 VPL/VPM)。这张图回答的是"哪些区域是纯粹价值编码、哪些是双重职责"——这张图检验哪些体素同时呈现显著的图像价值效应和奖励到手效应。在两张统计图分别采用P=0.01阈值时,显著交集较为有限,提示两类效应的空间分布仅部分重叠;未进入交集不等于没有奖励反应。支撑结果第 5 条末尾。
讨论
作者对两个"意外"各给了一套解释。关于 OFC 几乎不编码图像价值:其一,本任务用奖励概率操纵价值,所有图像预测的奖励在类型和数量上完全相同(都是 0.3 mL 水),而既有电生理中 OFC 神经元编码的往往是奖励的感官属性(果汁口味、数量);OFC 可能专门负责把结果的感官特性(flavors、amounts)与预测性图像或动作关联起来(Noonan et al. 2011;Schoenbaum et al. 2011;Rudebeck and Murray 2014),要激活 OFC 或许需要对口味的操纵。其二,本设计测量的是"已学会之后"的价值提取,OFC 可能更多参与学习过程本身而非保持已学表征(Gottfried et al. 2002;Nelissen et al. 2012 的可卡因条件化实验支持这一时间窗的说法)。与之相对,MFC 10m/32 的强价值信号与人类 fMRI 文献的元分析结论高度一致,而该区在猴身上因电生理难以触及而证据稀少;作者推测它可能是所有哺乳动物脑中都存在的内侧无颗粒区的同源结构(常称 prelimbic cortex),并提醒不要把它与更背侧、更后部的扣带区混为一谈。VLPFC 12 的结果则与 Rich and Wallis (2014) 的单细胞记录(12 区价值编码神经元比例最高)及 Chau et al. (2015) 的 win-stay/lose-shift 信号相呼应,损毁文献中该区参与客体反转学习的角色也因此有了机制性解读。
关于视觉系统,作者认为 IT 编码新学价值的最可能机制是学习过程中发生的可塑性:杏仁核在条件改变时向 IT 传递信息、学习完成后不再传递,可以解释杏仁核本身无价值信号而 IT 有;FEF 与 LIP 在本任务中均不编码价值,提示这些信号并非对高概率图像的注意增强,不过作者也坦承奖励与注意 notoriously 难以分离(Maunsell 2004),注意解释无法完全排除。IT 价值效应的斑块状分布则可能与物体选择皮层有关,留待验证。奖励到手方面,OFC 11/13/14 的反应与大量单细胞和人类味觉 fMRI 一致,这反过来"救活"了 OFC——它对奖励本身的反应强烈,说明阴性不是扫描问题;脑岛/12o/体感区的奖励反应可能与饮水舔舐动作有关,但 Arsenault et al. (2014) 刺激 VTA 引起同区激活的结果反对纯运动/体感解释。局限方面作者还指出,单细胞记录的采样范围有限,fMRI 的全脑覆盖恰好补上这一点,但 fMRI 无法回答因果问题——这批候选脑区留给未来的操纵实验。
一句话总结
在我看来,这篇文章真正的贡献不是又找到几个"价值脑区",而是把"价值"拆成了两件事:图像价值相关BOLD活动见于MFC、VLPFC和IT等区域,奖励到手相关活动见于OFC、腹侧纹状体和脑岛等区域;部分区域同时呈现两类效应。这些结果不能确定各区域在价值存储、提取或奖励处理中的因果作用。——猴的 OFC 之所以"失灵",很可能只是因为这个任务里奖励没有任何感官差异可编码;反过来,IT 连 V1–V4 都会被学习改写这一点,把"价值调制视觉皮层"从人类的间接证据变成了猴脑内的直接定位,值得每个做视觉注意与奖励交互的人把图 4 的训练前/后对照当作方法模板收藏。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig10: 提取质量
good,对齐度full,识别面板[] - Fig11: 提取质量
good,对齐度full,识别面板[A, B, C, D] - Fig12: 提取质量
good,对齐度full,识别面板[A, B, C, D] - Fig13: 提取质量
good,对齐度full,识别面板[A] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[A, B] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[A] - Fig7: 提取质量
good,对齐度full,识别面板[C] - Fig8: 提取质量
good,对齐度full,识别面板[A, B] - Fig9: 提取质量
good,对齐度full,识别面板[A]
关键事实与局限性声明
- 审校纠偏: {'issue_id': 'ISSUE_001', 'classification': 'OVERCLAIM', 'claim': 'MFC、VLPFC和IT负责价值存储或提取,OFC、腹侧纹状体和脑岛负责奖励接收', 'reason': '相关性fMRI结果被提升为脑区的确定性因果功能分工。'} -> 评注:
- 审校纠偏: {'issue_id': 'ISSUE_002', 'classification': 'OVERCLAIM', 'claim': 'OFC价值效应弱只是因为奖励缺少感官差异', 'reason': '这是作者提出的多个可能解释之一,研究没有直接检验或排除其他解释。'} -> 评注:
- 审校纠偏: {'issue_id': 'ISSUE_003', 'classification': 'OVERCLAIM', 'claim': '首次证明学习把价值写入IT和早期视觉皮层', 'reason': '“首次”缺乏原文支持,BOLD变化也不能单独证明局部神经可塑性机制。'} -> 评注:
- 审校纠偏: {'issue_id': 'ISSUE_004', 'classification': 'OVERCLAIM', 'claim': '未进入联合显著图的价值编码区不响应奖励', 'reason': '未达到统计阈值不等于不存在反应。'} -> 评注: