IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
117| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:minor_issue
Mild perceptual categorization deficits follow bilateral removal of anterior inferior temporal cortex in rhesus monkeys
Matsumoto · The Journal of Neuroscience · 2016 · Zotero itemID=1220
这是一篇经典的得失实验式损毁研究:作者在双侧切除前下颞叶皮层(anterior inferior temporal cortex, area TE)前后测试同一批恒河猴的视觉分类能力,结果出乎意料地温和——猴子切掉 TE 之后依然能把猫狗、人脸/猴脸正确归类,甚至只用一个 session 就学会"汽车 vs 卡车"这对新类别,并推广到从未见过的图片。它值得读,是因为它直接检验了"TE 是物体识别的终点站、因此也理应是分类能力的支柱"这一未经测试的标配假设,并给" categorization 到底需要 TE 做什么"留下了一个清晰的谜题。
研究背景
按层级汇聚加工(hierarchical convergent processing)的正统观点,视觉信息经一系列逐级整合的加工阶段,终于灵长类的下颞叶:TE 对复杂整体物体的感知与记忆必不可少(Iwai and Mishkin, 1968; Cowey and Gross, 1970; Gross et al., 1972 等一系列损毁与生理工作),TE 神经元对面孔和复杂物体有选择性(Tanaka, 1996; Desimone et al., 1984),TE 内还有面孔/非面孔等类别样偏好斑块(patch),微刺激这些斑块甚至能偏置面孔分类行为(Afraz et al., 2006)。TE 损毁的猴子在把物体推广到新视角、以及同时记忆八个先前未见物体方面也确实受损(Weiskrantz and Saunders, 1984; Buffalo et al., 1999)。顺理成章地推断:视觉知觉分类(perceptual categorization)——把形形色色的复杂物体按物理相似性归组——理应依赖 TE 完整。可这个推断并没有被直接测试过。
另一条背景线索来自同一团队的先行工作。前额叶皮层曾因为出现类别调谐神经元而被视为分类的候选区(Freedman et al., 2001),但 Minamimoto 等(2010)发现,侧前额叶大损毁的猴子既不丧失已学会类别的推广、也不影响新类别的习得与推广——他们用的正是猫/狗、汽车/卡车图片 incentive 任务范式。既然前额叶出局,"分类到底靠哪里"就更指向 TE,却始终没有人在同一批动物上做术前/术后的直接对照。缺口就在这里:TE 对类别推广到底有多必要?
研究思路
作者采用被试内前后对照设计:三只实验猴先在 TE 完整时学好任务,然后双侧切除 TE,再测同样的任务。任务体系层层递进:任务 1 用内隐测量(implicit measure)——靠"低激励试次错误率升高"这一稳定的行为签名来判断猴子是否区分了两个类别,不要求显式选择;任务 2 把同一任务改成非对称奖励的双间隔强迫选择(two-interval forced choice, 2-IFC)的显式分类,并加入三只正常对照猴,以排除"内隐/外显任务用了不同神经基质"或"动机注意力差异"的解释;任务 3 用正弦光栅对比敏感度控制视锐度与程序学习能力;任务 4 用经典的 WGTA 辨别任务检查本研究的损毁是否复现历史上报道过的 TE 缺损模式,从而排除"我们的手术切得不对"这一可能性。此外还用线性支持向量机(support vector machine, SVM)在像素层面估算了每对类别可分类性的上限,用来判断猴子(尤其 TE 损毁猴)的表现究竟意味着什么。
方法
任务 1、4 使用三只实验前无手术史的雄性恒河猴(3.9–5.75 kg),任务 2、3 另加三只未手术对照猴。TE 切除用吸引术(aspiration)在无菌条件下完成,改为'自下枕沟前端界标 1 cm 处起、向吻侧延伸至颞极'或直接保留原文句式,避免擅自加方向。,背侧达颞上沟沟底、腹内侧到枕颞沟外侧壁与前中颞沟-嗅沟中点之间;损毁范围由 1.5 T MR 冠状切片(层距 1 mm、面内分辨率 0.4 mm)对照立体定位图谱重构确认,三只动物 TE 均被大体切净(因还要做后续实验,无组织学验证)。
行为框架:猴子握住杠杆、屏幕先出现线索图像(13° 见方),0.4 s 后出现红色目标,0.5–1.5 s 后变绿,猴子须在绿靶出现后 3 s 内松杆得果汁,提前或过晚松杆记错误并伴随数秒计时暂停。任务 1 中试次分高激励(高奖励)与低激励(低或无奖励)两组,两种黑白块图案先行训练数个 session(T、K、G 分别 6、10、27 个)直至低激励试次错误率稳定偏高,随后把图案换成类别图片:狗(高激励)vs 猫(低激励)、人脸 vs 猴脸,之后还有术后新学的汽车 vs 卡车(卡车高激励)。猴子若真在"按类别"区分线索,就会在低激励类别上犯更多错误——错误率之差就是分类能力的内隐指标。每套类别各含 20+20 张训练图片(jpeg/pcx,200×200 像素,背景手工抹白),另有狗猫、人脸/猴脸、汽车/卡车各 240+240 张一次性试次图片(trial-unique,即从未见过也不会重复出现的样本),取自网络与标准数据库(Georgia Tech、LFW 等),视角、颜色、大小变化很大且在两类间高度重叠。任务 2 改为显式 2-IFC:看到猫就在红靶期间松杆(跳过该试次),看到狗就等到绿靶松杆拿奖励。任务 3 呈现全屏正弦光栅(16–0.125 周期/度的空间频率、多档对比度)测对比敏感度。任务 4 在威斯康星通用测试装置(Wisconsin General Testing Apparatus, WGTA)里做三种经典辨别:加号 vs 方块图案卡、一对三维杂物物体、以及八对三维物体的并行(concurrent)学习,达标标准为连续三个 session 准确率 ≥90%。分析用 MATLAB 常规检验加上 R 的广义线性混合模型(generalized linear mixed model, GLMM;二项分布、随机斜率与截距)处理被试内重复测量;SVM 以 RGB 像素分解为输入、90%/10% 随机划分交叉验证 100 次。
主要结果
- 任务 1(图 3):术前三只猴子在狗/猫与人/猴两套线索上都表现出显著的错误率不对称(低激励类别错误更多;各猴 χ² 检验均显著,如狗/猫的 p 值低至 1.0×10⁻¹⁰ 量级)。术后:人/猴线索从第一个 session 起三只猴子全部重新表现出显著不对称;狗/猫则要 1–3 个 session(T 第 1 个、K 第 2 个、G 第 3 个)才恢复。跨术前术后四个 session 的 GLMM 显示,狗/猫总体表现有一个小而显著的损毁效应(z=-2.51,p=0.012)以及显著的类别 × 损毁交互(p 为 4.8×10⁻¹¹ 量级);人/猴则无(p=0.089)。即只有轻微、且主要针对狗/猫的损伤。
- 错误并非集中在少数几张图(图 4):各 session 中三只猴子的错误分布在整套线索上,说明它们不是靠记住几张关键图片通过任务的。
- 一次性样本推广完好(图 5):术后用 480 张全新狗猫图片(每个 session 各 240 张)测试,三只猴子高低激励线索的错误率与累计错误数差异均显著;人/猴脸 480 张全新样本同样全过;更关键的是术后新学的汽车/卡车——T 与 G 在第 1 个 session 就出现显著差异(p=0.02 与 3.6×10⁻¹¹ 量级),K 第 3 个 session 达显著——这与术前学狗/猫的速度相当,随后对 480 张全新汽车/卡车图片也全部推广成功。切除 TE 的猴子不但保住了旧类别,还能照常快速学新类别。
- 显式任务(图 6):六只猴子都在 7 个 session 内掌握 2-IFC 规则(TE 猴 4–5 个,对照猴 4–7 个)。480 试次独特样本连续四个 session 测试中,对照猴平均正确率 85%,TE 猴 73%(改为 z = −13.36, p < 2.0×10⁻¹⁶。),显著低于对照但远高于 50% 机遇水平——温和而真实的分类缺损。
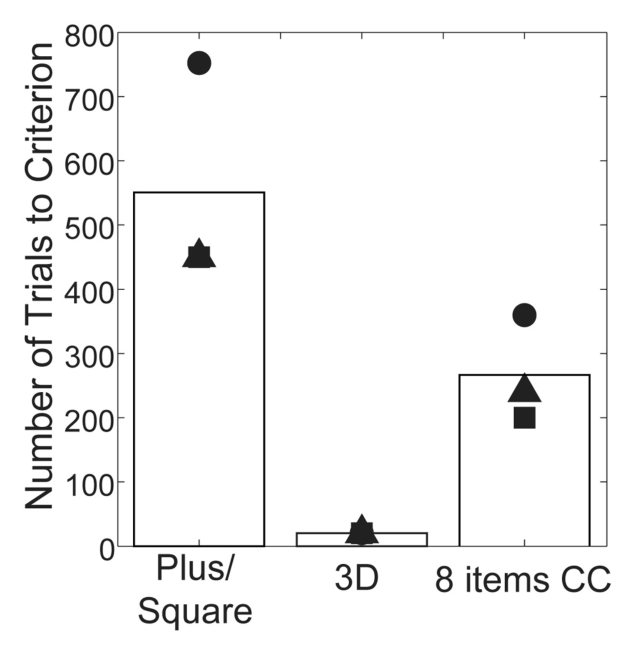
- 对照与分离(图 7、8):TE 猴的光栅对比敏感度曲线与对照猴无法区分(组别与组别 × 频率效应均不显著),排除视锐度与程序学习问题;同时它们在 WGTA 上完整复现经典 TE 缺损——图案对辨别与八对并行学习吃力、单对三维物体辨别不难。像素级 SVM 对各套刺激的线性分类上限为:人脸/猴脸 96%(95 分位 100%)、汽车/卡车 74%(95 分位 85%)、狗/猫仅 65%(95 分位 75%)。正常猴(85%)远超线性分类器对狗/猫的上限,而 TE 猴(73%)恰落在分类器上限附近。
图注解读
图 1 · 损毁范围
原文图注:Figure 1. A, MR images of prelesion and postlesion brain (white rectangles, right) at the vertical line on a surface view (left). B, Lesion reconstructions for the three monkeys with TE removals.
解读:A 是表面视图上某条竖线所在位置的术前/术后 MR 冠状面对比,白框标出缺损部位;B 把三只猴子的损毁逐一重构到标准图谱上。读这张图要点在于确认损伤集中在颞极方向的前下颞皮层、双侧对称,为"后面的行为缺损可归因于 TE 切除"提供解剖依据。
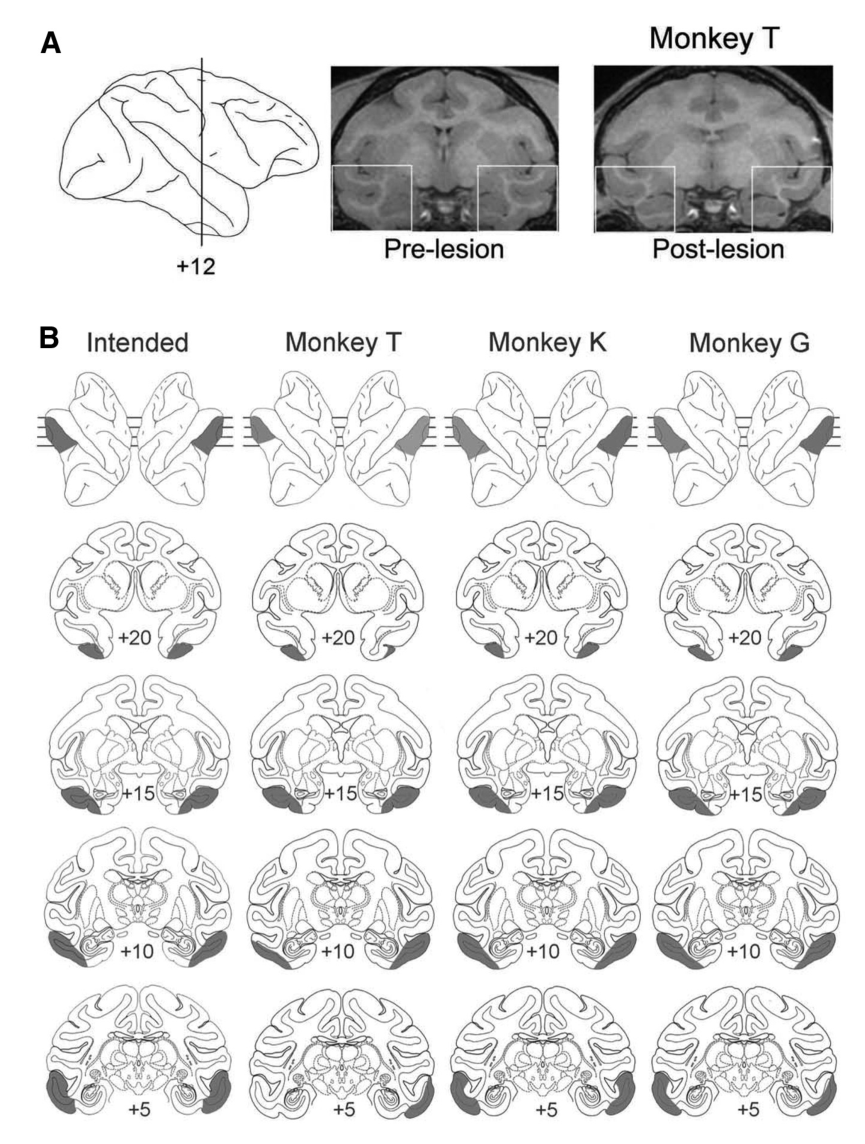
图 2 · 任务流程与线索集示例
原文图注:Figure 2. A, Sketch of the sequence of events during one trial. B, Examples of visual cue sets. Top, Twenty dogs and 20 cats. Bottom: Twenty dogs and 20 cats out of 240 trial-unique dogs and 240 trial-unique cats. ITI, Intertrial interval.
解读:A 给出一试次的时间线:握杆—图像—红靶—变绿—松杆奖励,错误则计时暂停;B 上排是 20+20 张训练集狗猫照片,下排是 240+240 张一次性样本中的各 20 张示例,可见视角、毛色、构图差异很大。它支撑方法部分对内隐任务与刺激集的描述。
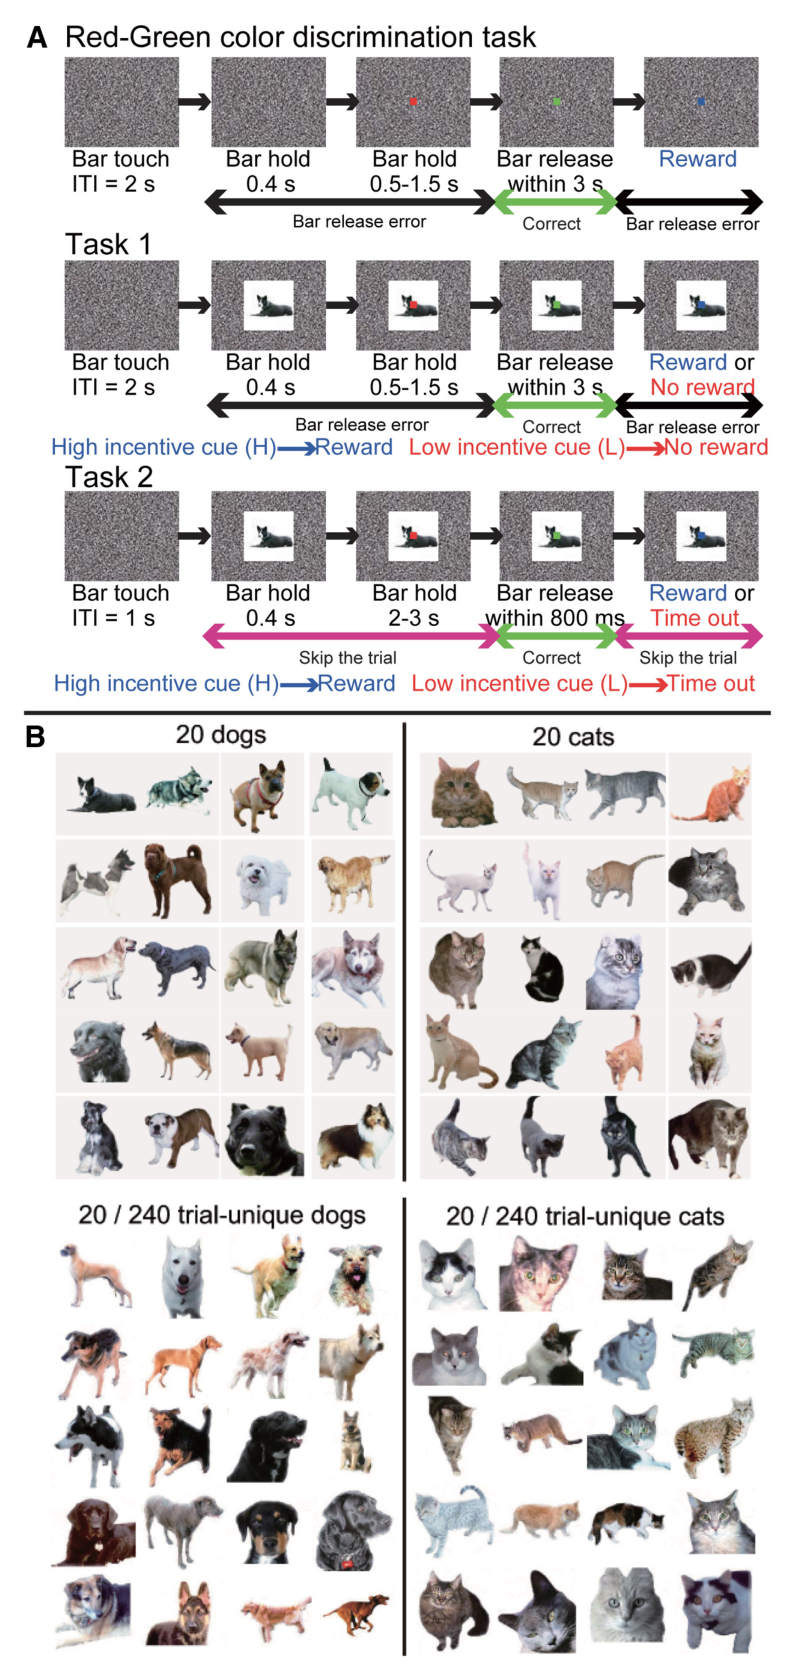
图 3 · 任务 1 各 session 的高低激励错误率
原文图注:Figure 3. Error rates in Task 1 for high- (H) and low-incentive (L) cues in each session. The inset images indicate which cue sets were used in each session. Blue and red bars represent mean error rates for the high and low-incentive cues, respectively. Symbols indicate error rates for individual monkeys. A, C, Results for the prelesion tests. B, D, E, Results for the postlesion tests.
解读:横轴是测试 session,纵轴是错误率;蓝柱为高激励(H)、红柱为低激励(L);小图标提示该 session 用的是哪套线索(狗/猫或人/猴)。读法是看红柱是否高出蓝柱:术前(A、C)两套都有明显差;术后(B、D、E)人/猴立刻恢复、狗/猫晚一到两个 session,且差幅可能略收窄。此图支撑主要结果第 1 条。
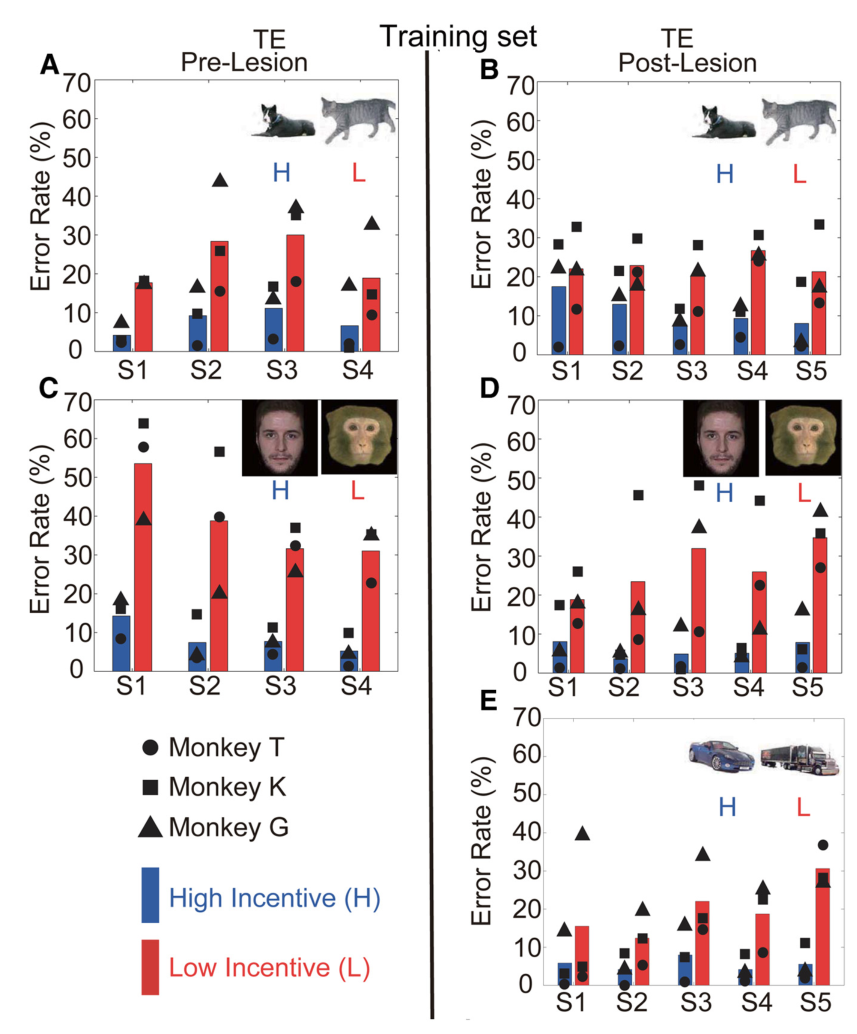
图 4 · 错误按单张刺激的分布
原文图注:Figure 4. Summation of error rates for individual stimuli in Task 1. A, C, Results for four sessions of prelesion tests (each represented by a different color in the stacked bar). B, D, E, Results for five sessions of postlesion tests. The thin black vertical line delineates the categorical boundary between high- (H) and low-incentive (L) cues. Mean error rates of the three monkeys in sessions were stacked.
解读:横轴一张刺激一张位次(黑竖线左边是高激励类、右边是低激励类),堆叠柱按 session 分色累计三只猴子的错误率。若猴子只记住几张关键图,错误应集中在个别刺激上;实际分布相当均匀。它支撑主要结果第 2 条,即分类不依赖对少数样本的记忆。
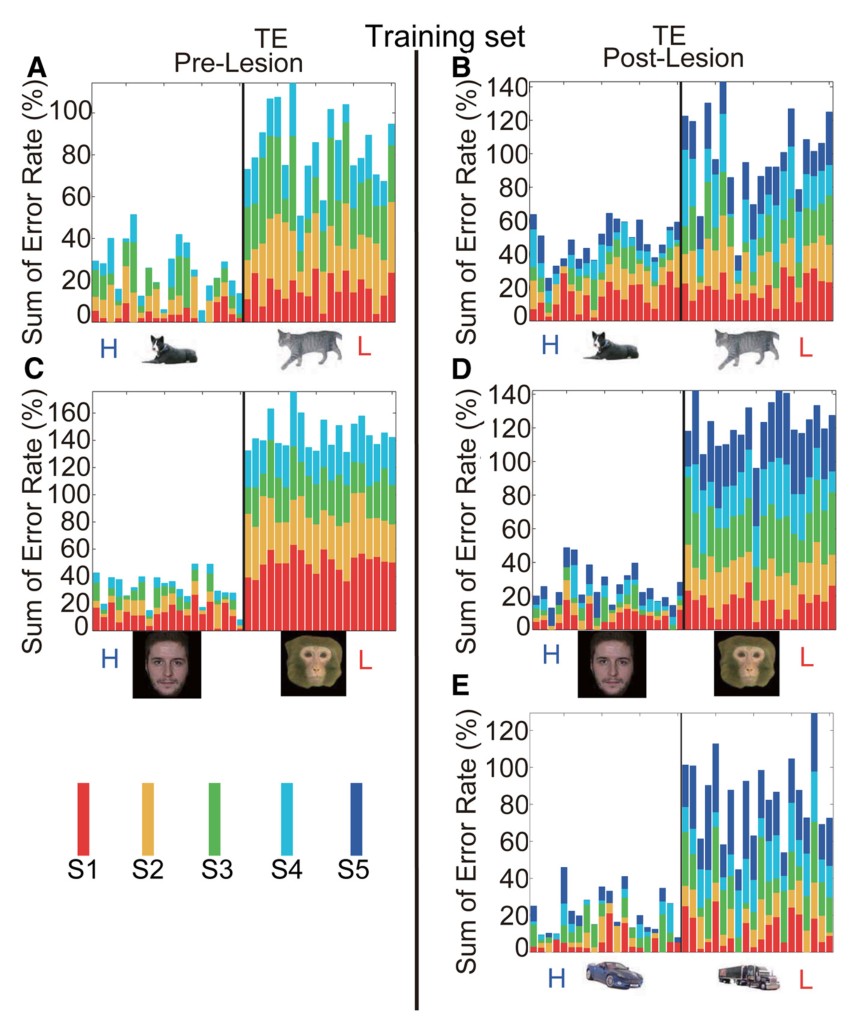
图 5 · 一次性样本的分类与累计错误
原文图注:Figure 5. Error rates and cumulative error counts for high- (H) and low-incentive (L) trial-unique cues in Task 1. A, C, E, Error rates for the high- and low-incentive cues. The meanings of bars, symbols, and images are the same as in Figure 3. B, D, F, Cumulative error counts for the high- and low-incentive cues. The scale of cumulative error counts changes substantially. The figures in the left, middle, and right columns show the results for Monkeys T, K, and G, respectively. The vertical lines show the trial at which the difference in cumulative errors for the high- and low-incentive cues becomes significant (p < 0.05 by χ2 test for 5 consecutive trials).
解读:左(A、C、E)为高低激励的错误率柱状图,右(B、D、F)为按试次累加的错误计数曲线,三列对应三只猴子;某条竖线之后的累计差异在连续 5 个试次上 χ² 检验显著(p<0.05)。竖线出现得早、两条曲线分得开,说明猴子面对全新图片几乎立即按类别区别对待。此图支撑主要结果第 3 条:推广到一次性样本且新类别照样学得快。
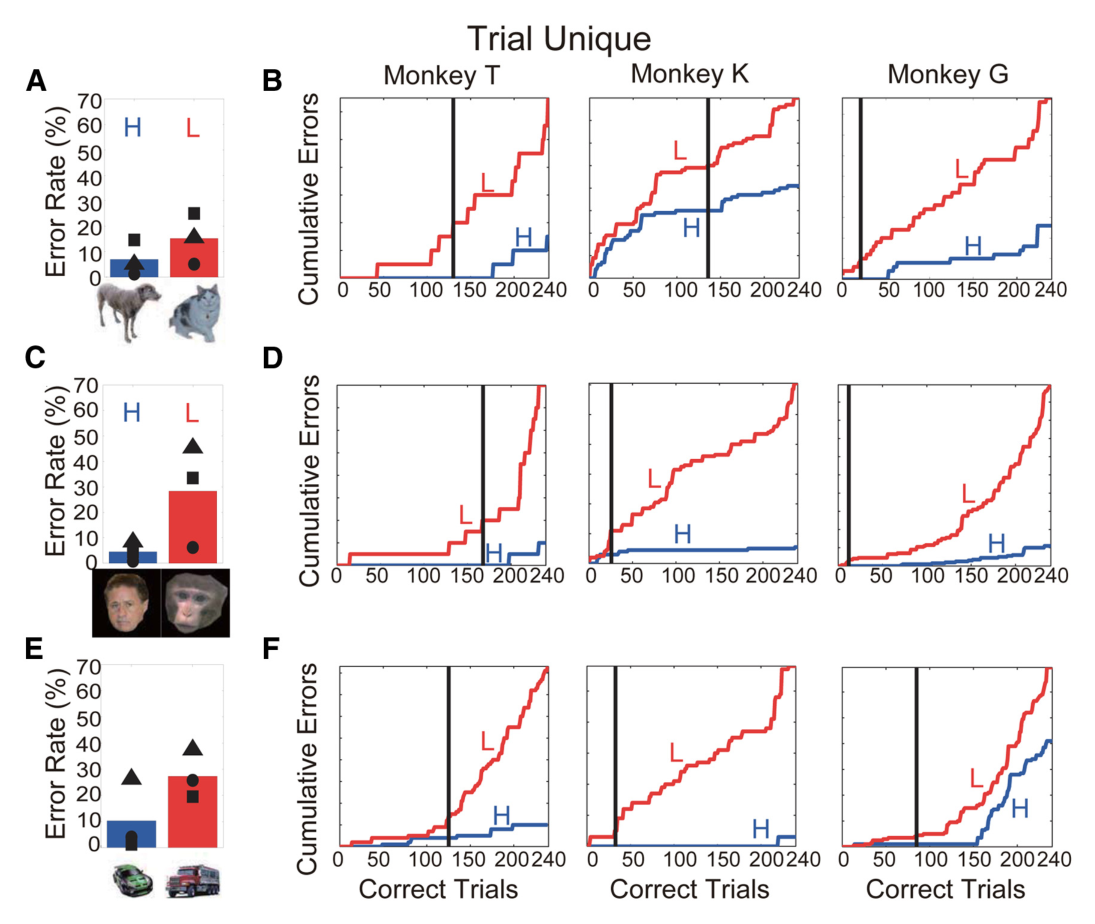
图 6 · 显式 2-IFC 分类的正确率
原文图注:Figure 6. Correct rates in Task 2: explicit choice task for trial-unique dogs/cats on four consecutive sessions for control (Ctrl) and TE-lesioned (TE) monkeys. Symbols and bars indicate correct rates for individual monkeys and their averages, respectively.
解读:横轴为四个连续 session,纵轴为对全新狗猫样本的正确率;符号为单猴、柱为组均值。TE 组(73%)系统性低于对照组(85%),但两者都远高于 50% 的机遇线。此图支撑主要结果第 4 条:缺损温和而非灾难性。
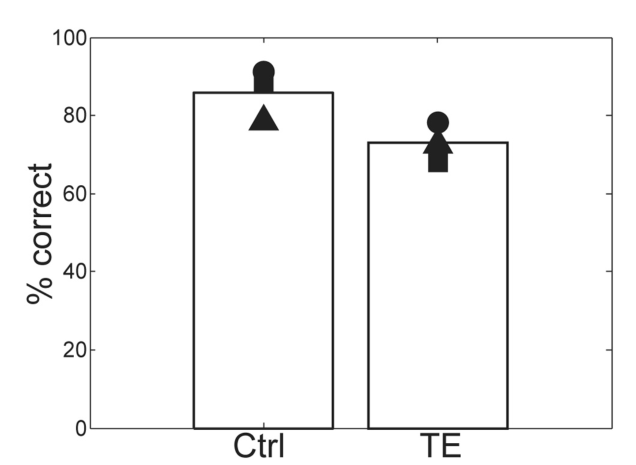
图 7 · 对比敏感度函数
原文图注:Figure 7. The contrast sensitivity functions for control (Ctl) and TE-lesioned (TE) monkeys. Contrast sensitivity is plotted on a logarithmic scale against spatial frequency. The fitted curves are quadratic functions.
解读:横轴为空间频率(周期/度),纵轴为对比敏感度(阈限对比度的倒数,对数刻度),曲线为二次拟合。两组曲线重合、组别差异不显著,说明 TE 切除没有伤及基本视锐度。此图是主要结果第 5 条的方法学对照部分,用来排除"分类缺损其实是看不清"的解释。
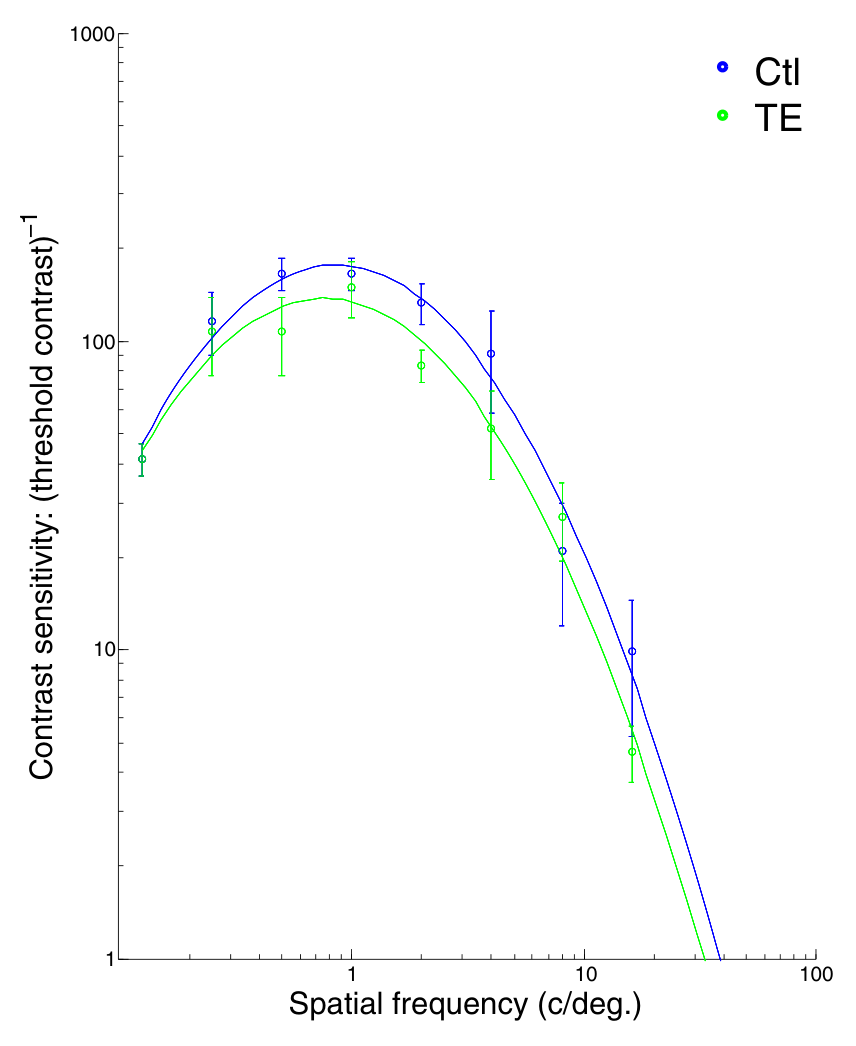
图 8 · WGTA 经典辨别的学习所需试次
原文图注:Figure 8. Number of trials to criterion in Task 4: WGTA tests. Symbols and bars indicate the numbers of trials for individual monkeys and their averages, respectively.
解读:纵轴为达到标准(连续三 session ≥90%)所需试次数,三种任务分别为加号/方块图案对、单对三维物体、八对并行学习。TE 猴在图案辨别与八对并行学习上所需试次大增,单对三维物体则不难——这正是历史文献中 TE 损毁的典型模式。它支撑"我们的损毁与既往研究等价"的论证,也勾勒出 TE 真正关键的功能:简单特征联合的记忆。
讨论
作者先确认本研究的损毁复现了经典缺损模式(图案辨别与八对并行学习受损),所以"分类保持完好"不能归咎于手术不彻底;对比敏感度又排除了视锐度与程序学习因素。至于为什么切掉 TE 分类还在,作者列出四种可能:其一,分类是分布式功能,没有任何单一关键区可以被灾难性地击中;其二,真正关键区尚未找到,候选包括在视觉层级中位于 TE 之后的嗅周皮层(perirhinal cortex,负责刺激-刺激与刺激-奖励关联、新视角推广、高特征重叠刺激之间的辨别)、TE 之前的 TEO、以及直接接受 TEO 输入且载有刺激-奖励关联的杏仁核——不过作者指出本研究的 TE 切除理应几乎剥夺了嗅周皮层的主要视觉输入,这一候选并非没有困难;其三,单细胞电生理提示粗略模式信息在 TE 神经元反应中出现得早于精细信息(Sugase et al., 1999; Matsumoto et al., 2005),类别推广所需的粗分析也许在精细模式分析之前就完成了;其四,分类所用的图像分析与模式辨别的最终步骤可能是并行且分离的(这一可能也解释了啮齿类何以能做视觉推广,Zoccolan et al., 2009)——若如此,主流灵长类视觉模型中"分类与模式识别在同一阶段互相依赖"的假设都需要修订。作者还强调任务 1、2 只需要类别层面的记忆而不需要工作记忆(线索全程在线,不同于延迟非匹配样本任务 DNMS),并承认吸引术可能伤及途经纤维,但因为主要发现恰恰是 TE 切除"无效",这一常识性顾虑反而构不成混淆。留下的追问是:类别判别的模糊度到什么水平时 TE 才变成关键?
一句话总结
我的读法是:这篇论文把"识别的终点站 = 分类的引擎"这个心照不宣的等式戳了个洞——猴子没有 TE 照样能在几百张从未见过的图上做形状构型的相似性归纳,却背不动一对黑白图案的记忆。按我的理解,被 TE 损毁文献反复测到的其实是一种"任意特征联合"的工作记忆负担,而自然类别的宽推广可能出自更早、更分散的机制;真正的悬念是作者自己那句追问——模糊度梯度上 TE 在哪一点才变得不可或缺。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A, B] - Fig2: 提取质量
good,对齐度full,识别面板[A, B] - Fig3: 提取质量
good,对齐度full,识别面板[A, B, C, D, E] - Fig4: 提取质量
good,对齐度full,识别面板[A, B, C, D, E] - Fig5: 提取质量
good,对齐度full,识别面板[A, B, C, D, E, F] - Fig6: 提取质量
good,对齐度full,识别面板[] - Fig7: 提取质量
good,对齐度full,识别面板[] - Fig8: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'severity': 'minor', 'md_section': '一句话总结', 'current_text': "被 TE 损毁文献反复测到的其实是一种'任意特征联合'的工作记忆负担", 'problem': "原文(摘要与讨论)的措辞是 'TE is needed for memory of simple conjunctions of basic features',且作者明确将 WGTA 式辨别学习与 DNMS 式工作记忆区分开来;WGTA 图案辨别与八对并行学习属于联想/辨别学习记忆,并非工作记忆。把经典缺损统一贴上'工作记忆负担'标签超出了作者自己的表述。该句以'我的读法'标注,属评述者推论而非原文事实,但术语不精确。", 'recommended_fix': "改为'对简单特征联合的(联想)记忆'或'简单特征联合的记忆负担',与摘要措辞对齐。"} -> 评注:
- 补充要点: : (第 6 页)
- 补充要点: : (第 10 页)