IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
115| 原始基线:V0_ZCODE_BASELINE| 语义审核:pass| 图表审核:minor_issue
The "inferior temporal numeral area" distinguishes numerals from other character categories during passive viewing: A representational similarity analysis
Yeo · Neuroimage · 2020 · Zotero itemID=1201
一句话定位:这篇文章针对一桩公案——"数字塑形区"(Number Form Area, NFA)在 fMRI 单元分析里始终找不到数字偏好证据——给出了一次漂亮的翻案:作者把三份共享同一被动观看范式的数据集(总 N=88)重新用表征相似性分析(RSA)拆解,发现后下颞回候选区在被试完全不必注意字符时,其分布式响应模式仍能按"数字 vs 其他"统一编码。它值得读,既示范了多变量方法对单元分析的敏感度优势,也用视觉形式模型(像素重叠、抽象形状距离)的系统性失败,直接论证了该区编码的不是"字形"而是"符号的数字相关性"。
研究背景
阿拉伯数字是现代社会人人必备的书写符号系统(任何母语文字都能拼写数词,但只有数字 0–9 支撑高效的位值十进制),可大脑如何把数字当作视觉对象来加工,长期以来几乎未知。二十多年前,脑损伤病人研究提出了腹侧枕颞皮层(ventral occipito-temporal cortex, vOT)存在支持数字加工的"数字塑形区"假说;fMRI 虽然在左梭状回定位到字母偏好区相当稳健,数字偏好区却始终 elusive。不过,颅内电生理(Daitch、Shum 等)和皮层电刺激(Roux 等)把一个数字偏好区稳定定位于后下颞回(posterior inferior temporal gyrus, pITG)外侧;Shum 等 2013 还发现该区对相似曲线特征的字母、打乱的数字、语义(数词"one")和语音(同音"won")都不同等激活,结论是它"调谐于数字的整体视觉形状"。fMRI 找不到该区的旧行,最早被归咎于 pITG 位置偏外、邻近空气-组织界面的信号流失。
但新证据渐渐指向另一种解释:任务需求调制。Grotheer 等 2018 发现重复检测任务下双侧 pITG 出现数字偏好,同一区域却在"数字加法 vs 骰子图案加法 vs 手指表征加法"中不作数字偏好——他们据此提出 pITG 神经元群的功能是"给视觉输入赋予数字内容"。Pollack 和 Price 2019 则发现左 pITG 只在"字母串中找数字"时出现数字偏好,"数字串中找字母"(数字变成任务无关项)时偏好消失。缺口在于:第一个明确检验 NFA 的 fMRI 研究(Price 和 Ansari 2011)用的正是被动观看的注视变色检测范式,却在 vOT 全脑无数字偏好——这是范式不合适,还是单元分析不够敏感?被动观看本被视为测"自动刺激驱动加工"的理想范式,也被成功地用于揭示 vOT 的字母/词偏好区;问题可能出在"平均激活强度"这个变量本身。
研究思路
作者的总攻思路是:同一批被动观看数据、换一把更敏感的分析尺子。三份历史数据集(Price & Ansari 2011;Price & Ansari 未发表;Merkley 等 2019)共享完全相同的任务范式与刺激集,合计 88 人,正好构成"预注册式"的三重复现。核心逻辑是:即使区内的平均响应强度在数字、字母、新异字符之间无差别,其分布式响应模式的组织方式(表征几何,representational geometry)仍可能编码类别区分——多变量模式分析因此可能比单元分析更能捕捉任务无关字符的表征。
具体做法是以表征相似性分析(representational similarity analysis, RSA)为骨架:先从候选区("pITG-numerals",由 Yeo 等 2017 的 20 项研究元分析定义)提取每个字符激发的模式,构筑 36×36 神经相异矩阵(RDM),再与 8 个候选模型 RDM 比较——两个视觉形式模型(像素重叠、抽象形状距离)、四个类别模型(熟悉 vs 新异、字母数字 vs 新异、字母-数字-新异三分、数字 vs 其他)、一个字母敏感对照模型和一个亮度混淆模型。如果该区专门加工数字,"数字 vs 其他"模型应描述其几何;如果它只做视觉形状加工,形状模型应胜出。模型竞争之外,作者还做了两重保险:三个数据集的固定效应小型元分析(含贝叶斯汇总),以及区分"无效应的证据"与"证据的缺失"的贝叶斯分析——这让它能对负结果下"证据性"结论,而不只是"不显著"。
方法
任务为注视变色检测:被试注视黑底中央的白色"#",白"# "变红时按键,变白为其他字符(数字、字母、乱序数字、乱序字母)时不作反应;字符顺序随机或伪随机,红#目标每 run 呈现 6 或 8 次。三个数据集的被试:数据集 1 为 19 名右利手成人(6 女,均龄 22.2 岁);数据集 2 来自一项数学发展纵向队列,12 年级时入组 32 人(13 女,均龄 17.8 岁;因本分析不预设利手标准,3 名左利手和 1 名未知者也被纳入);数据集 3 为 37 名右利手成人(26 女,均龄 25.1 岁)。改为'数据集2另有7人因头动剔除'(并可在数据集3处补充:3名未事先申报的左利手未纳入、3人因无按键记录剔除)。刺激为四类各 9 个例证:数字 1–9、大写罗马字母(数据集 1、2 用 A/C/D/E/H/N/R/S/T;数据集 3 用 C/D/E/G/L/N/P/R/S)、乱序数字与乱序字母(把完整字形分割重组成统一但新异的曲线形状,Arial 40 号)。为排除低级视觉混淆,作者量化了亮度(Arial 为比例宽度字体,数字占横向空间比字母小,平均亮度更低)与周边复杂度(perimetric complexity,内外周长平方除以墨迹面积;数字与字母无实质差异);数据只取三个数据集共有的 500 ms 完整字符条件。数据剔除统一规则:run 内任务准确率低于 50%、误按超过目标次数、run 位移超过 3 mm 和/或逐体位移超过 1 mm。数据集间差异照录:run 数为 2/1/4,每字符重复 2 或 4 次,试次间隔(ITI)数据集 1、2 为 4–8 s、数据集 3 为 1–3 s——后文这些变量被用来解释结果差异。
影像预处理用 BrainVoyager 20.4 统一流程(时间层校正、头动校正、高通滤波、boundary-based 配准、Talairach 归一化、3 mm 重采样,不做空间平滑)。每名被试所有 run 合并建一个 GLM:每个例证一个预测因子(数字/字母/乱序数字/乱序字母共 36 个,跨 run 跨重复在"例证水平"建模以稳定估计),另加目标、运动参数与常数;改为'双伽马(two-gamma)血流动力学响应函数'。ROI 取 Yeo 等 2017 元分析中的右 ITG 簇(55 个 3 mm 体素)及左半球同源区;为完整性也分析了双侧顶叶与右额叶候选区(结果稿中主要报告 ITG)。RSA 步骤:每 ROI 内以"例证 vs 基线"的 t 值图作为激活模式(t 值顾及体素噪声、缓冲数据集间 tSNR 差异),减去跨例证平均模式后,以相关距离 1–Pearson r 求得每被试的 36×36 神经 RDM。神经 RDM 与各模型 RDM 用 Kendall's τa 秩相关,跨被试做单尾 Wilcoxon 符号秩检验;每个被试的 τa 由 Kendall's τ 转 Pearson r 再 Fisher-z 变换后做固定效应小型元分析(逆方差加权),并配贝叶斯汇总(Cauchy 先验宽度 0.707,敏感性分析测宽先验 1 与超宽 1.414;判定标准 BF>3 支持备择、<1/3 支持零假设)。有类别模型胜出时,再用半偏相关(控制视觉形式与亮度模型)检验其"独占"相似度;同时用 MDS 与 k-medoids 聚类可视化/检验表征几何。噪声天花板用 Nili 等 2014 的方法估计被试间变异上限。
主要结果
-
左 ITG 同源区:所有模型都没戏,且是"证据性的没戏"(图 4a,表 1)。元分析层面,神经 RDM 与全部 8 个模型 RDM 均无相似性证据,且改为'全部8个模型的BF+0均低于1/3(0.09–0.33)';r区间写为'-.001–.004'或'绝对值均<.004'。唯一例外是数据集 1 中形状距离模型的一丝弱证据(τa=.0078, p=.044, BF+0=1.97),不足以通过任何校正。
-
标题改为'抽象形状模型确凿出局',或补一句'像素重叠模型证据不确定(BF+0=1.56),不能下零结论'(图 4b,表 1)。元分析层面,形状距离模型被确凿否定(BF+0=0.26),而三个区分数字与字母的类别模型均获正向收敛证据:字母数字 vs 新异(r=.0140, 95% CI [.0050,.0229], p=.002, BF+0=11.52)、字母-数字-新异三分(r=.0140, [.0066,.0214], p=.0002, BF+0=51.22)、数字 vs 其他(r=.0084, [.0026,.0141], p=.005, BF+0=13.64;超宽先验下 BF 仍达 7.83;Fail-safe N 估计需 8 项零效应研究才能拉垮该效应;数据集 1 与 3 中 FDR 校正后仍 p<.05)。熟悉 vs 新异模型虽 p=.015 但先验敏感性检验不稳健(宽先验下 BF 降至 3 以下),改为'三个数字区分模型的贝叶斯因子平均至少为熟悉vs新异模型的3倍(BF 11.52/51.22/13.64 vs 3.30)'。
-
"数字 vs 其他"压倒"字母 vs 其他":是数字敏感而非泛类别编码。元分析中数字 vs 其他(BF+0=13.64)描述神经 RDM 的可能性约为字母 vs 其他对照模型(BF+0=1.27)的 10 倍——新异字符更贴近字母、而非贴近数字。把 RDM 限制在只有数字与字母的 18×18 后,"数字 vs 字母"模型仍获相对稳健的元分析证据,排除了新异字符过表征驱动主结果的解释。
-
数据集内部:确凿(1、3)与不确定(2)并存,与试次量和 ITI 的差异自洽。数据集 1:三个数字区分模型均有证据(Alphanumeric v. Novel τa=.0096, p=.016, BF=3.36;Alphabet v. Numbers v. Novel τa=.0100, p=.005, BF=8.37;Numbers v. Others τa=.0098, p=.033, BF=4.34),且控制视觉形式与亮度模型后仍全部成立(τa=.0121/.0143/.0145)。数据集 3:证据只集中在 Numbers v. Others(τa=.0083, p=.026, BF+0=4.07;半偏控制后 τb=.0126, p=.021, BF+0=4.97)。数据集 2:所有模型既无正向证据也无确凿零证据(BF+0>1/3),属不确定;该集每例证仅 2 次重复(对照 4 与 8 次)与较短采集时间可部分解释,但作者清点后认为试次量与 tSNR 都不足以完全解释,提示被试年龄更小、数字加工经验更少也是候选因素。
-
特异性与数据驱动证据:效应锁定右 pITG,聚类弱再现(图 5)。左 ITG 同源区、全部候选顶叶/额叶区域中,只有右顶叶小叶也显示数字 vs 其他的元分析相似性(与 pITG-numerals 偏向顶叶连接的假说一致);右 pITG 的结果无法用跨区域共噪声或内在连接解释。MDS 展示的组平均表征几何直观可见,数字-字母-新异的三分结构在模型驱动的证据之外,k-medoids 聚类在数据集 1 和 3 中也弱地再现出一个"数字略占优"的簇。
图注解读
图 1 · 刺激集与注视变色检测任务示意
原文图注:Fig. 1. Stimulus sets and a schematic of the fixation color change detection task. The current study analyzed only the trials with these sets of stimuli that were only presented for 500 ms. ITI: Inter-stimulus interval. Letters Set 1 was used in Datasets 1 and 2. Letters Set 2 was used in Dataset 3.
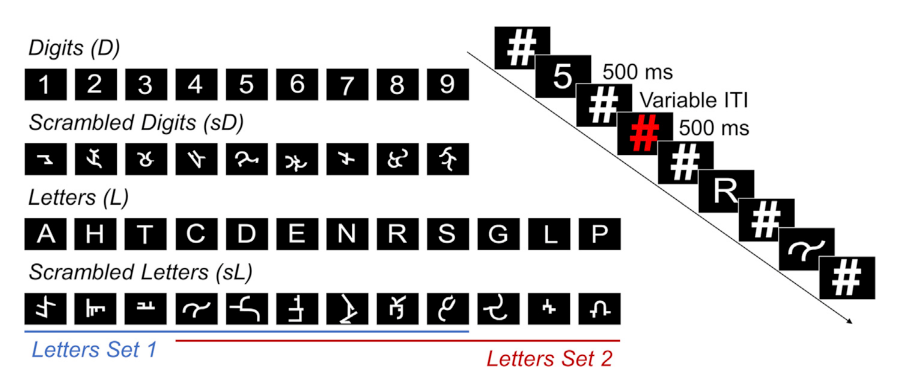
读法:左侧列出四类各 9 个字符(数字、字母、乱序数字、乱序字母),右侧示意单个 trial 的时间线:白"#"居中注视点,命中时变红需按键,白"# "变成白字符则无需反应,ITI 为试次间隔。注意图注的三点限定:只用 500 ms 呈现时长的 trial;字母集 1 用于数据集 1、2,字母集 2 用于数据集 3。这张图是理解"被动"二字的关键——字符识别与分类完全不被任务要求,是后文"自动加工偏置"论证的行为前提。
图 2 · ROI 与 RSA 分析框架概览
原文图注:Fig. 2. Regions of interest (ROIs), and neural and candidate representational dissimilarity models (RDMs). (a) Numeral-preferring ROIs from the meta-analysis by Yeo et al (2017), and an example neural RDM (using correlational distance) constructed from the activation patterns evoked by 9 Digits (D), 9 Scrambled Digits (sD), 9 Letters (L), and 9 Scrambled Letters (sL) within the right ITG. IPL: inferior parietal lobule. IPS: intraparietal sulcus. SPL: superior parietal lobule. PMC: premotor cortex. IFG: inferior frontal gyrus. ITG: inferior temporal gyrus. (b) Candidate RDMs (using Letters Set 1 from Datasets 1 and 2; see Inline Supplementary Fig. S4 for Letters Set 2 from Dataset 3). All models presented are rescaled to [0, 1] for comparative visualization. (c) Multidimensional scaling plot of the correlational distance among the candidate models using Letters Set 1……
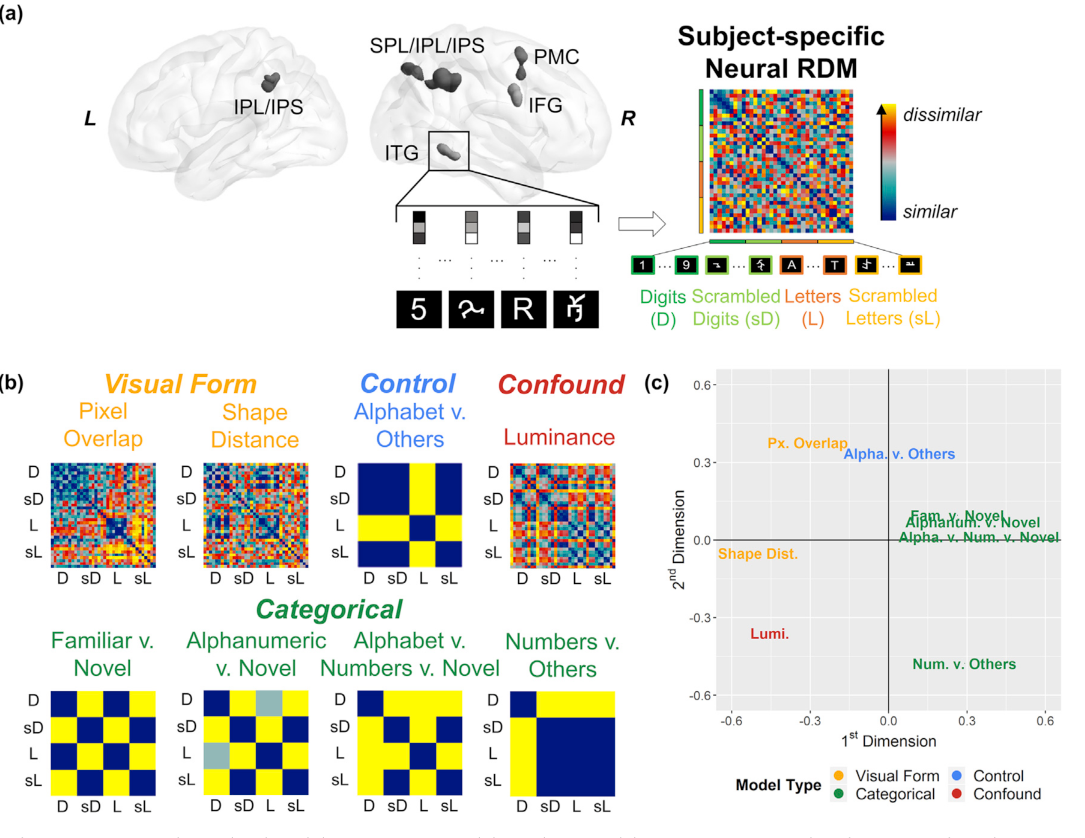
读法:面板 a 先呈现 Yeo 等 2017 元分析在右 ITG、双侧顶叶、右额叶的数字偏好 ROI 示意,再用右 ITG 为例展示一个由 36 个字符的激活模式构建的神经 RDM(行列均为 D/sD/L/sL 九例证,颜色深浅为相关距离);面板 b 并排八个候选模型 RDM(统一缩放到 [0,1]),可视比较各模型的类别结构;面板 c 把八个模型两两之差做 MDS,直观显示哪些模型相关、哪些彼此独立——类别三模型互相挤在一角,形状模型与它们拉开距离。这张图帮读者看清 RSA 的对称设计逻辑:同类数据结构(RDM)之间直接比相关。
图 3 · 四个类别模型的编码示意
原文图注:Fig. 3 illustrates these four categorical models. The Familiar v. Novel model and Alphanumeric v. Novel model are based on the hypothesis that a region responds to all familiar characters (digits and letters) in a manner that is different from how it responds to novel characters (scrambled digits and letters). In the Familiar v. Novel model, digits and letters are indistinguishable. In the Alphanumeric v. Novel model, digits and letters are somewhat distinguishable, but are still more similar to one another than to novel characters (here we coded 0 for high similarity, 2 for high dissimilarity, and 1 for in-between). The Alphabet v. Numbers v. Novel model is based on the hypothesis that digits, letters, and novel characters are equally distinguishable……
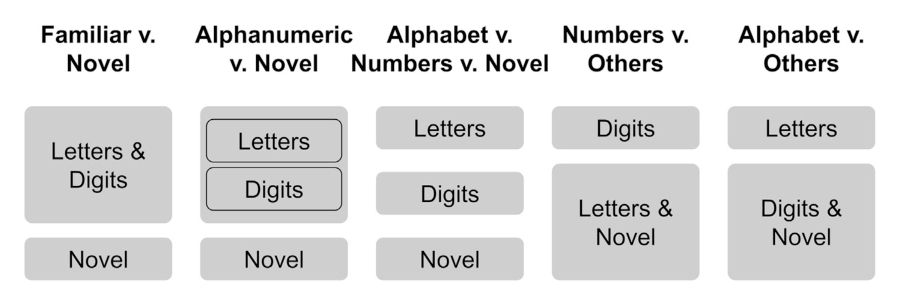
读法:这张示意图把四种类别假设并置为色块结构:熟悉 vs 新异(数字字母不可分,合为一类对立两类乱序);字母数字 vs 新异(三类之间略有距离但字母数字仍更像彼此,故有 0/1/2 三档编码);字母-数字-新异三分(三类等距可分);以及数字 vs 其他(数字自成一簇,字母与乱序字符不分彼此)。最后一行是关键读点——只有"数字 vs 其他"押注"区内对数字有过度的敏感性",让它成为数字特异性的最强判据,也正是后文在右 ITG 稳健胜出的那个模型。
图 4 · 左右 ITG 神经-模型相似度的元分析汇总
原文图注:Fig. 4. Similarity between neural and model representational dissimilarity matrices (RDMs) in the candidate numeral-preferring regions in (a) left and (b) right inferior temporal gyrus (ITG). Blue bars indicate the estimated noise ceiling. Group means and standard errors of the similarity are indicated by the bar plots with error bars. Individual data points are shown as grey dots. Evidence of similarity is indicated by black asterisk: p < .05, p < .01, **p < .001, one-sided, uncorrected. Blue asterisks indicated results that remained significant with FDR correction. BF+0 = Bayes Factor [rz > 0 vs. rz = 0]. Lines in meta-analytic plots indicate the 95% confidence interval around the overall weighted r.
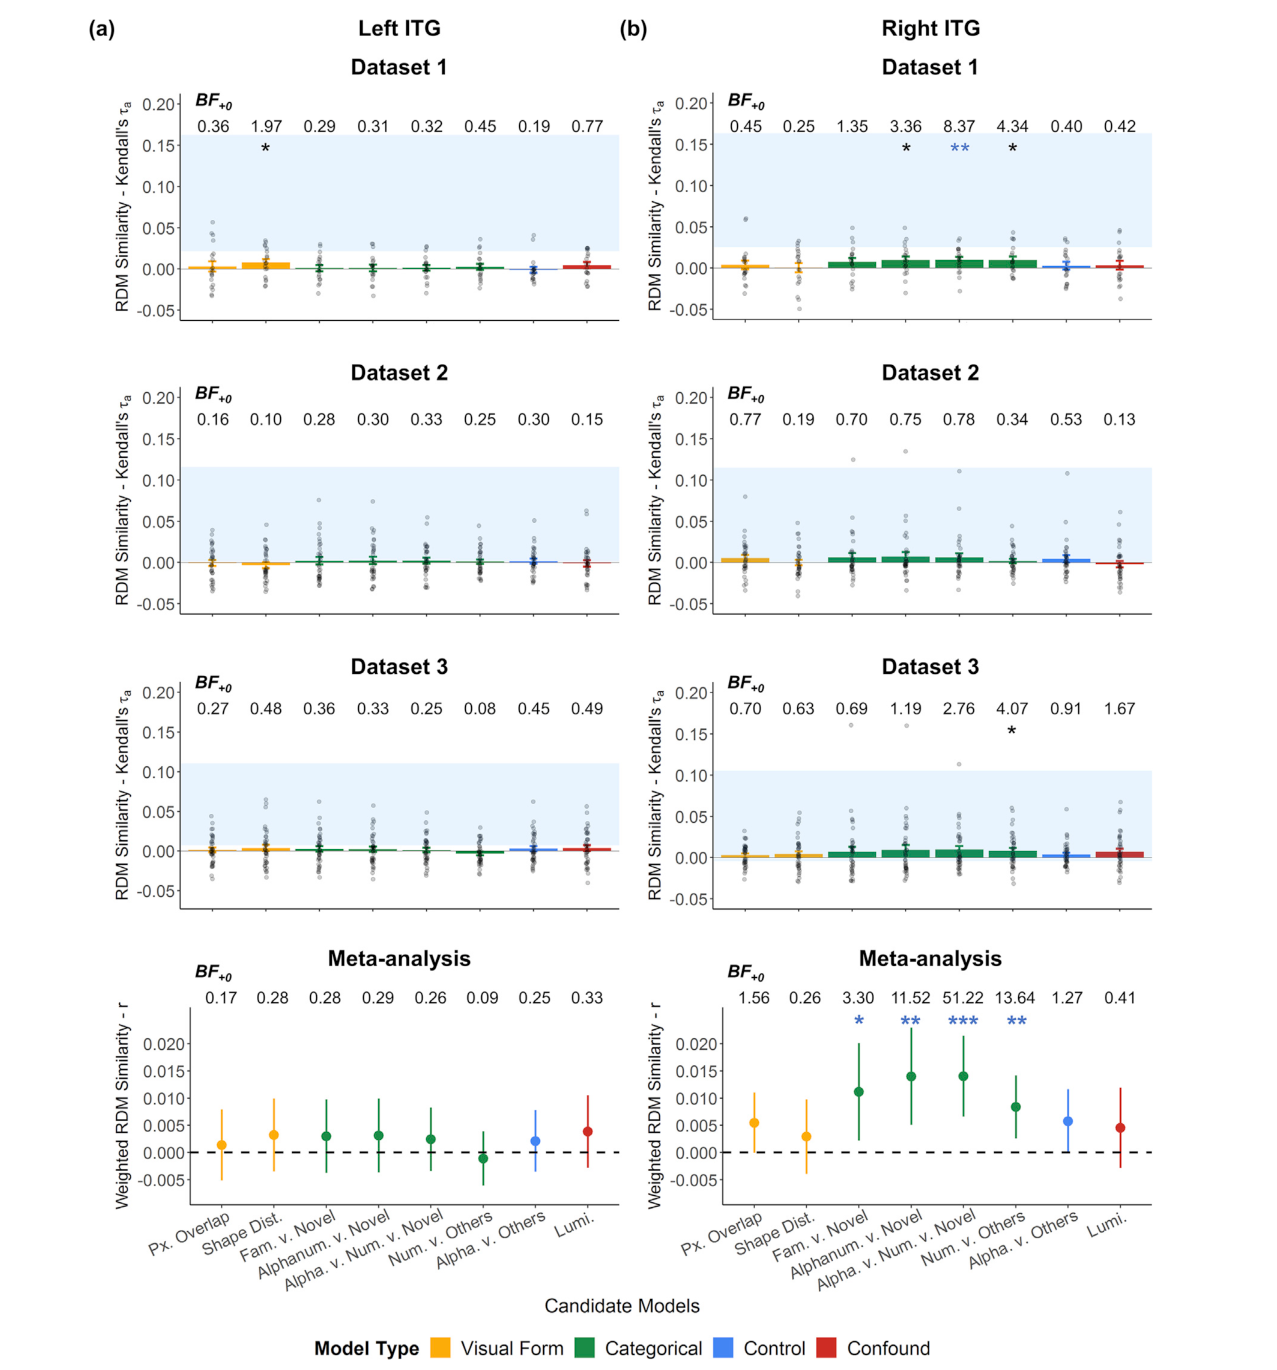
读法:网格布局,每个小格对应一个模型,纵轴为神经 RDM 与模型 RDM 的相似度(τa 换算的 r),柱状为三个数据集各自的均值±标准误,灰点为个体数据,右上或上方附 BF+0;中间带 95% 置信区的横线是元分析加权总体效应;蓝色柱/星号是 FDR 校正后仍显著者;蓝色横柱是估计的噪声天花板。看图重点:在 b(右 ITG),三个数字区分模型的效应线离开零点、星号密集,而两个形状模型与字母对照模型的效应线贴在零点;在 a(左 ITG)所有模型的效应线都贴在零点附近且 BF 倒向零假设。玄武岩级的细节是效应量本身极小(τa<0.02),所以同时要看右上图判读个体变异。
图 5 · 右 ITG 群体平均 RDM 与二维表征几何
原文图注:Fig. 5 illustrates the group-averaged dissimilarity matrix and representational geometry of the 36 characters in this region for each dataset. To further assess whether the three-way distinction (numerals, letters, and novel characters) observed using a model-driven approach could also be observed using a data-driven approach, we performed a k-mediods clustering analysis (Kaufman and Rousseeuw, 1990) for each dataset. Overall, evidence for a three-cluster structure was not strong in all datasets, but consistent with our findings above, there exists a cluster that showed a slight dominance of numeral representations in both Datasets 1 and 3……
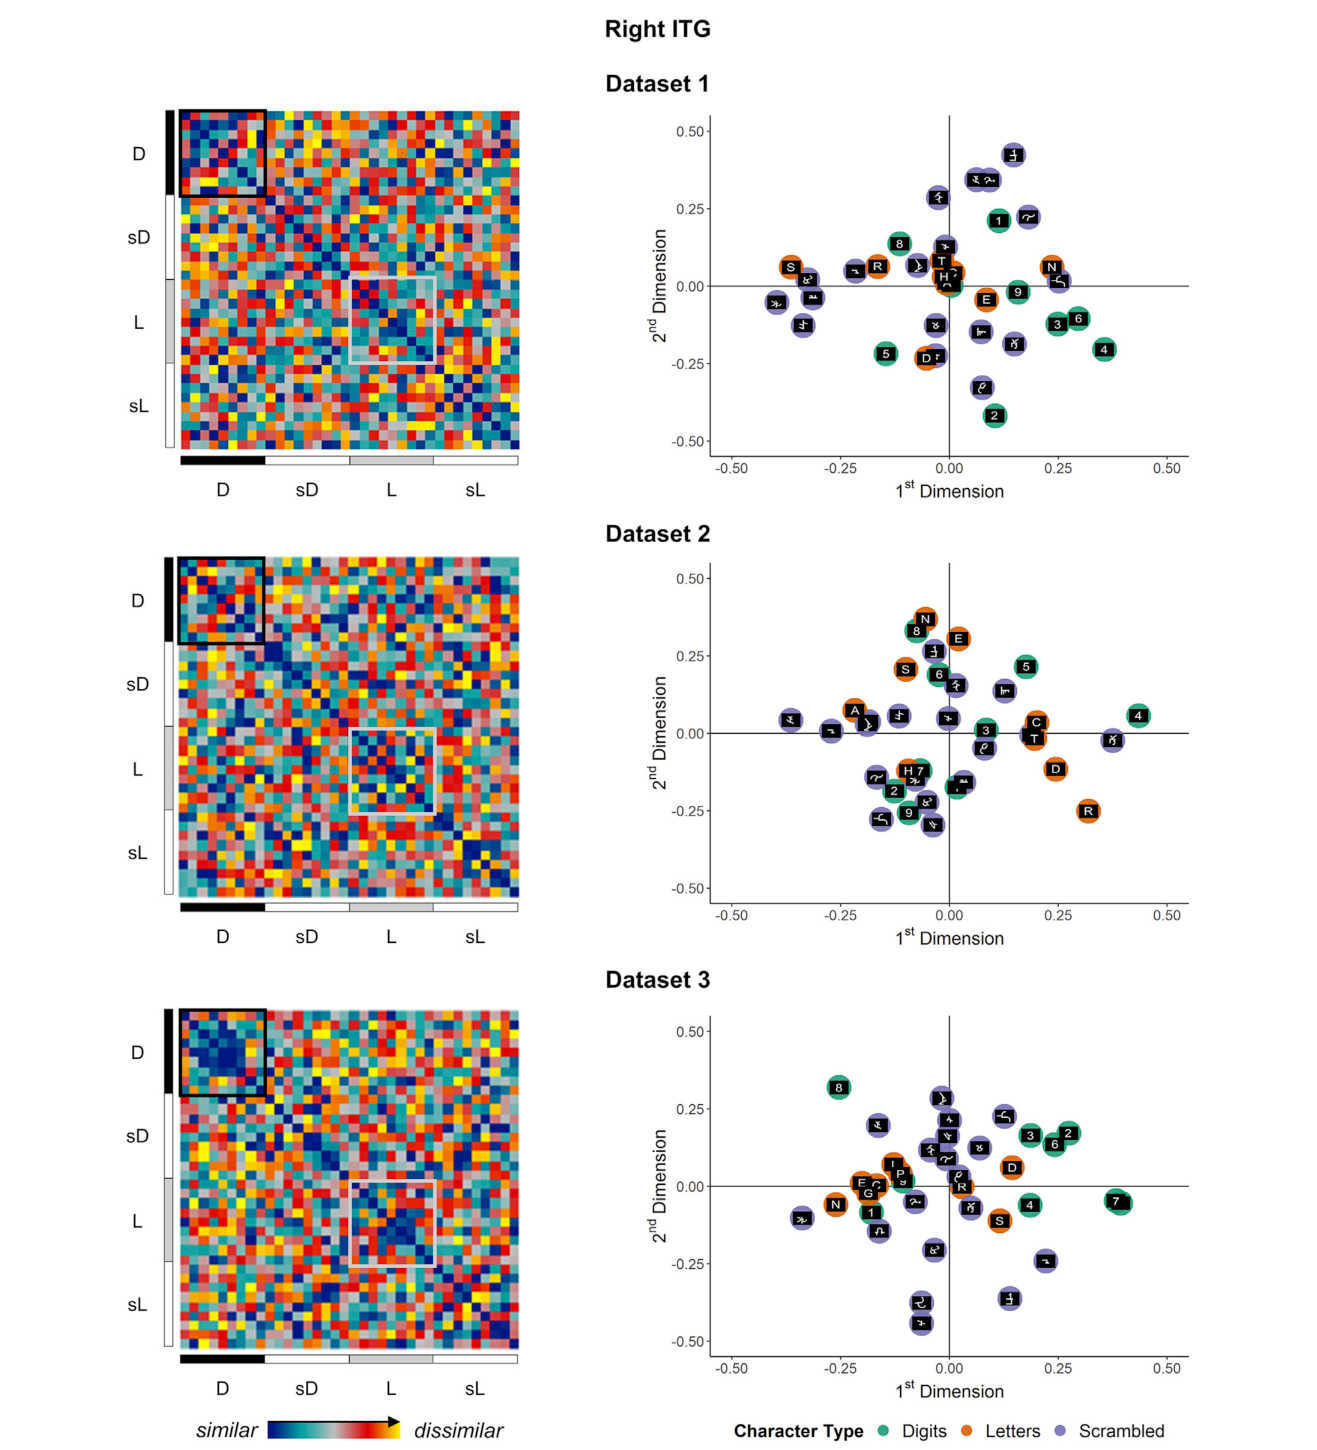
读法:按数据集分列:左半是群体平均的 36×36 相异矩阵热图(行列同为 D/sD/L/sL),右侧是 MDS 投影到二维的表征几何——同一类别内的字符是否抱团、跨类别的距离有多大,一眼可判。数据集 1、3 的几何里数字区域相对聚拢、扰乱字符与字母相对靠外,这也被 k-medoids 里的数字主导簇弱化验证;数据集 2 的几何较弥散。这张图把模型驱动的结论解构成可以直接观察的图案,作用是让"数字 vs 其他"不只是一个统计数字。
讨论
作者的论证分正面与反面两翼。正面是:右 pITG 在字符完全任务无关时,其分布式响应模式就能区分数字与字母——这与同一批数据的单元分析零结果直接矛盾,说明多变量方法对任务无关刺激的表征更具敏感性,也解除了"被动观看范式不适合研究 NFA"的疑虑;该区更亲近"数字 vs 其他"几何而 10 倍地远离"字母 vs 其他",暗示数字特异性。反面是:对抽象形状距离模型的确凿否定构成"反对形状加工作为右 pITG-numerals 首要功能的第一份直接证据"——因为既往的形状证据都被"类别内字形相似、跨类别的概念混淆"所污染,唯有 RSA 能同时考察类内与类间形状相似度。由此作者提出该区编码的是抽象的数字身份/类别,并援引既有发现(罗马数字声音景观、骰子图案、手指表征、数学公式都能唤起该区)倡议:该区不应再叫"数字塑形区",应命名为"下颞数字区"(Inferior Temporal Numeral Area)。机制解释求助 Gauthier 2000 的"过程地图"模型:读写与数算经验把字母和数字与习惯性的加工目标(是否有数字相关性)配对,在 vOT 中分化出对潜在数字相关刺激有预备性偏置的通路;这与视词形区的交互账户(Price 和 Devlin 2011 的预测编码框架)同构,也符合该区与顶叶数量加工区偏向连接(biased connectivity)的证据——右顶叶是唯一同样表现出数字敏感的其他候选区。左同源区无此效应,与 Pollack 和 Price 2019(左 pITG 参与、但无被动数字偏好)及 ERP 上字母左偏/数字右偏的发育证据一致,作者列举了数学家研究、计算能力相关性等多条线索解释半球不对称,但坦承左半球数字偏好区的确切角色仍不清楚。局限写得很实:三份原始数据不是为逐字符 MVPA 设计的,每例证重复次数少、ITI 短会削弱模式估计的可靠性;效应量极小(总体加权 r=.008,噪声天花板 τa<0.17),被试间变异大(任务无关字符被加工到什么程度本就因人而异);数据集 1 天花板明显高于另两集提示 ITI 比重复次数更利于稳定表征;元分析 ROI 与个体化 ROI 的取舍未定;语义模型(如 Lyons 和 Beilock 2018)未来值得纳入。
一句话总结
这篇文章的精妙之处是"没造新数据却赢了官司":它把三份曾被单元分析判为"NFA 不存在"的被动观看数据重新过一遍 RSA,发现数字-字母的类别区分一直藏在分布式模式里,只是会被平均激活这个粗颗粒变量抹平。我的理解是,真正站住的结论有两个:右 pITG-numerals 在无任务压力下仍特异地偏爱数字这一符号目的,以及它对抽象形状的不敏感——"下颞数字区"这个名字比"数字塑形区"更贴切;但因为所有效应量都在 τa<0.02 的量级、三份数据集只有两份确凿,我不会把它读成"数字区已被 fMRI 复现",而是"fMRI 需要这把更细的尺子才能量到它"。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: 直接论证了该区编码的不是'字形'而是'符号的数字相关性' -> 评注: 轻度过度推论:否定形状编码是FACT(对Shape Distance有确凿零证据),'编码数字相关性'是作者的INTERPRETATION;好在讨论与一句话总结部分归因正确、对冲充分(明言效应量极小、仅2/3数据集确凿),全文整体未把相关当因果
- 补充要点: 数据集2的右利手限定敏感性分析(N=28)结果与主分析定性一致(Inline Suppl. Fig. S5/Table S6)——这是对利手混入质疑的重要稳健性对照,解读未提及
- 补充要点: 补充分析中两个附加模型(较弱数字敏感模型、字母敏感模型)的元分析证据被认为由底层的数字-字母-新异三分结构驱动(Inline Suppl. Fig. S6-S7),对理解'数字vs其他'效应的性质有帮助
- 补充要点: 数据集1含50ms条件、数据集3含镜像字符条件(本分析均未纳入)——解读只说了'只取500ms条件',未交代各数据集原有的额外条件,读者难以理解三数据集run结构差异的来源