IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
076| 原始基线:V0_ZCODE_BASELINE| 语义审核:needs_revision| 图表审核:pass
Bottom-up and top-down computations in word- and face-selective cortex
Kay · eLife · 2017 · Zotero itemID=871
这篇文章用一套精心控制的刺激和三种认知任务,把腹侧颞叶皮层(ventral temporal cortex, VTC)中词选择区与面孔选择区的响应拆解成"自下而上的模板匹配"与"自上而下的顶内沟缩放"两个可计算的成分,并给出一个能定量预测 fMRI 响应的整合模型。它值得读,是因为它把"类别选择区如何响应刺激"这个长期停留在描述层面的问题,第一次变成了一条从图像计算、经顶叶反馈、到决策与反应时的完整计算链条。
研究背景
阅读文字与识别面孔被认为依赖 VTC 中的类别选择区——视觉词形区(visual word form area, VWFA)对词、梭状回面孔区(fusiform face area, FFA)对面孔有选择性响应。视觉系统建模的思路在早期视觉皮层已经相当成熟:简单图像计算可以刻画视网膜、丘脑和初级视皮层(V1)的发放,也能解释对比度检测、朝向辨别等低级知觉功能。但一旦进入高级知觉,这类模型就失效了:类别选择响应到底是怎么算出来的,当时并没有计算层面的解释。作者指出一个关键的概念缺口——我们能用自己的视觉系统给数据贴上"词"或"面孔"的标签,却说不清视觉系统当初是通过什么运算得到这些标签的;而且传统上认为 VWFA 响应对低级特征不变(Dehaene 和 Cohen 的文字识别理论),甚至有人主张 VWFA 是"超模态"语言区而非视觉区,低级特征对 FFA 的影响也只是零散报道。
另一条线是注意与任务效应。此前已知任务需求会增强视觉响应(如 Ress et al. 2000 的"努力感知"效应),但注意对对比度响应函数的经典模型——响应增益、对比度增益、加性平移——没有一个能直接解释随后会看到的测量。于是缺口有两层:一是缺少把刺激低级属性与类别选择统一起来的自下而上定量模型,二是不知道任务诱发的调制以何种形式(加性?乘性?仅限偏好类别?)作用于哪种表征、又来自哪个脑区。
研究思路
作者的总体策略是"先分离、再建模、后整合"。第一步用注视任务(fixation task)把被试的注意牢牢锁在中央小点上,使刺激与当前任务无关,把此时 VTC 的响应近似当作纯自下而上的刺激驱动成分;同时用分类任务(categorization)和单回溯任务(one-back)在物理刺激完全相同的条件下引入认知需求,两者之差即自上而下调制。第二步,分别对两个成分建立可计算的前向模型:自下而上用"模板模型"(Template model),自上而下先做全皮层连通性分析定位来源脑区,再按其作用形式建"IPS 缩放模型"。第三步,因为"IPS 给 VTC 提供缩放"只是把解释负担推给了 IPS,作者又用简化的漂移扩散模型(drift diffusion model)回答"IPS 为什么对某些刺激更活跃",把反应时和 IPS 活动连起来。整条逻辑链的关键设计是同一刺激序列在三种任务下重复呈现,保证任务间差异只能归因于认知状态而非刺激;模型评估统一采用留一刺激交叉验证(leave-one-stimulus-out cross-validation),使自由参数多寡不同的模型可以公平比较。
方法
共 11 名人类被试,2 名因无法定位 VWFA 或信噪比过低被排除,有效 9 名(25–32 岁,6 男 3 女,右利手英语母语)。主实验在 3T 扫描仪上采集枕颞覆盖的功能像,3 名被试加做全脑覆盖用于连通性分析,8 名采集弥散 MRI。刺激共 22 类,均为约 2°×2° 的中央呈现灰度小图:面孔与五字母词(各 10 张),并各配 0%/25%/50%/75% 四档相位一致性(phase coherence,即把图像相位谱与随机相位谱按比例混合,0% 就是纯噪声);面孔与噪声在 4%/6%/10%、词在 3%/5%/8% 三档对比度下呈现;另有全对比度的多边形、棋盘格和房子。每个 4 秒试次按 800 ms 呈、200 ms 熄的节律连续闪现同一刺激类型的 4 张图。三种任务为:注视任务(中央 0.12° 小点变红时按键)、分类任务(报告"词/面孔/其他")、单回溯任务(检测连续重复的图像)。每个刺激×任务组合共出现 12 次,刺激序列物理上完全相同,仅任务轮换。
分析上用 GLMdenoise 估计各条件的 BOLD beta 值,ROI 通过视网膜定位(pRF 技术)与功能 localizer 确定:VWFA 取左侧枕颞沟附近词选择性皮层,FFA 取梭状回面孔选择性皮层(含 pFus 与 mFus 两个亚区),IPS 用后段顶内沟的解剖掩膜(对照图谱约覆盖 IPS-0/1/2)。连通性分析的要点是先从分类与单回溯任务响应中减去注视任务响应,得到 46 个"自上而下残差",再把残差与全皮层各处的任务响应求相关。弥散数据用约束球面反卷积加概率追踪定位纵枕束(vertical occipital fasciculus, VOF),量化其终止端与 VWFA、FFA、IPS 热点的距离。三个模型组件各自独立拟合与交叉验证,准确性以相对 0% BOLD 变化的解释方差 R² 报告,并用 bootstrap 重采样被试得到置信区间、用蒙特卡洛模拟估计噪声天花板。
主要结果
-
VTC 响应同时依赖刺激属性与认知任务(图 1)。在注视任务下,VWFA 对词的响应在 100% 对比度时是 3% 对比度时的 2.4 倍,FFA 同样受对比度和相位一致性调制——这与"VWFA 对低级特征不变"的传统预期相悖。而任务效应可以超过刺激效应:单回溯任务下 3% 对比度词诱发的 VWFA 响应超过注视任务下 100% 对比度词的响应,且注视任务下单调递增的对比度响应函数在单回溯任务下反号变为单调递减。
-
模板模型定量解释自下而上响应(图 2)。模型分两级:先用类 V1 的 Gabor 滤波器组(8 朝向、2 相位、单一空间频率调谐 4 周/度、带宽 1 倍频程)做能量计算并除法归一化,再与类别模板(由 10 张 100% 对比度的词或面孔的 V1 表征质心构成)做归一化点积,仅 3 个自由参数。留一刺激交叉验证下,它能预测 VWFA 和 FFA 对全部 22 类刺激的响应,优于仅按感知类别赋值的 Category 模型,也优于省略任一阶段、或换用无选择/混合/随机模板的各个对照版本;它在非偏好类别上的准确预测说明"非偏好响应"同样是有明确计算的信号。在包含 92 张外部物体图像的补充数据集上,固定模板泛化不佳,但用数据驱动方式估计模板后达到合理精度(图 2—figure supplement 1)。
-
自上而下调制表现为刺激特异性的缩放而非选择性增强(图 3)。把 VWFA、FFA(及 hV4)响应放到多维神经空间里,词与面孔的响应从原点各自伸出一条"臂";分类与单回溯任务把每个刺激的表征沿臂向外推移——是乘性缩放,且缩放幅度随刺激而异,低对比度刺激缩放最大。改为“缩放使群体平均响应在所定义的表征空间中远离决策边界,作者据此解释为可能改善类别读出信噪比”。(图 3d)。非偏好类别(如 VWFA 中的面孔)的响应也被缩放,说明"仅增强本区偏好刺激"的模块化方案不成立。
-
自上而下信号的源头定位在 IPS(图 4)。若不做减法直接求相关,VTC 响应与整个枕叶皮层广泛相关(图 4a);减去自下而上成分后,相关收缩为 IPS-0/1 的一个热点(图 4b)。弥散成像显示 VOF 在全部 8 名采了弥散数据的被试中把 VWFA 和 FFA 与该 IPS 热点相连:FFA 全部落在 VOF 腹侧终止端内,VWFA 7 名落在终止端内、1 名在其前 2.7 mm(在追踪误差范围内)。
-
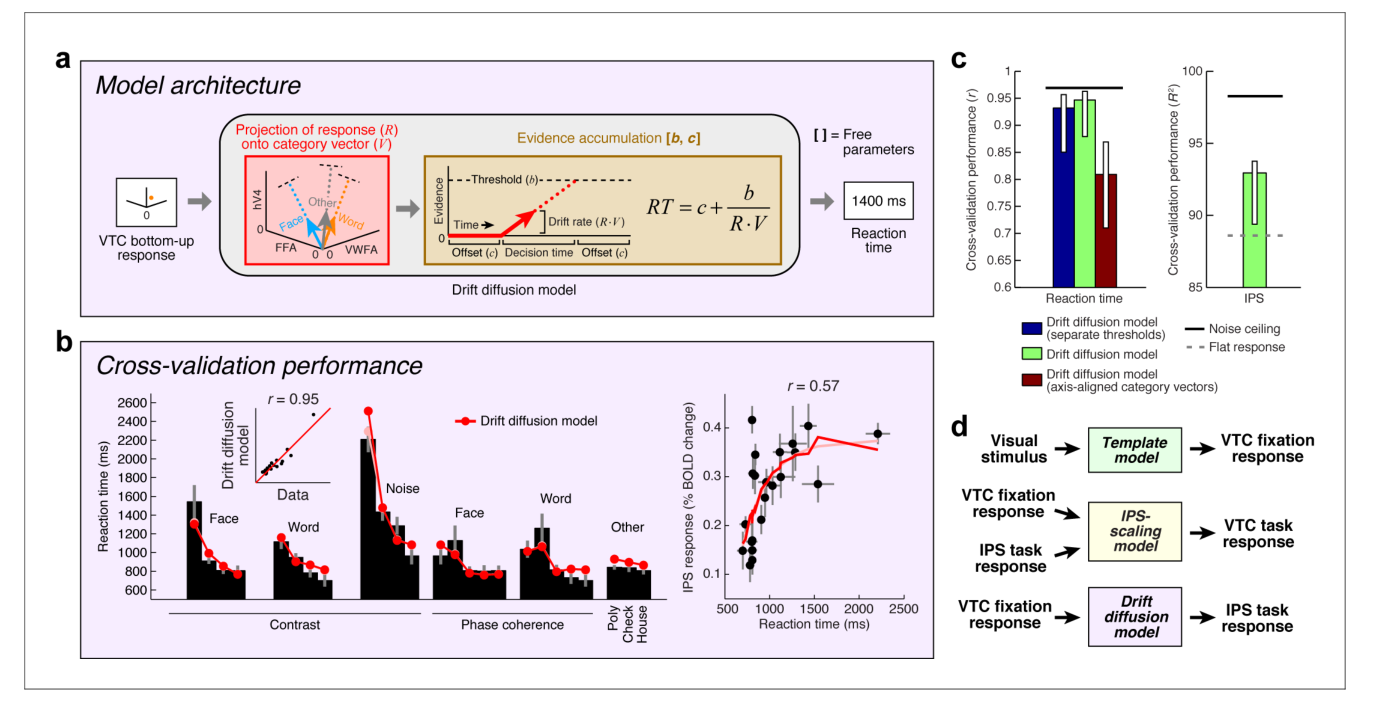
IPS 缩放模型与漂移扩散模型闭合整个回路(图 5、图 6)。IPS 缩放模型把注视任务下的 VTC 响应乘上"缩放后的 IPS 响应"(VTC_task = VTC_bottom × (a×IPS_task + b)),仅 2 个自由参数、一套参数同时预测分类与单回溯两个任务,交叉验证表现优于加性模型、任务特异的唯象缩放模型、仅增强偏好类别的模型以及 IPS 输入打乱的对照;当 IPS 活动接近零时缩放因子接近 1,语义自洽。漂移扩散模型则用 VTC 注视响应向类别向量投影作为漂移率(RT = c + b/(R·V)),高精度预测分类任务的反应时,再用单调函数从反应时预测 IPS 响应(图 6b);用单阈值不减性能,但把类别向量换成坐标轴对齐(即只允许本区贡献证据)则性能下降,支持"多个 VTC 区域共同提供证据"。图 6d 把三个组件串成总架构:VTC 编码→IPS 累积证据→IPS 反馈缩放 VTC。
图注解读
图 1 · VTC 响应同时受刺激属性与认知任务塑造
原文图注:Figure 1. VTC responses depend on both stimulus properties and cognitive task. (a) Stimuli. Stimuli included faces, words, and noise patterns presented at different contrasts and phase-coherence levels, as well as full-contrast polygons, checkerboards, and houses. (b) Trial design. Each trial consisted of four images drawn from the same stimulus type. (c) Tasks. On a given trial, subjects performed one of three tasks. (d) Evoked responses in VWFA (top) and FFA (bottom) for different stimuli and tasks. Color of x-axis label indicates the perceived stimulus category as reported by the subjects. Error bars indicate bootstrapped 68% CIs.
这张图是全篇的现象学起点。(a)–(c) 交代刺激集(面孔/词/噪声,含对比度与相位一致性两档操作,外加多边形、棋盘格、房子)、试次结构(4 秒 4 图)和三种任务。(d) 是核心:上排 VWFA、下排 FFA,每个刺激类型给出三条曲线,红色为注视任务(自下而上基线)、绿色为分类任务、蓝色为单回溯任务,x 轴标签颜色表示被试主观报告的知觉类别,误差棒为 bootstrap 68% 置信区间。读图要点:红曲线随对比度单调上升(低级特征敏感);绿、蓝曲线整体抬高且对低对比度刺激抬得更高,蓝色在 VWFA 上甚至出现随对比度下降的反常形状。它支撑"主要结果"第 1 条,也为后面"缩放模型能解释 CRF 反号"埋下伏笔。
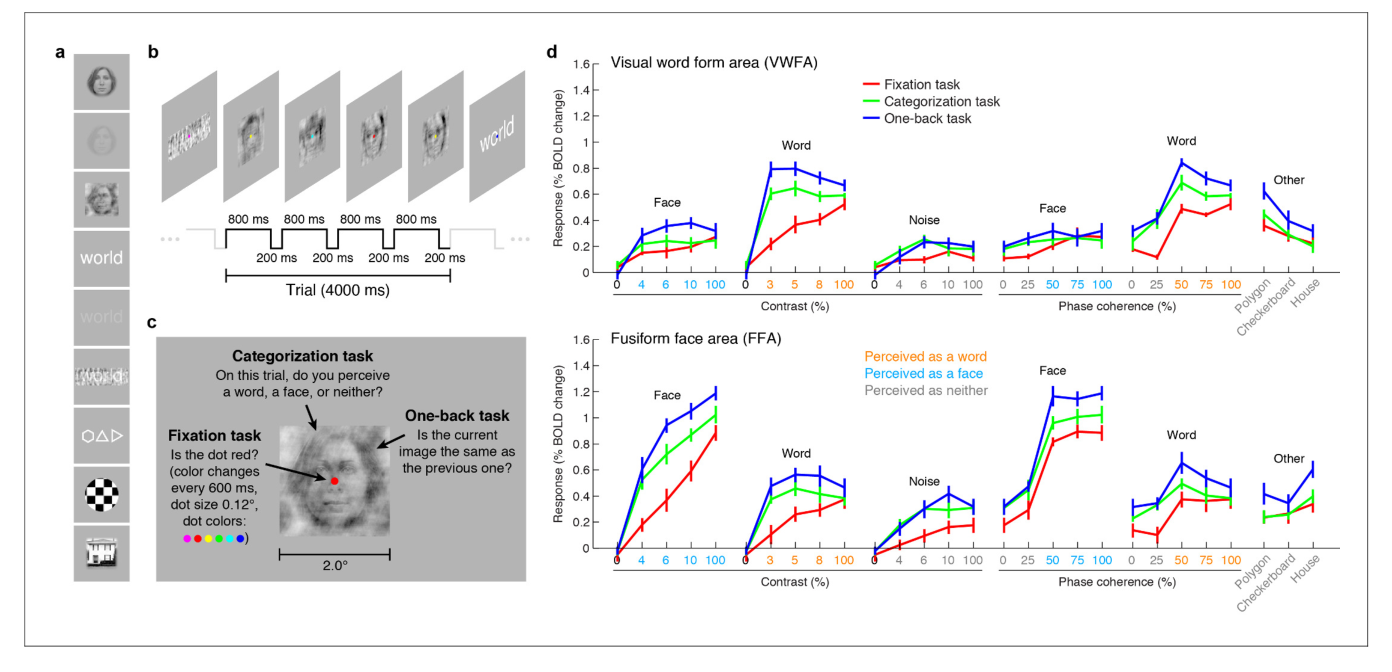
图 2 · 模板模型对自下而上响应的交叉验证
原文图注:Figure 2. Model of bottom-up computations in VTC. (a) Model architecture. The predicted response of the Template model is given by a series of image computations (see Materials and methods). (b) Cross-validation performance. Black bars indicate bottom-up stimulus-driven responses measured during the fixation task, dark lines and dark dots indicate model predictions (leave-one-stimulus-out cross-validation), and light lines and light dots indicate model fits (no cross-validation). Scatter plots in the inset compare model predictions against the data. The Template model is compared to the Category model which simply predicts a fixed response level for stimuli from the preferred stimulus category and a different response level for all other stimuli (the slight decrease in response as a functi
(a) 图示模型架构:图像先经类 V1 滤波器组(可用品红—青色 HSV 图像可视化中间表征),再与词模板或面孔模板做归一化点积。(b) 黑色柱为注视任务实测响应,深色线/点为留一刺激交叉验证预测,浅色为无交叉验证的拟合,内嵌散点图给出预测对实测的对角线关系;对照的 Category 模型只能给出偏好类别一个水平、其他刺激另一个水平。(d) 还做了滤波器空间频率调谐的扫描,最优调谐在 4 周/度。此图支撑"主要结果"第 2 条:仅 3 个自由参数的模板模型就能覆盖全部刺激类型的响应形态,包括对非偏好类别的响应。图注在"(the slight decrease in response as a functi"处截断,后半句涉及交叉验证导致 Category 模型预测轻微下降的解释,文中未详述其完整表述。
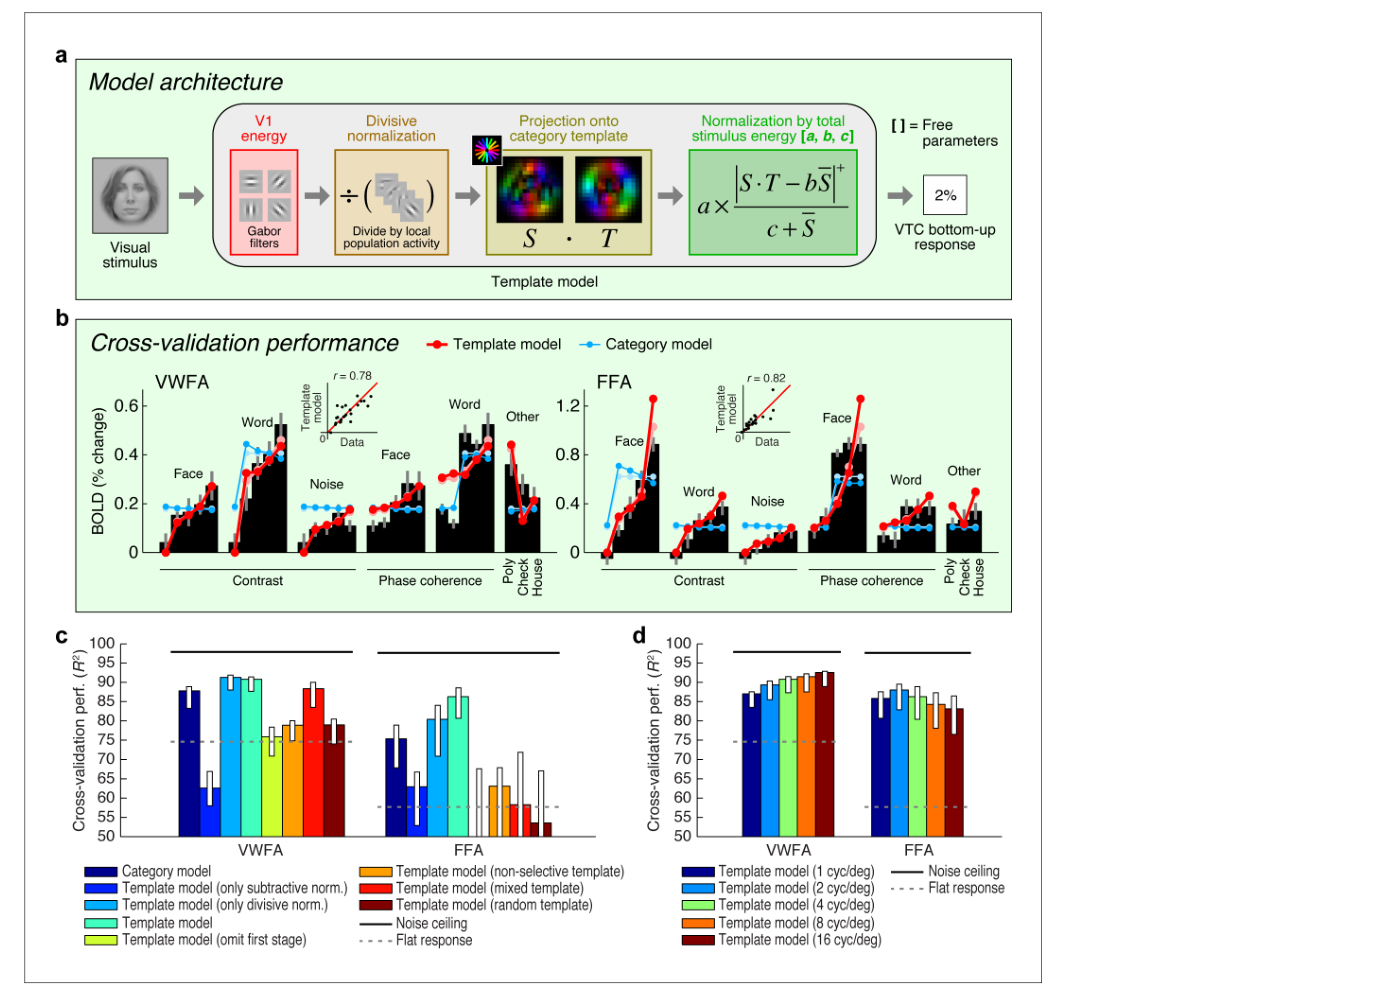
图 3 · 自上而下调制是刺激特异性的表征缩放
原文图注:Figure 3. Top-down stimulus-specific scaling of VTC representation. (a) Responses plotted in multi-dimensional neural space. Each dot indicates ROI (VWFA, FFA) responses to a stimulus. In each plot, the black line indicates a linear decision boundary separating words and faces (nearest-centroid classifier, angular distance). (b) Schematics of potential top-down mechanisms (these models are formally evaluated in Figure 5c; see Materials and methods section 'IPS-scaling model' for details). (c) Categorization and one-back tasks produce stimulus-specific scaling. Arrows indicate the change in representation compared to the fixation task. (d) Scaling improves readout. Each data point indicates the signed Euclidean distance between the word-face decision boundary (as determined from the one-bac
(a) 把每个刺激画成以各 ROI 响应为坐标的点,词与面孔的响应从原点伸出两条"臂",黑线为最近质心分类器给出的词—面孔线性决策边界。(b) 罗列四种候选自上而下机制示意:加性抬升、整体缩放、仅增强本区偏好类别(区域特异增强)、刺激特异性缩放。(c) 箭头从注视任务指向分类/单回溯任务下的位置,可见点是沿臂向外移动而非整体平移,且低对比度(黑点)移动比例最大。(d) 以带符号欧氏距离度量各刺激响应到决策边界的距离,连线连起同一刺激——任务缩放使响应远离边界,即可分辨度提高。此图支撑"主要结果"第 3 条,是"缩放而非增强"这一关键论断的直接证据。图注同样在句中截断。
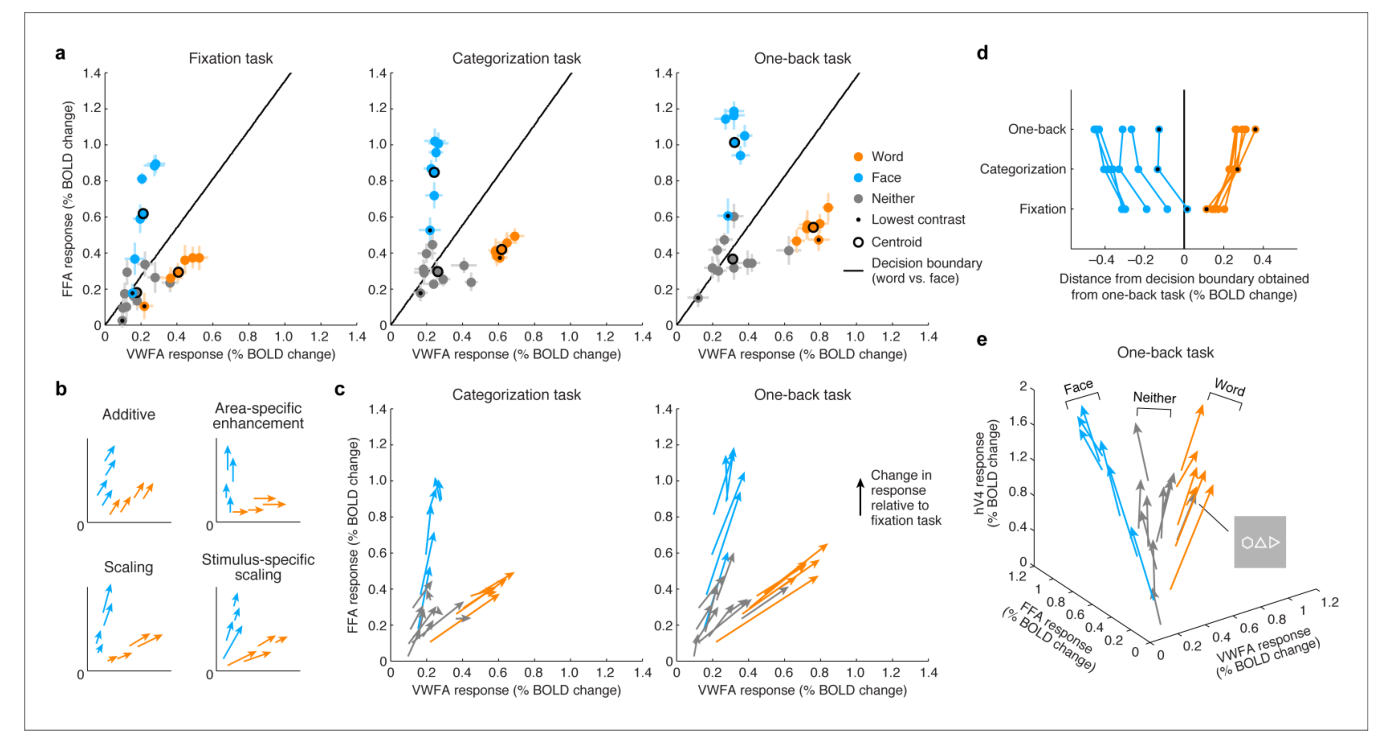
图 4 · IPS 是自上而下调制信号的源头
原文图注:Figure 4. IPS is the source of top-down modulation to VTC. (a) Correlation with raw VTC response. This map depicts the correlation between the VTC response observed during the categorization and one-back tasks with the response at each cortical location (inset shows an unsmoothed and unthresholded map). Positive correlations are broadly distributed across occipital cortex. Results are shown for subjects with whole-brain coverage (n = 3); results for other subjects with partial-brain coverage (n = 6) are shown in Figure 4—figure supplement 1. (b) Correlation with top-down component of VTC response. After removing bottom-up responses (fixation task), the correlation is spatially localized to a hotspot in IPS-0/1. (c) Tractography using diffusion MRI. We find that the vertical occipital fasciculus (Yeatman et al., 2014) connects VWFA and FFA to the IPS hotspot in each subject for which diffusion data were collected (n = 8) (rendering shows a representative subject).
(a) 与 (b) 是同一分析的一对对照:不减去注视任务响应时,VTC 响应与整个枕叶皮层广泛正相关(左下角 inset 为未平滑、未设阈值的原始图);减去之后,相关图上只剩 IPS-0/1 处一个热点。(c) 用弥散 MRI 纤维追踪渲染代表性被试,显示 VOF 连接 VWFA、FFA 与 IPS 热点,8 名有弥散数据的被试全部如此。读图时注意 (a)(b) 的对比本身就是论证——"源头"不是随便挑出来的相关,而是扣除自下而上成分后浮现的特异位置。此图支撑"主要结果"第 4 条,也为 IPS 缩放模型提供了解剖依据。
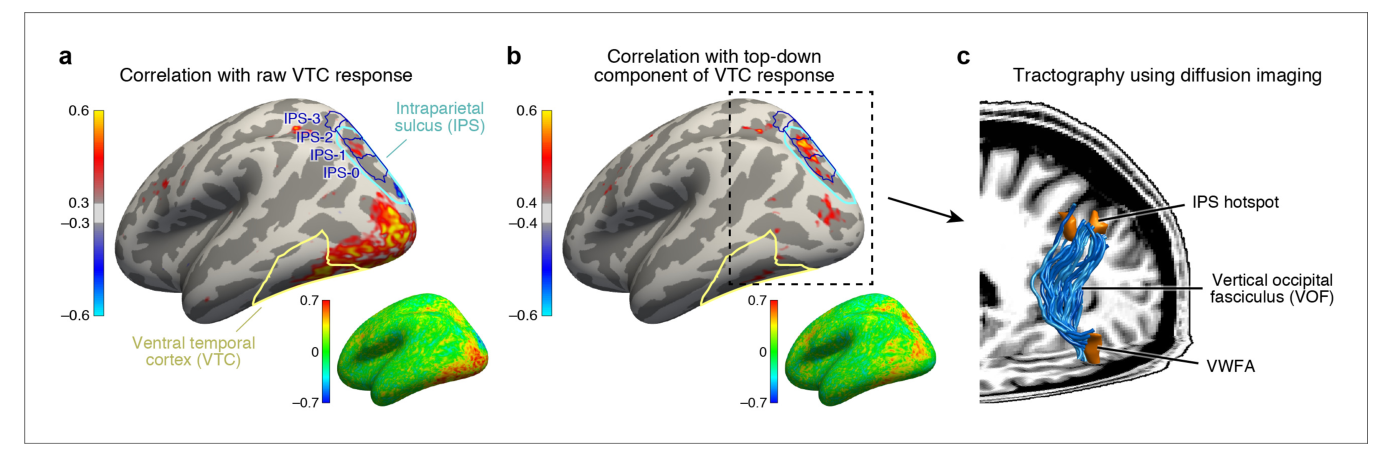
图 5 · IPS 缩放模型的定量预测与对照比较
原文图注:Figure 5. Model of top-down computations in VTC. (a) Model architecture. The predicted response during the stimulus-directed tasks (categorization task, one-back task) is given by scaling the bottom-up response, with the amount of scaling proportional to the IPS signal. (b) Cross-validation performance. Same format as Figure 2b. The arrows highlight an example of how the bottom-up response (red arrow) is multiplied by the IPS signal (green arrow) to produce the predicted response (blue arrow). (c) Comparison of performance against alternative models. Same format as Figure 2c (some error bars do not include the bar height; this is a consequence of the bootstrap procedure). Although the Additive and Scaling models perform well, note that these are ad hoc, phenomenological models. For instanc
(a) 说明模型输入输出:以注视任务 VTC 响应和定向任务 IPS 响应为输入,输出定向任务下的 VTC 预测。(b) 沿用图 2 的格式,箭头演示一个具体例子——FFA 对面孔的响应在注视任务下随对比度渐增(红箭头),IPS 在单回溯任务下呈 U 形对比度响应(绿箭头),两者相乘得到的 FFA 预测是高度饱和的曲线,与实测吻合(蓝箭头)。(c) 与备择模型的交叉验证比较:IPS 缩放模型优于 IPS 加性模型、任务特异加性/缩放模型和区域特异增强模型;IPS 输入打乱(跨条件或仅跨刺激)后性能显著下降,证明调制确实依赖刺激与任务。此图支撑"主要结果"第 5 条的前半部分。图注在说明 Additive/Scaling 模型属临时唯象模型处截断。
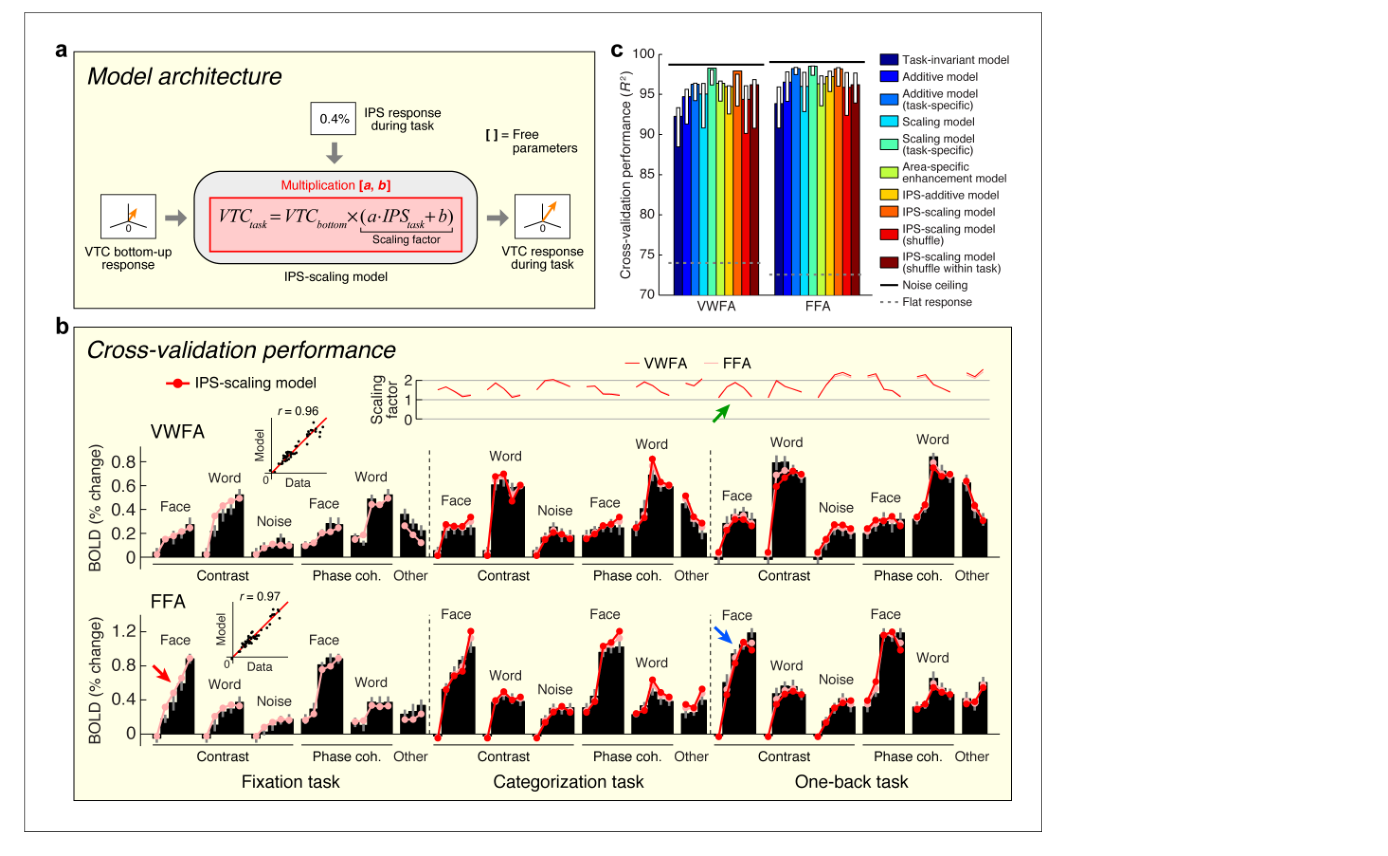
图 6 · 用漂移扩散模型解释 IPS 为何活跃
原文图注:Figure 6. Model of perceptual decision-making in IPS. (a) Model architecture. We implement a model that links the stimulus representation in VTC to a decision-making process occurring in IPS. The model first uses the bottom-up VTC response as a measure of sensory evidence and predicts reaction times in the categorization task. The model then predicts the IPS response as a monotonically increasing function of reaction time. Note that this model does not involve stochasticity in the evidence-accumulation process, and is therefore a simplified version of the classic drift diffusion model (Ratcliff, 1978). (b) Cross-validation performance. Same format as Figure 2b (except that reaction times are modeled in the left plot). (c) Comparison of performance against control models. The performance of the Drift diffusion model does not degrade substantially if a single threshold is used, thus justifying this simplification. Performance degrades if axis-aligned category vectors are used, supporting the assertion that responses of multiple VTC regions are used by subjects in deciding image category. (d) Overall model architecture. This schematic summarizes all components of our computational model (Figures 2a, 5a and 6a). Bottom-up visual information is encoded in the VTC fixation response (green box; Template model), fixation responses are routed to the IPS for evidence accumulation (purple box; Drift diffusion model), and then feedback from the IPS to VTC causes top-down modulation during the categorization and one-back tasks (yellow box; IPS-scaling model).
(a) 图示两步:VTC 注视响应向类别向量投影得漂移率→预测反应时;反应时经单调函数→预测 IPS 响应。文中明确此实现不含随机性,是经典漂移扩散模型的简化版,与线性弹道累积模型思路相近。(b) 左图对反应时、右图对 IPS 响应做交叉验证,两者都解释了可观方差。(c) 对照比较:单阈值版本几乎不损失性能,而坐标轴对齐的类别向量版本性能下降——意味着判断类别时被试利用了多个 VTC 区域的响应,而非只看本区。(d) 总架构图把模板模型(绿框)、漂移扩散模型(紫框)、IPS 缩放模型(黄框)串成"VTC 编码→IPS 累积→IPS 反馈缩放 VTC"的闭环,是全篇模型的收官示意。此图支撑"主要结果"第 5 条的后半部分。
讨论
作者把自己的贡献概括为:用一个由明确定义的图像计算组成的网络模型,统一解释了作用于 VWFA、FFA 和 IPS 的一整族刺激与任务操作,并把数据与开源代码(vtcipsmodel)公开。他们坦承三点局限:测试过的刺激与任务范围有限;模型精度"合理但绝非完美"(例如模板模型抓不住相位一致性变化时 VTC 的阶梯状响应,对包含动物、物体的大刺激集解释力至多中等);目前只在 ROI 平均的粗时空尺度上刻画 BOLD。讨论中最有锋芒的一点是方法论提醒:认知因素对刺激表征的影响如此之大(VWFA 的对比度响应函数随任务反号),以致任何不严密控制认知状态的实验里,感觉效应与认知效应原则上无法区分——由此可以重新审视 VWFA 中"语言层级调谐"和顶叶"物体选择性"这类反常报道。作者还逐一对照注意对 CRF 的三类经典模型(响应增益、对比度增益、加性平移),说明它们都无法解释这里刺激特异、方向可反的缩放效应。作者也明确承认连通性分析基于 BOLD 相关,不能证明 IPS 到 VTC 的因果方向与时序,只是一种在计算模型语境下施加的解释;缩放在神经层面可能是活动放大,也可能是活动维持(引 Ghuman et al. 2014 的 ECoG 证据),需要 EEG/MEG/ECoG 等时间分辨手段来检验。
一句话总结
在我看来,这篇文章最大的价值不在于某个具体数字,而在于示范了"高级视觉区也能像早期视觉一样被前向模型攻克"——只要你同时测量并显式建模认知状态。模板匹配加 IPS 缩放当然是对真实 VTC 计算的粗粒度近似(作者自己也承认),但它把"任务难度"从心理学术语变成了可计算的累积时间,这是同类 fMRI 研究里少见的闭环。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_001', 'classification': 'OVERCLAIM', 'current_text': 'IPS是自上而下调制信号的源头', 'reason': '将BOLD条件相关和模型解释提升为具有方向性的因果来源。', 'calibrated_claim': 'IPS-0/1附近响应与VTC任务残差最强相关,是候选调制节点,但方向和因果性尚未得到验证。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_002', 'classification': 'OVERCLAIM', 'current_text': '闭合整个回路', 'reason': '三个组件没有进行端到端串联验证,回路方向只是工作假设。', 'calibrated_claim': '三个独立建模结果可被组织成一个候选的VTC—IPS计算架构。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_003', 'classification': 'OVERCLAIM', 'current_text': 'VOF在全部8名被试中把VWFA和FFA与该IPS热点相连', 'reason': '概率纤维追踪显示的是VOF终止端与ROI或热点的空间邻近关系,不能证明直接、单突触或具有反馈方向的连接。', 'calibrated_claim': '8名被试的VOF追踪结果在空间上与VWFA、FFA及IPS热点之间存在解剖一致性,为该候选网络提供支持。'} -> 评注:
- 审校纠偏: {'overclaim_id': 'OVERCLAIM_004', 'classification': 'INTERPRETATION', 'current_text': '缩放直接改善读出信噪比', 'reason': '远离线性决策边界是分析结果;信噪比改善及其行为功能是作者解释,而非直接测量。', 'calibrated_claim': '缩放使平均表征远离所定义的决策边界,与更容易进行类别读出的解释一致。'} -> 评注:
- 补充要点: : (第 20 页)
- 补充要点: : (第 23 页)
- 补充要点: : (第 9 页)
- 补充要点: : (第 3 页)
- 补充要点: : (第 17 页)
- 补充要点: : (第 10 页)