IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
059| 原始基线:V0_ZCODE_BASELINE| 语义审核:needs_revision| 图表审核:pass
Diverse Deep Neural Networks All Predict Human Inferior Temporal Cortex Well, After Training and Fitting
Storrs · Journal of Cognitive Neuroscience · 2021 · Zotero itemID=769
这篇文章问的是一个所有用 DNN 建模腹侧通路的人都该自查的问题:模型与下颞叶(human inferior temporal cortex, hIT)的相似,到底来自架构、来自 ImageNet 训练、还是来自事后对脑数据的拟合?作者用九种差异极大的卷积架构、同一套 62 图 fMRI 数据、加上系统的"训练×拟合"分解给出了答案——训练有中等贡献(约 +57% 可解释方差),拟合贡献更大(约 +124%),而一旦训练并拟合,九种架构的表现全部达到统计上彼此无差别的水平。它对"深度是否等于更类脑"这个流行直觉是一次冷静的祛魅。
研究背景
在 ImageNet 物体分类任务上训练的深度神经网络(deep neural network, DNN)是当前预测人及非人灵长类高级腹侧视觉区表征的最好模型,这一点已被大量研究确认。但文献里各家 DNN 对脑表征的预测精度仍有相当变异(Xu & Vaziri-Pashkam, 2021;Zeman 等, 2020;Schrimpf 等, 2018),而这些差异究竟源自哪里,一直没有被系统拆解。作者指出至少有三个混杂来源:其一是"烤进架构里"的先验(如各层可表征的空间尺度)——可通过比较随机初始化的未训练网络来评估;其二是任务训练带来的结构化视觉特征——可通过同一架构的训练/未训练版本对比来评估;其三是"特征对了但比例不对"——两个学到同样特征的模型,若各自特征占比不同,对脑数据的表观预测力可以差别很大,这只能通过允许对特征做线性重加权(fitting)来暴露(Khaligh-Razavi 等, 2017)。麻烦在于已有文献的做法不一致:一些研究允许特征线性重加权,另一些把层表征当作固定的,导致跨论文的比较基本失效。这就是本文要系统回答的缺口:架构深度(8–201 层、25–825 个处理步骤)、任务训练与脑数据拟合三者各贡献多少?
研究思路
总体设计是控制变量式的逐因素分解:九种在计算机视觉史上各领风骚的 DNN(从 AlexNet 的 25 个处理步骤到 Inception-ResNet-v2 的 825 个,参数量从 124 万到 1.38 亿,ILSVRC Top-5 错误率从 20.9% 到 4.9%,人类约 5.1%),每个都测两种状态(ImageNet 训练版 vs 同均值方差随机初始化的未训练版)、每个关键层都测两种表征(原始全维特征 vs 先经"生态驱动"PCA 降到 100 维、再对主成分线性重加权的拟合表征),最后用表征相似性分析(representational similarity analysis, RSA)把模型表征相异性矩阵(representational dissimilarity matrix, RDM)与 24 名被试 hIT 的 RDM 对齐。方法上的两处设计是这篇文章说服力的来源:第一,拟合一律交叉验证——在自举样本内随机划分图像(12 张测试)与被试(5 名测试),所有权重在训练子集上估计、在被试与图像双双留出的测试集上评估,杜绝过拟合虚高;第二,噪声天花板(noise ceiling,即单个被试预测其他被试数据的水平,是"真模型"在该数据中能达到的期望区间)在与模型拟合相同的交叉验证折内计算,使"模型够不够好"的判断有据可依。作者还想回答"用不用 fitting"本身的方法学问题:拟合与不拟合分别回答不同的问题——前者问"这个架构能容纳什么样的表征几何",后者问"哪个架构、哪种训练目标的特征分布自然贴近脑"。
方法
fMRI 数据为已有的 62 张彩色图像(人脸、物体、场景,灰底 427×427 像素,动/静物与人造/自然均衡;其中 20 张人脸里有 14 张在低级图像统计上严格匹配,30° 半侧面、光照与颜色直方图对齐)呈 rapid event-related 设计下采集:24 名健康成人(15 女),图像居中呈 7° 视角、500 ms、试次起始间隔 3 s,扫描时做 1-back 重复检测;每 run 呈 56 张各一次加 6 张重复,两日各 12 个 run;扫描前在 Scanner 外完成 5 遍熟悉化,事后回忆测试平均正确率 92%(d′=3.58±0.26),确认被试确实注意了刺激。成像用 Siemens TIM-Trio 3T、32 通道线圈、2 mm 各向同性体素;SPM8 预处理、不做平滑。ROI 方面,V1–V3 用皮层表面模板(Benson 等, 2014)定义;hIT 用独立功能定位(432 张面孔/地点/物体/打乱图像 vs 基线)加解剖掩膜选出,并剔除 V1–V3 体素。响应模式用 GLM 估计并做多变量噪声归一化,RDM 由交叉验证马氏距离(crossnobis)计算,左右半球分别求再平均,得每被试 62×62 矩阵(1891 个独立距离对)。模型侧:九个网络(Alexnet、VGG-16、Squeezenet、Googlenet、Mobilenet-v2、Resnet-18、Resnet-50、Densenet-201、Inception-Resnet-v2)在 MATLAB Deep Learning Toolbox 中调用原开发者的 ImageNet 预训练权重,刺激缩放到各自输入尺寸;未训练版把各层权重换成同均值方差的高斯随机数。每个架构选出 8–103 个关键层(卷积/全连接输出或模块级联输出)。拟合分两级:先用 3020 张 Ecoset 图像(英语中最常见具体名词类别的生态代表性图像集,Mehrer 等, 2021)对各层做 PCA 取前 100 个主成分并算 PC-RDM,再以非负最小二乘把 100 个 PC-RDM 线性组合拟合 hIT(第一级、层内),随后把各层的拟合 RDM 再次线性组合(第二级、跨层)。统计上:1000 次自举(被试与图像同时重采样)× 每次自举内 200 折交叉验证;模型性能为预测 RDM 与每个测试被试 RDM 的平均 Spearman 相关;差异检验基于自举差值分布的单侧检验(α=.05,不做多重比较校正),模型间等价性用 Lakens(2017)的等价性检验(以噪声天花板下界的变异为参照),架构深度的连续分析用稳健相关(skipped correlation)。
主要结果
-
任务训练对 hIT 相似性的提升"出奇地小":逐层对比训练与未训练版本(图 3),即使采用宽松的单侧 α=.05 不校正标准,九个模型中也只有五个存在训练显著优于未训练的层,只有 Mobilenet 在多数层上训练后显著更好。不过训练确实塑造了层级结构:未训练模型各层 hIT 相关近乎平坦,训练后模型在约输入到输出的 1/2–3/4 处达到峰值,且在最后几层急剧下滑(作者归因于 1000 类稀疏 one-hot 目标迫使末层不表征图像间相似度)。但所有模型的所有层都显著低于噪声天花板下界——任务训练后的特征分布仍不完全对应 hIT。
-
拟合(PCA 降维 + 主成分重加权)戏剧性改善几乎所有层(图 4):对九个模型而言,层表征经降为 100 维再加权后,hIT 相关在几乎所有层显著上升;五个模型出现至少一层不再显著低于噪声天花板下界。同时深度不是答案(图 5):把各层的拟合表现按网络归一化深度对齐后,不同深度架构的峰值水平相当,且架构深度与整网 hIT 匹配无相关(训练+拟合 r=.20, p=.61;训练不拟合 r=−.07, p=.86,均不显著)。
-
训练与拟合各自及联合的定量贡献(图 6):以九个架构为观测的 2×2(训练×拟合)ANOVA 显示训练主效应 F(1,35)=33.82、拟合主效应 F(1,35)=43.69(均 p<.0001),且交互显著(F(1,35)=6.51, p=.016)——拟合对训练后模型的增益更大,说明 ImageNet 任务让模型学到了"hIT 表征会用到的真实世界特征",却没有学到这些特征在脑中的相对占比。以噪声天花板归一化后:训练带来 +57.5%(归一化 r² 从 .12 到 .19),未训练模型的拟合带来 +73.4%,而训练+拟合相对训练不拟合是 +124%(.21→.48)——超可加的组合。训练+拟合后九个架构平均解释 48.0% 的可解释秩方差;Googlenet、Densenet 与 Mobilenet 三个模型已与噪声天花板下界无法区分。等价性检验显示训练+拟合后全部 36 对模型间差异都与"人类被试之间的差异"统计等价(Bonferroni 校正),而不拟合时 8/36 对超出该变异;逐对差异的置换检验(Cohen's d=1.49, p=.001)同样表明拟合抹平了架构差异。
-
解释 hIT 的维度来自自然图像变异、且少量维度足矣(图 7):仅把各层等权平均前 100 个 PC-RDM(不做 hIT 拟合)就已提升 hIT 匹配(训练网络配对 t(8)=15.33, p<.0001;未训练 t(8)=3.23, p=.0121;训练网络平均提升 25.5%)——即便某些层从上百万维压到 100 维。以 Mobilenet 为例扫主成分数 1–3000,性能从 1 维到 10 维大涨、约 50 维即平台,100 维绰绰有余。
-
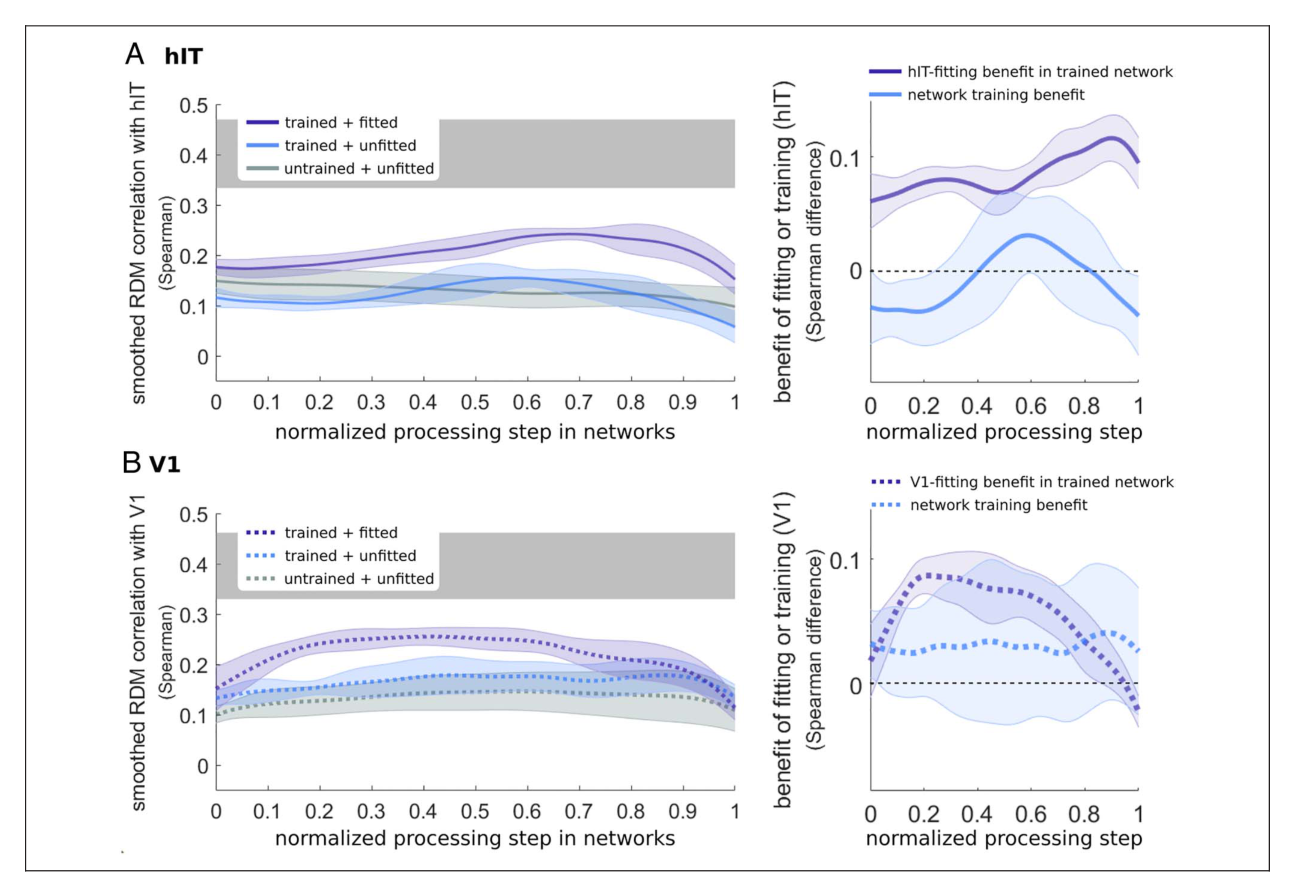
同样这批模型也能解释 V1——只要把权重移向前层(图 8、图 9):同一批 62 图在 V1 与 hIT 的表征几何截然不同(区域内被试间一致性相近:V1 r=.381、hIT r=.383;跨区互预测仅 r=.163),但训练+V1 拟合后九个模型同样表现优异(训练 F(1,35)=15.40, p=.0004;拟合 F(1,35)=20.46, p=.0001;交互不显著 p=.09),五个架构(Resnet-18/50、Densenet、InceptionResnet、Mobilenet)与噪声天花板下界无法区分,且模型间差异同样被拟合抹平(Cohen's d=1.05, p=.002)。层-区域对应只在拟合后浮现:拟合前峰值层位置在 hIT(0.56)与 V1(0.59)间无差,拟合后 hIT 峰值显著更靠深层(0.70 vs 0.48,t(8)=3.20, p=.013),拟合收益峰值也分别落在深层(hIT 0.76)与前层(V1 0.35)(t(8)=3.73, p=.006)。
图注解读
图 1 · 62 图 fMRI 数据集与平均 hIT RDM
原文图注:Figure 1. Human fMRI data set. Sixty-two stimulus images (A) were shown to 24 human participants in a rapid event-related fMRI experiment. An RDM was constructed for each participant from the cross-validated Mahalanobis distances between the multivoxel activation patterns elicited by each image in inferior temporal cortex (hIT). The average of all individual RDMs is shown in B, with dissimilarity between the hIT representation of each pair of images expressed as a percentile for visualization purposes.
A 面板铺出全部 62 张刺激(人脸/人像/动物/物体/场景,灰底孤立物体),B 是把 24 名被试各自的 hIT RDM 平均后的矩阵,每格用百分位数表示该图像对在 hIT 中的相异性(颜色越"热"越不相似)。读这张 RDM 的正确方式是找块状结构:相似类别(如多张匹配的人脸)对应内部低相异的浅色块,类别边界对应高相异条带。这张图定义了全文所有模型要预测的目标对象,也交代了被试间一致性高(正文给出 hIT 内 r=.383)这一背景,使得后续"模型间差异不超过被试间差异"的等价性检验有了参照系。
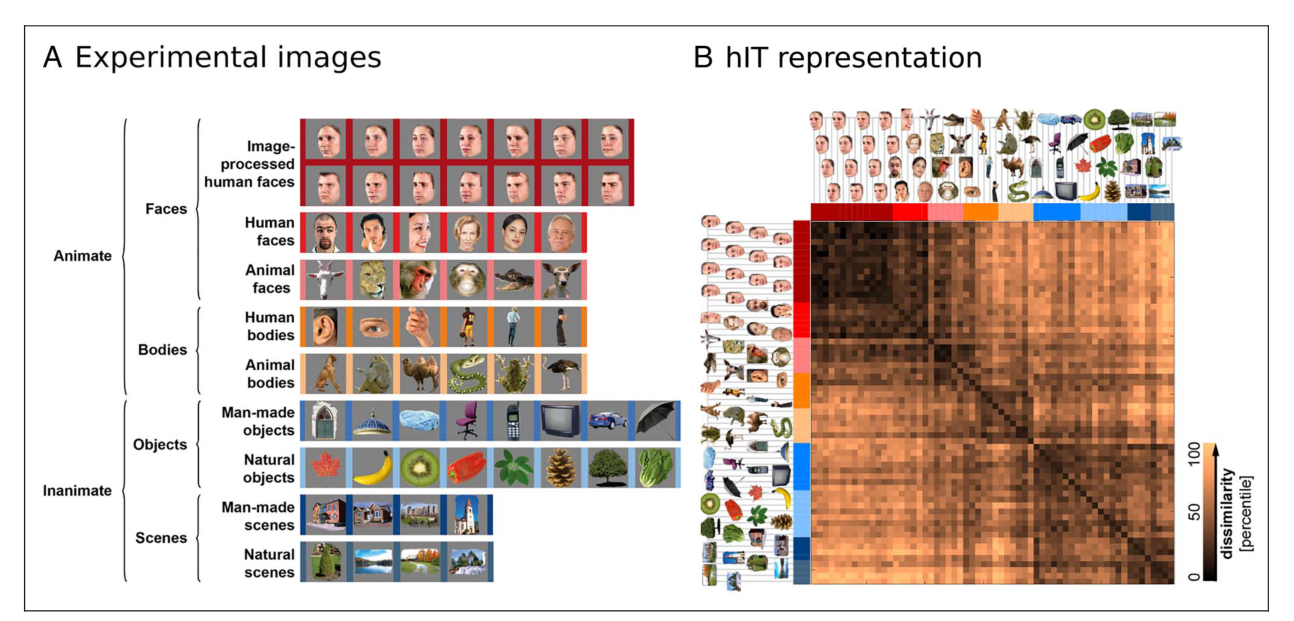
图 2 · 生态驱动降维与两级重加权流程
原文图注:Figure 2. Ecologically driven dimensionality reduction and component reweighting. An independent data set (A) of 3020 images derived from object categories that are important to humans was constructed by sampling uniformly from the ecoset data set (Mehrer et al., 2021). We recorded the activations elicited by these images in each unit of each layer of each network. On the basis of the data obtained from all units of a given layer, we then ran a PCA to identify the first 100 orthogonal components that explained the most variance in the layer's response to these ecologically representative images. By projecting activation vectors onto each of the 100 principal components in turn, we constructed 100 PC-RDMs for the 62 experimental stimulus images, within each network layer, using Euclidean distance. (B) The 100 PC-RDMs in each layer were linearly combined using a cross-validated reweighting procedure to best predict the hIT fMRI representation ("first-level fitting"). ……
这是全文方法的示意图。A:先用 3020 张 Ecoset 图像(与测试集无重叠、带背景的自然照片)通过每个网络每一层,对每层响应做 PCA 取前 100 个正交主成分,再把 62 张实验图像的激活投影到各主成分上、以欧氏距离算出 100 个 PC-RDM。B:每层内用交叉验证的非负最小二乘为 100 个 PC-RDM 分配权重(第一级拟合),再跨层组合各层拟合 RDM(第二级拟合,图中未画);所有权重都在与测试不同的被试和图像上估计。读图要点在于"生态驱动"四个字的含义:主成分的选取不基于脑数据,而是基于网络对人类重要物体类别的响应方差,因此降维本身不算"作弊",改为:PCA主成分的确定独立于脑数据;随后层内PC-RDM重加权和跨层重加权都是交叉验证的hIT拟合。——这一区分支撑结果第 4 条(降维独立于拟合也有收益)。
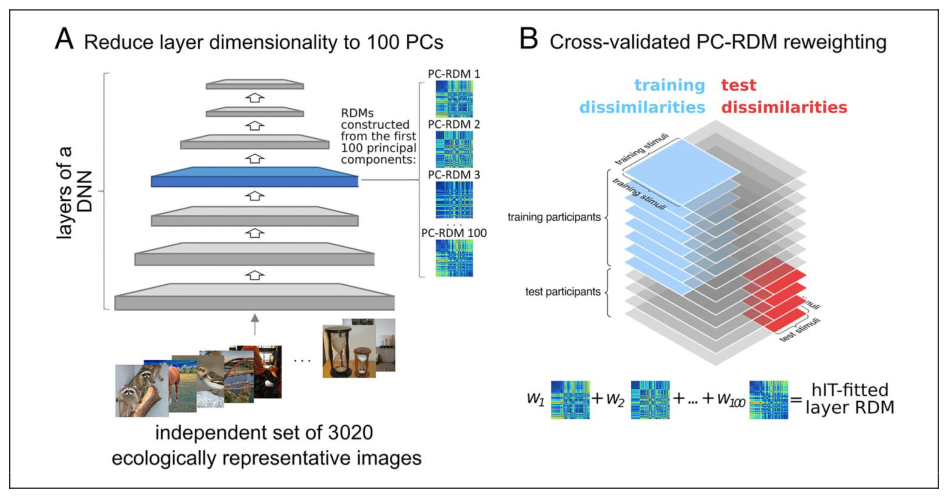
图 3 · 训练带来的改善:有、但小且不普遍
原文图注:Figure 3. Object recognition training improves hIT correspondence in some layers of some models. Panels show the hIT correlation of the full representation in each layer of each architecture, with no dimensionality reduction or feature reweighting, for an object-recognition trained instance of each network (blue) and for a corresponding untrained instance with randomly initialized weights (gray). Each dot corresponds to one of the key layers selected for analysis (see Table 1) and indicates the mean of a distribution of 1000 bootstrap estimates of cross-validated layer performance, bootstrapped over both subjects and stimuli. ……
九个小面板(每个架构一个):横轴为该层的处理步数(跨架构可比),纵轴为 hIT Spearman 相关,蓝线=训练版、灰线=随机权重版,阴影为自举标准差,水平灰带是噪声天花板上下界,蓝色星号标记该层训练显著优于未训练(α=.05 不校正)。读法有三层:其一,灰线大致平坦——未训练架构各层水平接近,说明"架构烤进来的先验"本身贡献有限;其二,蓝线在约 1/2–3/4 深度处拱起、在末端下沉,说明任务训练赋予了层级性(对应结果第 1 条);其三,所有蓝点都在灰带下方——没有任何模型的任何层触及可解释方差上限。这张图奠定了全文的反直觉基调:训练有用,但单靠训练远不足以让模型"像" hIT。
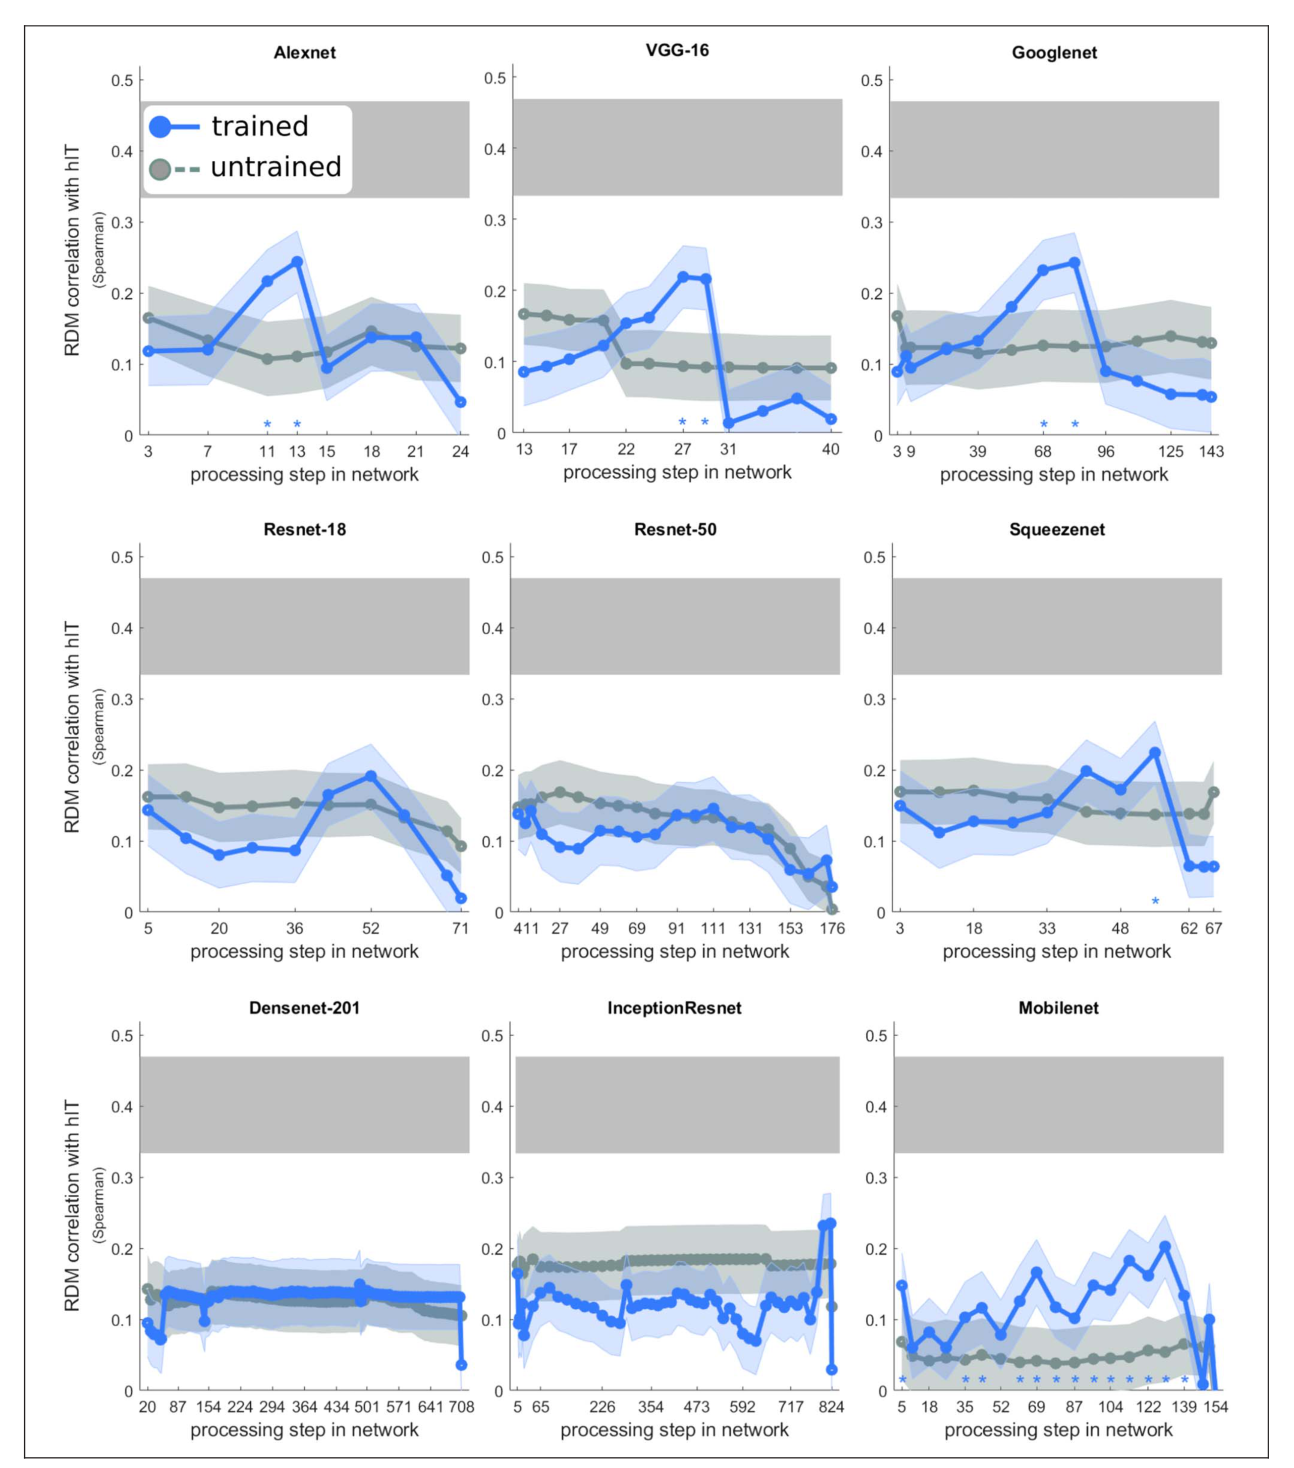
图 4 · 拟合后的跃升:多数层接近噪声天花板
原文图注:Figure 4. Reducing and reweighting the feature space dramatically improves hIT correlation across most layers in all network architectures. Each panel shows, for one model, the hIT correlation of the unfitted representation in the full original feature space (pale blue lines, same data as shown in Figure 3) and of the same feature space after reducing to 100 dimensions via ecologically driven dimensionality reduction (see Figure 2) and linearly reweighting those dimensions to fit hIT representations (cross-validated over both subjects and images). Blue asterisks indicate that the fitted layer performs significantly better than the original unfitted feature space. ……
每个架构一个面板:浅蓝线是图 3 的原始全维表征,深蓝线是同一特征空间经"生态 PCA 降 100 维 + 层内重加权"后的表现;星号=拟合显著更优,"ns"=拟合后与噪声天花板下界无显著差异。与图 3 对照着读,视觉冲击在于曲线整体被抬高:几乎所有层都显著改善,不少模型的中后段层进入噪声天花板区间。作者特意强调拟合用的是留出的图像与被试,所以这不是过拟合假象,而是"同一特征空间、重新分配特征占比"后释放的真实解释力——支撑结果第 2 条,也直接导出"训练学到了对的特征但比例不对"的结论。
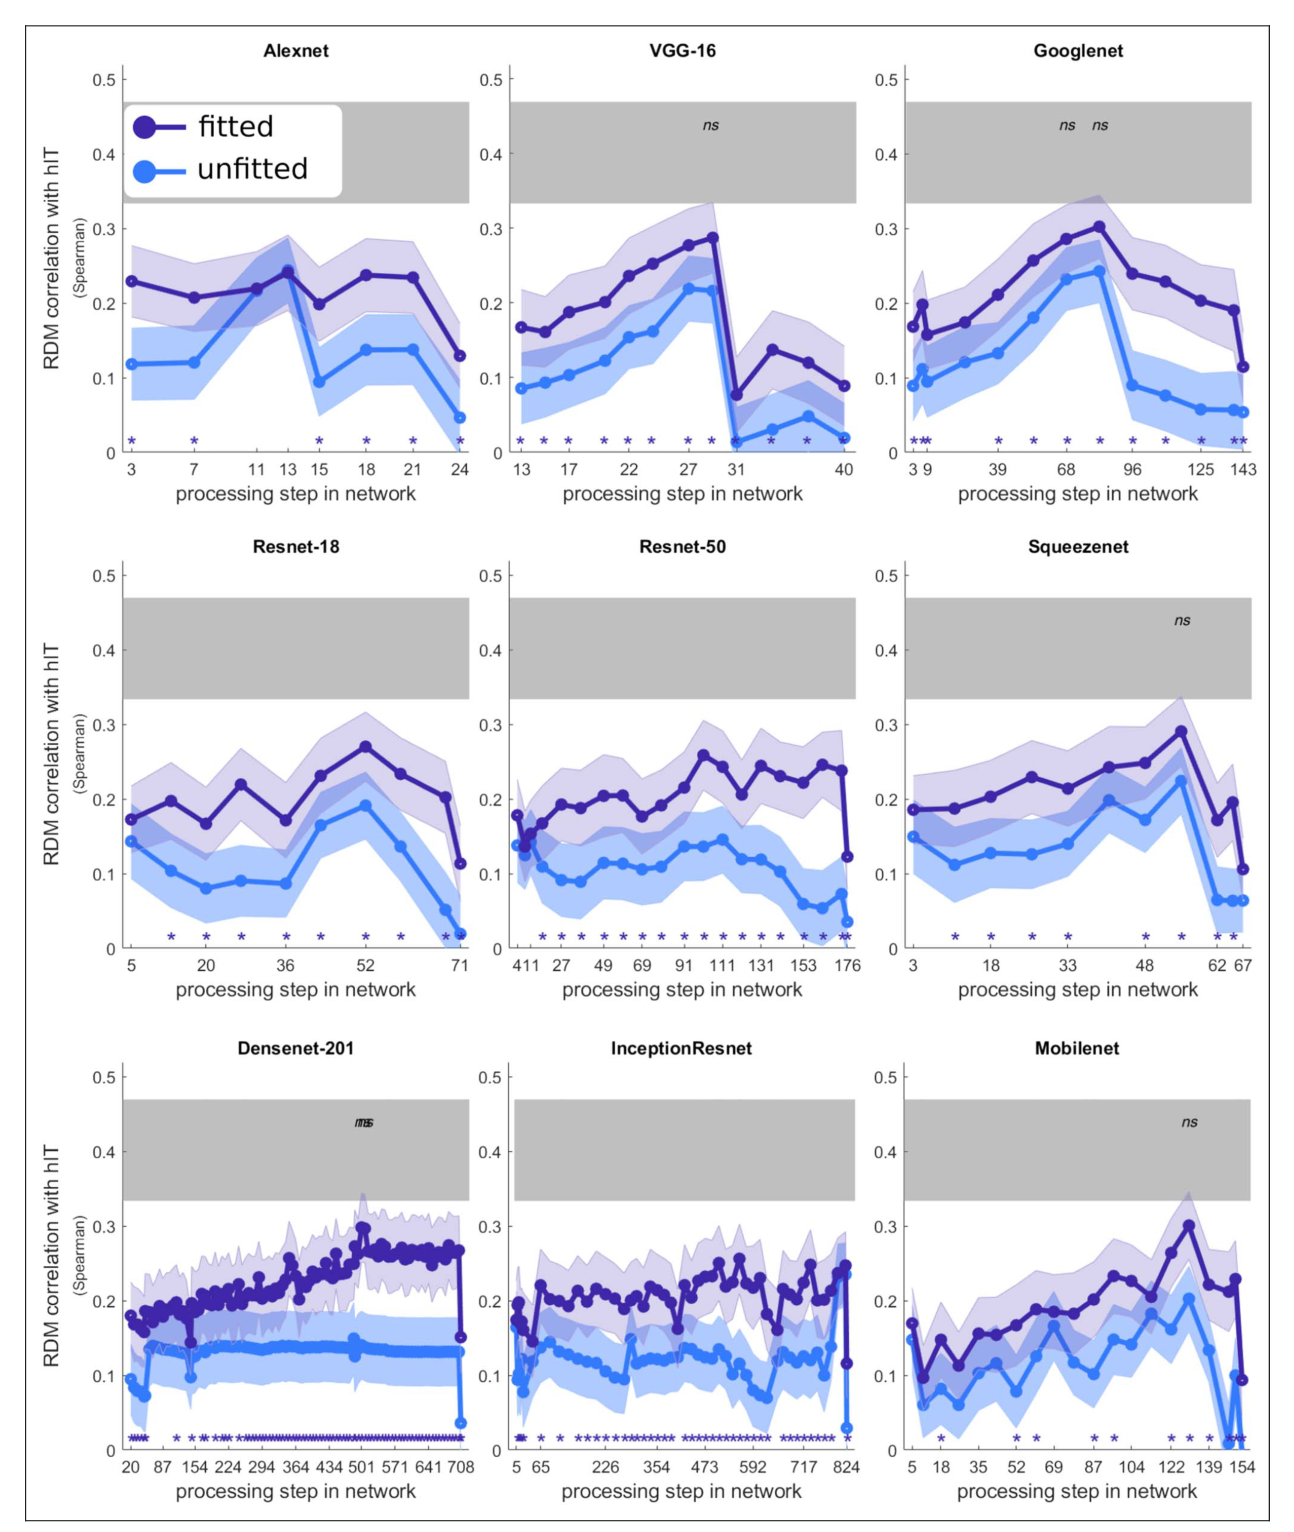
图 5 · 深度不是答案
原文图注:Figure 5. Depth is not the answer. Correlation with hIT representation for all layers of all networks, after "ecologically driven" PCA reduction and reweighting. Although many models reach representations in their late intermediate layers that well match hIT, increasing depth does not equate to increased hIT match, either within or between architectures, within this range of highly successful object-recognition computer vision models.
九个架构的拟合后逐层 hIT 相关被放到同一坐标上,横轴统一为"处理步数占全网的深度比例"。读图要点:各模型的曲线峰值高度彼此接近,而峰值出现的位置——大多在 1/2 到 3/4 深度——并不随架构总深度系统右移;25 步的 Alexnet 与 825 步的 Inception-ResNet-v2 达到的 hIT 匹配相当。配合正文报告的整网相关(深度与 hIT 匹配 r=.20/−.07,均不显著),这张图否定了"更深的网络更类脑"的推断(作者点明这与 Kubilius 等 2019、Schrimpf 等 2018 的倾向不同),支撑结果第 2 条的深度部分。
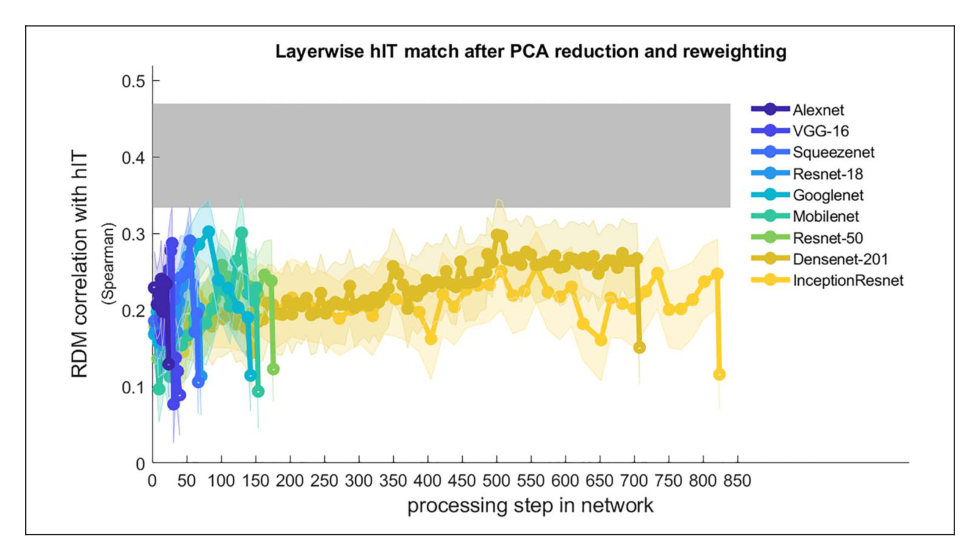
图 6 · 整网汇总:训练与拟合的主效应及超可加交互
原文图注:Figure 6. Training and within-layer fitting both improve correlation with hIT. (A) Bars show an estimate of the combined performance of all layers within each of the networks, obtained by second-level (across-layer) fitting in all cases. The fitting procedure is identical to that used to reweight principal components within each layer, except that it takes as input per-layer RDMs rather than PC-RDMs. Pale gray bars show the hIT match for the raw (unfitted) feature space of a randomly weighted instance of the network, dark gray bars show hIT match for the same random feature space after PCA reduction and within-layer reweighting, pale blue bars show hIT match for the unfitted feature space of the object-recognition-trained network, and dark blue bars show hIT match for the trained network ……
A 把九个架构的整网表现画成四组柱:将四组分别写为:未训练+层内未拟合、未训练+层内拟合、训练+层内未拟合、训练+层内拟合;并注明四组均接受跨层二级拟合。,灰带为噪声天花板。读法是按"灰→蓝"看训练效应、按"浅→深"看拟合效应:训练柱抬升幅度适中,拟合柱抬升幅度大,而深蓝柱整体逼近灰带——三个模型(Googlenet、Densenet、Mobilenet)标"ns",即与天花板下界无法区分。B 是跨架构平均,把 +57.5% / +124% 的方差增益和超可加交互(F(1,35)=6.51)可视化。这张图是结果第 3 条的全部量化证据的图形化汇总,也是标题"训练并拟合之后全都好"的直接出处。
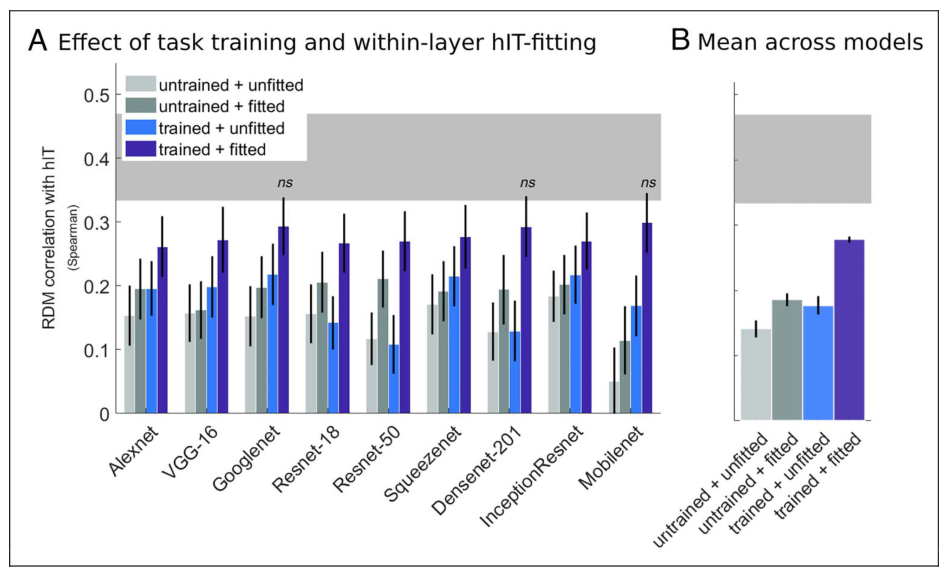
图 7 · 自然图像维度的独立贡献与维度数量的稳健性
原文图注:Figure 7. Finding dimensions of natural-image variation within each layer's feature space improve hIT match, and a small number of dimensions are sufficient. (A) Estimates of the whole-network hIT correlation for trained (blue) and random (gray) networks, derived by reweighting layer RDMs obtained from either (left) the full original feature space; (center) the first 100 components of that feature space, derived via PCA on an independent natural image set; and (right) after reweighting the principal components within each layer to predict hIT representations. (B) Estimates of the whole-network hIT correlation for one example network, Mobilenet, in its trained (top) and untrained (bottom) states, after reducing the feature space within each layer to various numbers of principal components …
A 把拟合拆成两步单独评估:左=原始特征空间、中=仅做等权 PCA-100 降维(不拟合)、右=降维+重加权。可见中点已明显高于左点(训练网络配对 t(8)=15.33),说明"挑出自然图像变异最大的维度"这一步独立于向脑数据拟合就有收益(平均 +25.5%)。B 以 Mobilenet 为例(选它是因为训练+拟合时最好、未训练+不拟合时最差,是最保守的检验对象)扫主成分数(横轴对数):性能从 1 维到 10 维陡升、约 50 维即平台,训练与未训练皆然。这张图回应两个潜在质疑——PCA 是否只是把信息丢了、100 维是否恰好偏袒低维模型——答案都是否,支撑结果第 4 条。
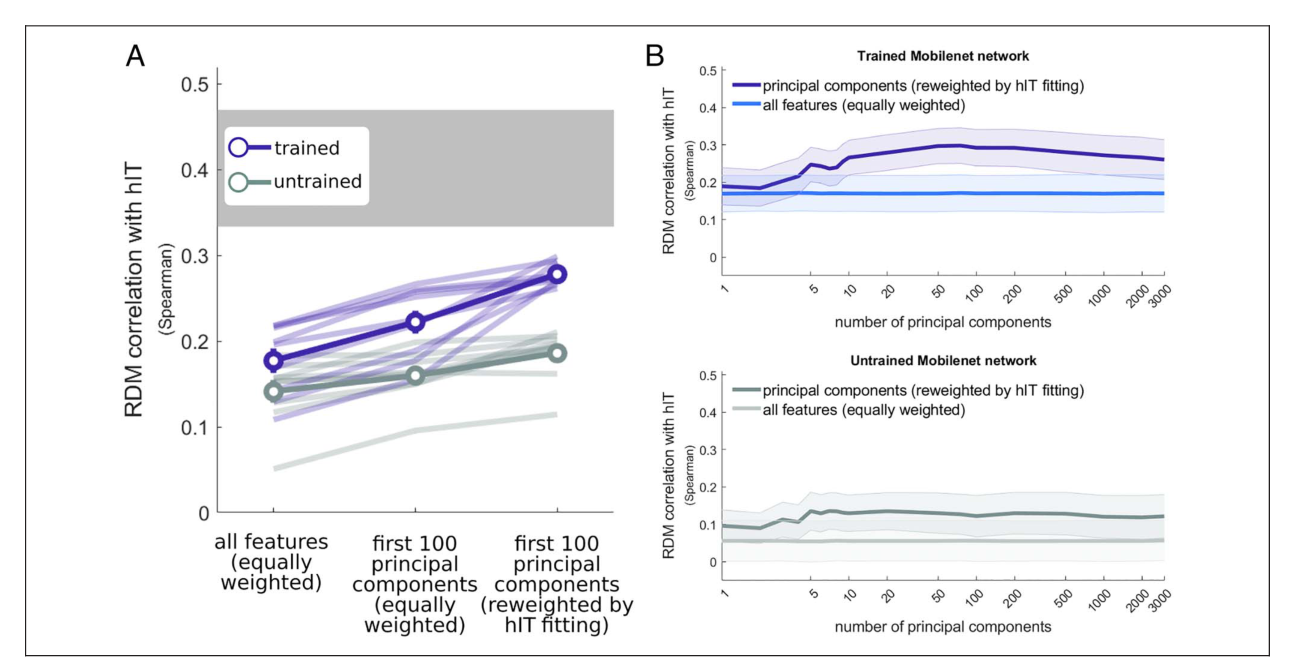
图 8 · 同一批模型也能解释 V1
原文图注:Figure 8. The same models are able to well explain the very different representations in V1. (A) Representational dissimilarity of the same 62 experimental images in V1 (top) and hIT (bottom; as in Figure 1B) averaged over participants. There was good interindividual consistency within each region, but there were substantial differences in representational geometry between regions. (B) Bars show an estimate of the combined performance of all layers within each of the networks, obtained by second-level (across-layer) fitting in all cases. Pale gray bars show the V1 match for the raw (unfitted) feature space of a randomly weighted instance of the network, dark gray bars show V1 match for the same random feature space after PCA reduction and within-layer reweighting on V1 data, pale blue bars ……
A 上下并排展示同一 62 图在 V1 与 hIT 的平均 RDM:两矩阵内部块状结构明显不同(跨区互预测仅 r=.163),说明这两个区域表征几何确实两样,不是"什么都像"。B 的柱状图与图 6 完全同构、只是目标换成 V1:训练与拟合主效应都显著(F(1,35)=15.40 与 20.46),交互不显著(p=.09),五个训练+拟合架构标"ns"(达到噪声天花板下界)。这张图的意义在于排除一个廉价的解释——"模型好只是因为 hIT 的几何与卷积特征天然亲和"——因为同一批模型换一组权重就能同样好地解释几何截然不同的 V1,支撑结果第 5 条。
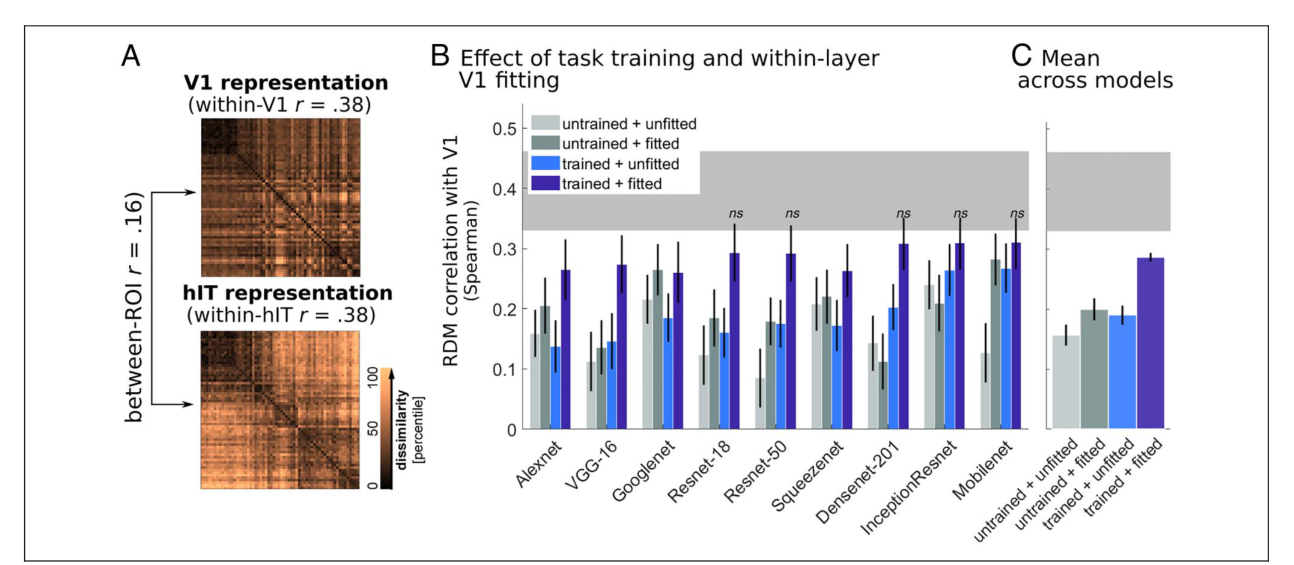
图 9 · 层-区域对应:拟合之前看不见,拟合之后浮现
原文图注:Figure 9. Fitting most improves the performance of deeper layers when predicting hIT and earlier layers when predicting V1. (A, Left) Mean and 95% confidence interval across nine DNNs of smooth splines fit to layerwise hIT correlation, normalized by network depth (raw values are shown in Figures 3 and 4), for (gray) untrained and unfitted models, (pale blue) trained but unfitted models, and (dark blue) trained and within-layer hIT-fitted models. (A, Right) Mean and 95% confidence interval of smooth splines fit to the difference in hIT correlation between either (pale blue) trained unfitted minus untrained unfitted networks or (dark blue) trained and fitted minus trained but unfitted networks. ……
A 行针对 hIT、B 行针对 V1。左列是九个网络逐层相关(深度归一化)的平滑样条均值±95% CI:一个值得注意的细节是训练但不拟合时,hIT 与 V1 的峰值层位置竟然无差(0.56 vs 0.59,t(8)=−0.10, ns);右列是"训练减未训练"与"拟合减训练不拟合"的差值样条——差值曲线的峰在 hIT 位于深层(0.76)、在 V1 位于浅层(0.35,t(8)=3.73, p=.006)。读这张图要抓住作者自己点明的微妙之处:"浅层管 V1、深层管 hIT"这个直觉在这个数据集里只有允许拟合之后才成立——拟合把各层相对于脑区的适配都拉高了,同时把峰值层的位置推向与区域复杂度匹配的方向,支撑结果第 5 条的后半。
讨论
作者把发现组织成三层含义。其一,关于"为什么":任务训练的适度收益说明带空间结构的视觉特征(图像统计与冗余)是解释 hIT 的必要基底,也支持"生态相关任务塑造脑样特征"的规范取向(normative approach);但拟合的更大收益(+124%)说明 ImageNet 的物体识别目标——其类别分布与人类视觉食谱相去甚远,甚至不含"person"或"face"——并不能自然产生脑中特征的正确占比;此外测量过程本身会扭曲被测特征的采样占比(Kriegeskorte & Diedrichsen, 2016),这也是重加权有其合理性的第二个理由。其二,关于理论比较:训练+拟合后,九种架构两两之间统计等价于人类被试之间的差异,且架构间(不拟合时)的差异与深度、分类精度、训练前匹配度、V1 预测力统统不相关(如 ILSVRC 精度与 hIT 相关 r=−.38/.32,均 ns)——作者未找到任何让某些架构"天生更类脑"的因素,结论是这些模型的共同属性(深前馈层级、空间受限非线性滤波器、感受野逐层增大)比它们的差异更重要;这与 Geirhos 等(2020)在行为数据上的收敛结果互相印证,并把未来方向指向循环网络、学习目标与训练食谱等尚未充分探索的维度。其三,作者对局限交代得坦率:每架构只有一个训练实例,无法区分架构差异与"训练个体差异"(Mehrer 等, 2020);48% 的可解释秩方差虽与猕猴电生理文献相当,但离天花板尚远;DNN 还有对噪声脆弱、偏纹理、对人工刺激预测力差等已知问题;等价性检验的解读也需谨慎,因为人类数据本身带大量测量噪声。
一句话总结
在我看来,这篇论文最持久的贡献是把"DNN 是腹侧通路好模型"这句话拆成了可分别定价的三个零件——架构、训练、拟合——并且给出的价格表颇为降温:架构几乎免费,训练值五成,拟合值一倍还多。读它之后再去读任何"DNN-X 比 DNN-Y 更类脑"的论文,我都会先问一句:你们拟合了吗、拟合得公平吗——这正是 Storrs 等人留下的方法论遗产(此段为我的个人评价)。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[A, B] - Fig2: 提取质量
good,对齐度full,识别面板[A] - Fig3: 提取质量
good,对齐度full,识别面板[] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[] - Fig6: 提取质量
good,对齐度full,识别面板[A] - Fig7: 提取质量
good,对齐度full,识别面板[A, B] - Fig8: 提取质量
good,对齐度full,识别面板[A, B] - Fig9: 提取质量
good,对齐度full,识别面板[A, B]
关键事实与局限性声明
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '研究思路', 'current_text': '总体设计是控制变量式的逐因素分解', 'problem': '训练与随机权重的架构内比较较受控,但不同架构使用不同开发者提供的单个预训练实例,训练数据版本、增强策略和随机初始化并未完全控制,不能视为严格的全因素控制实验。', 'recommended_fix': '改为“系统的比较与因素分解”,并明确架构效应仍与训练实例和训练配方部分混杂。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '研究思路', 'current_text': '杜绝过拟合虚高', 'problem': '被试和图像双重留出显著降低并检验了样本内过拟合,但不能绝对排除分析选择、模型灵活性或对该数据集特征的依赖。', 'recommended_fix': '改为“降低过拟合导致的虚高,并检验对未见被试和图像的泛化”。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '图注解读—图5', 'current_text': '这张图否定了‘更深的网络更类脑’的推断', 'problem': '研究仅在九个高性能、监督训练的前馈卷积网络和一个62图fMRI数据集内未发现深度优势,不能否定更广泛模型空间中的深度效应。', 'recommended_fix': '改为“在本研究所测试的九种高性能卷积架构及当前数据集内,没有证据表明更深网络具有更高hIT匹配度”。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '图注解读—图7', 'current_text': 'PCA是否只是把信息丢了……答案都是否', 'problem': 'PCA降至100维必然舍弃部分方差;结果只表明被舍弃的维度没有提高当前刺激集与fMRI分析中的hIT预测,而且维度扫描仅在Mobilenet上完成。', 'recommended_fix': '改为“前100个PC已足以捕获当前Mobilenet、刺激集和fMRI数据中与hIT预测相关的主要方差;不能据此断言没有信息损失或推广到所有网络和数据集”。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '讨论', 'current_text': '带空间结构的视觉特征是解释hIT的必要基底', 'problem': '训练模型优于随机模型说明这类结构化特征提供了更好的预测基础,但没有进行必要性操纵,也未排除其他训练目标或特征体系。', 'recommended_fix': '改为“结构化视觉特征为预测hIT提供了更好的基础,并提示生态相关训练可能有助于形成脑样特征”。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '图注解读—图8', 'current_text': '排除一个廉价的解释——‘模型好只是因为hIT的几何与卷积特征天然亲和’', 'problem': '区域特异性重加权后同一网络可拟合V1与hIT,证明模型特征空间具有灵活性,但不能排除卷积特征与hIT存在天然亲和;灵活拟合本身也可能提高对不同几何的适配。', 'recommended_fix': '改为“表明这些网络并非只能适配hIT几何,而能通过区域特异性权重预测V1与hIT;这不能单独判定其对任一区域是否具有天然亲和”。'} -> 评注:
- 审校纠偏: {'classification': 'OVERCLAIM', 'md_section': '一句话总结', 'current_text': '架构几乎免费,训练值五成,拟合值一倍还多', 'problem': '研究没有独立估计架构的绝对贡献:所有模型共享卷积前馈层级,随机网络仍能解释部分方差,且未拟合模型之间存在差异。“价格表”只能作为修辞性个人评价,不能当作定量因果分解。', 'recommended_fix': '保留个人评价标签,同时改为“在所测试架构家族内,训练带来约57.5%的相对增益,而增加层内拟合带来约124%的相对增益;架构特异差异在充分拟合后显著缩小”。'} -> 评注:
- 补充要点: : (第 7 页)
- 补充要点: : (第 16 页)
- 补充要点: : (第 13 页)