IT Literature Intelligence 终审版本 (VERIFIED) 论文编号:
000| 原始基线:V0_ZCODE_BASELINE| 语义审核:needs_minor_revision| 图表审核:minor_issue
Invariant object recognition in the visual system with novel views of 3D objects
Stringer · Neural Computation · 2002 · Zotero itemID=115
一句话定位:这篇文章用计算模型回答了一个很具体的问题——视觉系统只需见过物体的少数几个视角,凭什么能认出它从未见过的样子?作者在 VisNet 网络中证明,只要低层预先学会了三维物体表面特征如何随深度旋转发生透视变形(perspective transform),高层仅用四个视角训练就能对第五个新视角做出不变的响应。这是"迹踪学习"(trace learning)纲领中把不变性学习从平移推广到深度旋转、并明确讨论"对新视角泛化"的关键一步。
研究背景
到 2002 年,电生理证据已经相当一致:从 V1、V2、V4 一路到下颞叶皮层(inferior temporal cortex, IT),神经元的感受野(receptive field)逐层变大,顶层的细胞能对物体产生跨视角、跨尺寸、跨位置平移不变的响应(Desimone 1991、Tanaka 系列、Logothetis 等 1995、Booth & Rolls 1998)。Rolls 提出的解释框架包含三件套:带局部分级抑制的层级竞争网络、来自前一层拓扑对应区的汇聚连接、以及一条带"活动迹踪"的修正 Hebb 学习规则——迹踪本质上是细胞近期活动的时间平均,利用了真实世界中同一物体的相继变换视图在时间上紧密出现的统计规律(Földiák 1991)。这个设想已经在 VisNet 模型里得到验证,平移、尺寸、视角的不变性都能自发形成(Wallis & Rolls, 1997)。
但当时的模型结果留着一个重要的缺口。按 Rolls 的分析,深度旋转带来的变化其实分两类:一类是"通用视图(generic view)之间"的灾难性变化——比如杯子倾斜到能看见杯口内侧,界面的定性形状描述子整体重排(Koenderink, 1990);另一类是"通用视图之内"的小角度旋转,定性描述子不变,改变的只是定量(metric)值,即表面特征经历连续的几何/透视变形。VisNet 已有的结果主要展示了把时间上相邻的视图关联起来,但对"视图内部"的透视变形学习是否真的发生、以及学到这套变形规律后能否外推到没见过的变形,此前没有正面检验。此外,特征层级网络是否必须见过物体的每一种变换才能达到不变识别(Wallis & Rolls 1997、Riesenhuber & Poggio 1998 都触及过这个问题),也悬而未决。这篇文章就是要同时补上这两块。
研究思路
作者的总体策略是"分解问题、分摊学习"。为了把不变性学习干净地隔离在"表面特征变形"这一种变换上,他们刻意选用球体作为刺激:球无论怎么转都没有边界形状的灾难性变化,也没有定义边界的度量变化,还去除了阴影与立体线索,因此网络要解决的不变性只可能来自表面标记(surface marking)的透视变形本身。逻辑链是:低层先用特征"对"(pairs)在全部五个旋转视角上训练,让网络掌握每种特征独立经历变形的规律;高层再用特征"三元组"(triples)训练——但只给四个视角, deliberately 留下第五个作为泛化测试。如果高层的不变性其实承袭自低层学到的"特征如何变形"的知识,那么对由旧特征新组合而成、且只见过部分视角的三元组,网络仍应在新视角上给出不变的响应。这就把"是不是必须见过每种变换才能不变"变成了一个可用对照实验回答的问题。
方法
模拟用的是 VisNet 的最新版本 VisNet2,参数沿用 Rolls 与 Milward(2000):一个四层前馈网络,对应灵长类腹侧视觉通路(ventral stream)的 V2、V4、后下颞叶皮层(TEO)与下颞叶皮层(TE),各层通过拓扑对应区汇聚连接使感受野逐层扩大(图 1 中标注的感受野从第 1 层约 1.3 度扩到第 4 层约 50 度)。学习采用带迹踪的 Hebb 规则,迹踪参数 η 设为 0.8,学习率在 1 到 0 之间退火。刺激方面:特征为竖、斜、横三种弧线,可放在球面上相隔 15 度弧的三个位置 A、B、C;两特征刺激共 18 个(如 102 表示 A、C 位有特征、B 位为空),三特征刺激共 6 个(123、132、213、231、312、321)。图像按 128×128 像素投影,先经一组按 V1 简单细胞调谐特性设计的输入滤波器预处理,再送入网络的 128×128 视网膜。每个刺激按随机顺序出现在 -60°、-30°、0°、30°、60° 五个深度旋转视角上,每层依次训练(第 1 到 4 层的训练轮数分别为 50、100、100、75)。评估用两种信息量指标:单细胞信息量(single cell information,衡量单个第 4 层细胞对"是哪个刺激"的与视角无关的信息,理论上限为 log2(6)≈2.6 比特)与多细胞信息量(multiple cell information,对每个刺激选出信息值最高的 5 个细胞,衡量一群细胞的总体判别力;计算方法出自 Rolls, Treves & Tovee, 1997 与 Rolls & Milward, 2000)。
主要结果
- 两阶段训练后网络对未见过的第五个视角达到完美判别。实验 1 中第 1、2 层只用 18 个特征对在全部五个视角训练,第 3、4 层只用 6 个三元组在四个视角(-60° 到 30°)训练,测试却覆盖全部五个视角:若干第 4 层细胞的单细胞信息量达到 2.6 比特的理论上限,多细胞信息量也达到满值 2.6 比特,说明全网络对六个三元组在任意视角都能完美区分(图 4)。
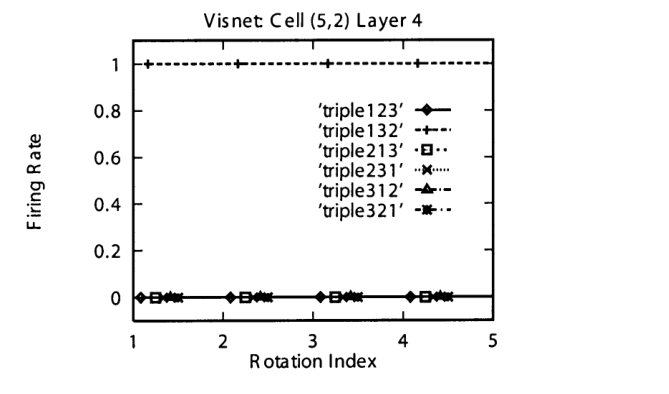
- 改为“一个第4层模型单元在所测试的五个离散视角上表现出视角不变的选择性响应”。图 5 展示的一个顶层神经元对三元组 132 在全部五个朝向下都给出最大响应,对其他五个三元组响应都低,响应曲线不随朝向变化——而它训练时只见过其中四个朝向。
- 不变性不是记住了哪个视角的模板,而是学到了"变形规律"本身。对照实验中,先用不含变形的刺激训练(把 0° 视角的特征 2D 平移到旋转后应出现的位置,不做透视变形),再用真实 3D 变形图像测试,网络的单细胞与多细胞信息量都明显变差,多数第 4 层神经元不能对每个旋转三元组的五个实例都响应。这说明实验 1 学到的不变性特异于表面特征在深度旋转中真实经历的变形。
- 改为“在该分层训练设计中,作者将泛化归因于低层已经形成的特征对不变表征;这一机制解释与结果一致,但未通过选择性低层消融被独立验证”。要获得对新视角的不变性,并不需要对完整物体做全变换训练:只要特征对的不变性在低层训练好,三元组只需少量呈现(以便把中间层到高层的权重练出来)即可,不变性来自对特征对的不变学习,而非对三元组本身的不变学习。
图注解读
图 1 · VisNet 四层架构与视觉通路的对应
原文图注:Figure 1: (Left) Stylized image of the VisNet four-layer network. Convergence through the network is designed to provide fourth-layer neurons with information from across the entire input retina. (Right) Convergence in the visual system (adapted from Rolls, 1992). V1: visual cortex area V1; TEO: posterior inferior temporal cortex; TE: inferior temporal cortex (IT).
这张图是全文的骨架:左半边是模型,四层网络自下而上逐级汇聚,使第 4 层神经元能接收来自整个"视网膜"的信息;右半边是生物学对应物,V1—V2—V4—TEO—TE 的腹侧通路层级。图中还标注了各层感受野大小逐层递增(约 1.3°、3.2°、8°、20°、50°)以及各层功能设想("特征组合""构型敏感""视角依赖")。条目 2 与 3 中"感受野逐层扩大、顶层视角无关"的判断,正是建立在这个架构设计之上的。
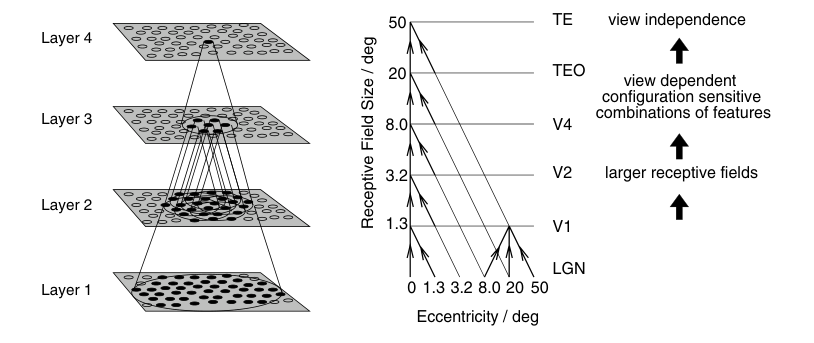
图 2 · 球面刺激的特征与位置编码
原文图注:Figure 2: Details of the 3-dimensional visual stimuli used in the rotation invariance experiments of section 3. Each stimulus is a sphere that is identified by its unique combination of two or three surface features. There are three possible types of features that take the form of (1) a vertical arc, (2) a diagonal arc, and (3) a horizontal arc and lie on the surfaces of the spheres (a blank space is denoted by 0). These three features can be placed in any of three relative positions A, B, and C, which are themselves separated by 15 degrees of arc.
读这张图先记住编码方案:三种弧线(竖、斜、横)编号 1、2、3,空位记 0,三个弧间隔 15 度的位置 A、B、C 依次对应一个三位数字,比如 102 就是"竖弧在 A 位、B 位空、斜弧在 C 位",由此得到 18 个两特征刺激(pairs)和 6 个三特征刺激(triples)。每个特征端点距球心约 10 度。理解了这个编号系统,后文所有结果里的"triple 132""六个 triples"才有意义。
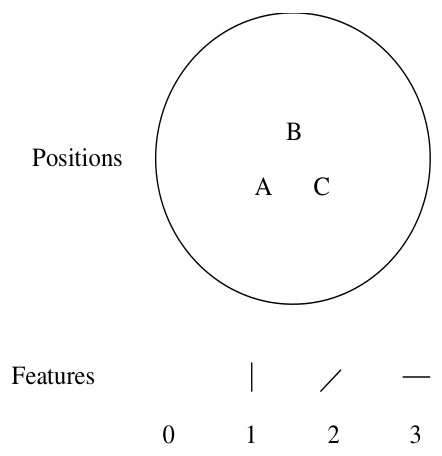
图 3 · 六个三元组刺激在五个旋转视角下的样子
原文图注:Figure 3: Representations of the six visual stimuli with three surface features (triples) presented to VisNet during the simulations. Each stimulus is a sphere that is identified by a unique combination of three surface features (a vertical, diagonal, and horizontal arc) that occur in three relative positions A, B, and C. Each row shows one of the stimuli rotated through the five different rotational views in which the stimulus is presented to VisNet. From left to right, the rotational views shown are −60 degrees, −30 degrees, 0 degree (central position), 30 degrees, and 60 degrees.
每一行是一个刺激(六个三元组之一),从左到右依次是 -60°、-30°、0°、30°、60° 五个深度旋转视角。这张图直观呈现了文章要解决的核心难题:同一物体转过哪怕几十度,球面上的弧线都会因透视关系发生典型的拉伸、倾斜与错位——没有灾难性的形状重排(球体保证),只有连续的度量变形。这组图正是正文中"表面标记的典型透视变换"所指的对象,也是对照实验里"真实 3D 变形"与"无变形平移"的分野所在。
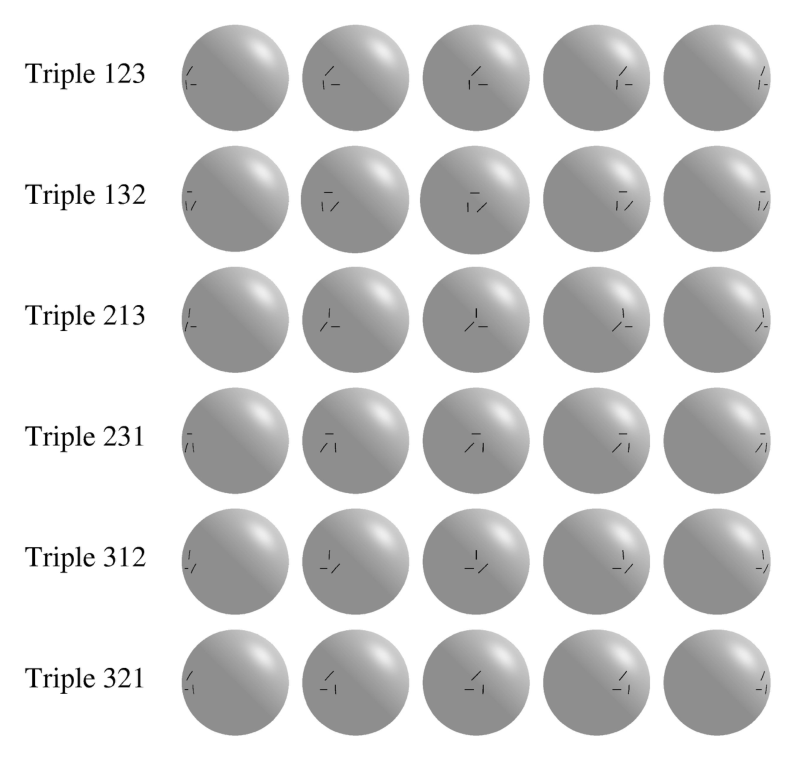
图 4 · 实验 1 与实验 2 的信息量对比
原文图注:Figure 4: Numerical results for experiments 1 and 2: (Left) Single cell information measures. (Right) Multiple cell information measures. There were six stimuli each shown in five rotational views (6s 5r). In experiment 1, the first two layers were trained on feature pairs in all transforms, and layers 3 and 4 were trained on the six triple stimuli in four of the five transforms. For comparison, experiment 2 shows the performance with no training.
左右两幅都是横轴排序后的第 4 层神经元、纵轴信息量(比特)的曲线,"6s 5r"表示 6 个刺激、5 个视角。实验 1:低两层用特征对全视角训练、高两层用三元组只训四个视角,结果是若干单细胞曲线顶到理论最大值 log2(6)≈2.6 比特,右侧多细胞信息量同样达到 2.6 比特——即群体层面完美判别。实验 2:权重保持随机初值不做训练,作为对照基线,信息量明显低。这组对比直接支撑主要结果第 1 条与第 4 条:部分视角的训练足以覆盖全部视角,且改为“相较于未训练的随机权重基线,训练后的网络表现更好,支持该外推能力依赖训练;原文未报告跨随机种子的稳健性统计”。
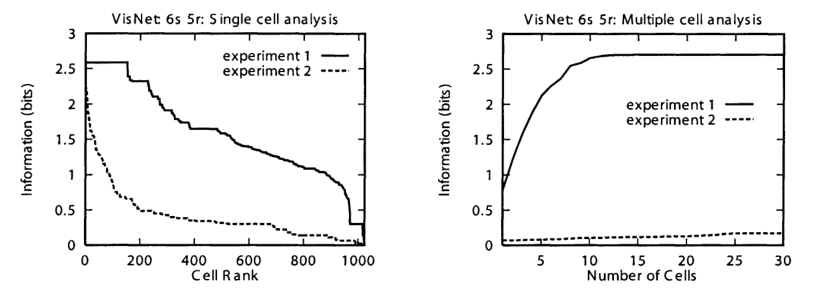
图 5 · 一个顶层神经元的响应谱
原文图注:Figure 5: Numerical results for experiment 1: Response profiles of a top-layer neuron to the 6 triples in all 5 orientations.
图 4 是群体统计,图 5 则把不变性落到单个细胞:横轴是 6 个三元组,每个三元组下给出 5 个朝向(-60° 到 60°)的响应。这个细胞对三元组 132 的五个朝向都给出最大且几乎相同的响应,对另外五个三元组响应都很低,且响应不随朝向系统变化。它只被喂过 132 的四个朝向,却在第五个未见过的朝向上不丢不掉乱——这正是"对 novel views 泛化"最直接的单细胞证据。看图时注意把"组内平坦"(无视角依赖)与"组间差异"(有刺激选择性)分开检验,两层条件同时满足才算不变。
讨论
作者把结论收敛为两点。第一,迹踪学习确实能形成对"通用视图内部"透视变形不变的神经元——由于用球体排除了边界曲率变化,这里学到的不变性可以明确归因于表面标记的变换规律,网络把"特征在 3D 物体表面如何随旋转变形"当作了可学习的知识。第二,对完整物体的每一种变换都做不变学习并非必要;不变性层次地承袭自低层对特征组合的学习,高层只需要少量呈现来建立连接权重,因此对"旧特征、新组合"的新物体,见过几个视角就能泛化到其余视角。作者特别对比了 Edelman(1999)的基组插值路线:那是把新物体表示为已训练物体表征的线性组合,只有新物体与旧物体相似时插值才有效;而 VisNet 方案只要求新物体由相似的底层特征构成,且与皮层的层级结构更贴近,泛化能力也更强。文中没有报告仿真方差、对 η 等参数的敏感性分析,也未讨论真实旋转速度下迹踪时间常数是否足够,这些局限文中未详述。
一句话总结
在我看来,这篇文章最漂亮的地方是把"不变性"从一个玄学口号拆成了可迁移的知识:低层学会的是特征如何变形,高层学的只是"怎么把变形过的特征拼起来",所以新组合的物体天生享受已学的不变性。当然这依赖球体这种没有灾难性视图变化的理想化刺激,跨通用视图的真正难点(比如杯子倾斜见底那种重排)只是被回避而非解决——但正因为问题被切得干净,结论才站得住。
审校与证据追溯 (Verification & Evidence)
图表审计结果
- Fig1: 提取质量
good,对齐度full,识别面板[] - Fig2: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig3: 提取质量
good,对齐度full,识别面板[A, B, C] - Fig4: 提取质量
good,对齐度full,识别面板[] - Fig5: 提取质量
good,对齐度full,识别面板[]
关键事实与局限性声明
- 审校纠偏: {'claim': 'VisNet结果“证明”了视觉系统通过该机制实现新视角识别。', 'classification': 'OVERCLAIM', 'reason': '模拟证明的是特定模型条件下的可行性或充分性,不是生物视觉系统采用该机制的直接证据。'} -> 评注:
- 审校纠偏: {'claim': '模型学到的是变形规律而不是任何形式的视角模板。', 'classification': 'OVERCLAIM', 'reason': '现有对照只排除了依靠无变形二维平移训练即可泛化的解释,没有穷尽其他表征机制。'} -> 评注:
- 审校纠偏: {'claim': '泛化来源已经被因果定位到低层。', 'classification': 'OVERCLAIM', 'reason': '结果与低层特征不变性解释一致,但缺少保持高层训练不变、仅消融低层预训练的关键对照。'} -> 评注:
- 审校纠偏: {'claim': 'VisNet比Edelman方案具有更强的泛化能力。', 'classification': 'INTERPRETATION', 'reason': '这是作者基于模型结构作出的理论比较,本文没有在匹配数据和评价指标下直接比较两个模型。'} -> 评注:
- 补充要点: 应更明确说明这是一项纯计算模拟研究,没有动物数量、行为数据、电生理记录或真实IT神经元样本;文中的“神经元”和“细胞”均指VisNet模型单元。
- 补充要点: 应明确区分模型层与脑区的功能类比:四层分别被设定为对应V2、V4、TEO和TE,但研究没有直接测量这些脑区。
- 补充要点: 原文未报告独立模拟次数、随机种子、误差范围或统计显著性,因此“完美判别”仅描述所报告模拟条件下信息量达到理论上限。
- 补充要点: 未变形刺激对照的负结果仅作定性报告,原文没有提供相应图、具体信息量数值或统计比较。